Leugens herkennen: wat zegt een blik eigenlijk?
Wat onderzoek naar oogbewegingen, knipperen en micro-expressies laat zien, en waarom een hoog percentage nog niets zegt over één verdacht antwoord.
Leugens herkennen wordt vaak voorgesteld als goed kijken: iemand wendt de ogen af, aarzelt en verandert een woord. Maar stel dat je een alibi wilt controleren. Welk van die bewegingen vertelt je waar die persoon werkelijk was? Om daarachter te komen, moet je de uitspraak verbinden met informatie buiten het filmpje. Onderzoek naar gedrag kan interessante vragen opleveren, zolang je weet welke vraag het heeft getest.
TL;DR
Een blik, pauze of micro-expressie bewijst op zichzelf geen leugen. Sommige experimenten vinden verschillen tussen groepen, maar onder specifieke omstandigheden. Kijkrichting, knipperen en metingen met een oogtracker zijn verschillende onderzoeken. Bij micro-expressies verandert een andere tijdgrens welke bewegingen meetellen. Begin bij een controleerbare uitspraak en vraag daarna wat een meting eraan toevoegt.
Wat wil je precies controleren?
Neem een verzonnen voorbeeld: iemand zegt op een bepaald tijdstip naar huis te zijn gefietst. Een opname lijkt een ander tijdstip te tonen. Je moet eerst weten of de cameraklok klopt en of de opname dezelfde rit laat zien. Pas dan heb je een bruikbare vergelijking met de uitspraak.
Een verkeerde tijd is bovendien niet automatisch een bewuste leugen. Een herinneringsfout of verwarring tussen twee ritten kan dezelfde afwijking opleveren. Om van een onjuist antwoord naar opzettelijke misleiding te gaan, heb je aanvullende informatie nodig.
Bij true crime weet je als kijker vaak meer dan de mensen in de oorspronkelijke opname. De montage laat een aarzelend antwoord zien en onthult daarna een belastend gegeven. Achteraf lijkt de aarzeling vanzelfsprekend verdacht. Dat zegt nog niet welke inschatting je zonder die onthulling zou hebben gemaakt.
Waar komt een betrouwbare vergelijking vandaan?
Een experiment kan deelnemers opdracht geven te liegen of de waarheid te vertellen. De onderzoeker heeft dan een bekend antwoord waarmee beoordelingen te vergelijken zijn. In een online interview ontbreekt die opdracht. Een vermoeden van de kijker mag niet tegelijk dienen als bewijs dat de herkenningsmethode werkt.
Bond en DePaulo brachten in hun meta-analyse uit 2006 de resultaten van 206 documenten en 24.483 beoordelaars samen. Zonder bijzondere hulpmiddelen of training was de gemiddelde nauwkeurigheid 54%. Leugens werden voor 47% en waarheden voor 61% correct herkend. De gemiddelde voorsprong bestond, maar er bleven veel fouten.
Bij een taak met evenveel waarheden als leugens ligt toeval op 50%. Vier procentpunten daarboven geven weinig zekerheid over één persoon. De 54% is ook niet jouw persoonlijke kans om een verdachte uitspraak goed te beoordelen.
Bij onderzoek naar een true-crime-zaak moet het onafhankelijke gegeven passen bij de uitspraak. In het fietsvoorbeeld kan een verkeerde cameraklok het hele vermoeden veranderen. Alleen de blik van de spreker opnieuw bekijken lost dat probleem niet op.
Betekent naar links of rechts kijken dat iemand liegt?
Een bekende regel uit neurolinguïstisch programmeren, NLP, verbindt omhoog kijken naar een kant met herinneren en naar de andere met verzinnen. Links en rechts zijn daarbij doorgaans die van de spreker. Een camera kan de perspectieven verwarrend maken, maar zelfs een duidelijke uitleg maakt de regel niet betrouwbaar.
Wiseman en collega’s onderzochten de kijkregel in 2012 met drie studies: 32 rechtshandige geïnterviewden, 50 beoordelaars en 52 video’s met openbare oproepen. Het voorspelde kijkpatroon werd niet bevestigd. Het uitleggen van de regel verbeterde de nauwkeurigheid van de beoordelaars evenmin. Daarmee onderzochten ze een specifieke bewering over richting, niet elke mogelijke oogmeting.
Leal en Vrij bestudeerden in 2008 het knipperen van 13 deelnemers met een leugenopdracht en 13 met een waarheidsopdracht. Vergeleken met hun waarheidsgetrouwe uitgangsperioden knipperde de leugengroep minder tijdens het onderzochte antwoord en meer vlak erna. Wanneer je telt, hoort dus bij de uitkomst. Een los fragment kan de benodigde vergelijking missen.
Walczyk en collega’s gebruikten in 2012 bij 145 mensen een infrarood-oogtracker samen met antwoordtijd en consistentie tussen antwoorden. De deelnemers beantwoordden vragen over misdaadvideo’s met waarheid, voorbereide leugens of onvoorbereide leugens. Met gecombineerde maten rapporteerden de onderzoekers tot 69% correcte indelingen in die drie groepen. Het was geen score van de ogen alleen.
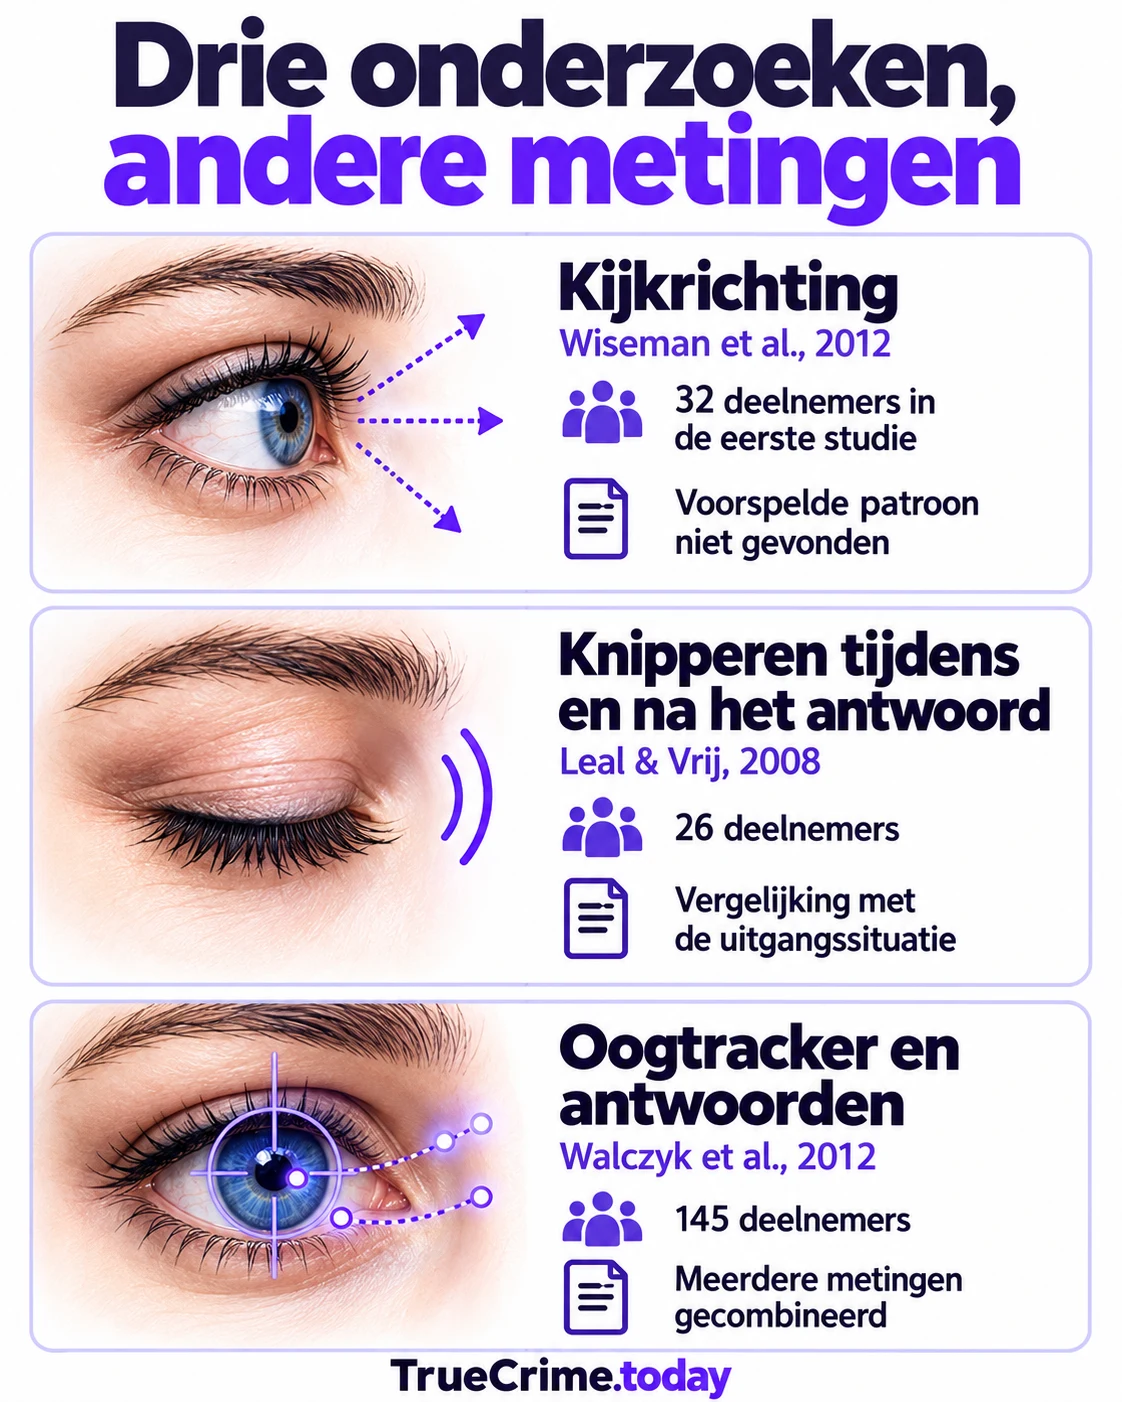
Die bevindingen passen naast elkaar. Het falen van een richtingsregel sluit een verschil in knipperen onder een bepaalde taak niet uit. Andersom maakt een gecombineerd laboratoriumresultaat een gewone video nog geen test. Vraag of de methode die iemand jou aanbiedt zelf is onderzocht, met dezelfde hulpmiddelen en omstandigheden.
Kun je een leugen zien in een micro-expressie?
Het Facial Action Coding System, FACS, beschrijft acties van gezichtsspieren. Een beweging herkennen is een andere stap dan een emotie benoemen. Die emotie aan een leugen koppelen vraagt opnieuw bewijs. Angst om niet geloofd te worden kan immers ook voorkomen bij een waar antwoord.
In het onderzoek van Matsumoto en Hwang uit 2018 met 77 mensen onderscheidden negatieve uitdrukkingen van 40–200 milliseconden de waarheids- en leugengroepen niet. Ruimere grenzen leverden wel verschillen op. Tot 400 milliseconden waren de gemiddelde aantallen nul en 0,35, respectievelijk. Het ging om het verbergen van een intentie bij een gesimuleerd misdrijf, en om aantallen uitdrukkingen, niet om trefpercentages.
Porter en ten Brinke onderzochten in 2008 het tonen en verbergen van emoties. Ze analyseerden 697 gezichtsuitdrukkingen over 104.550 videobeelden. Micro-expressies kwamen voor in 2% van de uitdrukkingen en bij 21,95% van de deelnemers. De eerste verhouding telt uitdrukkingen, de tweede mensen. Geen van beide vertelt hoeveel leugens correct werden herkend.
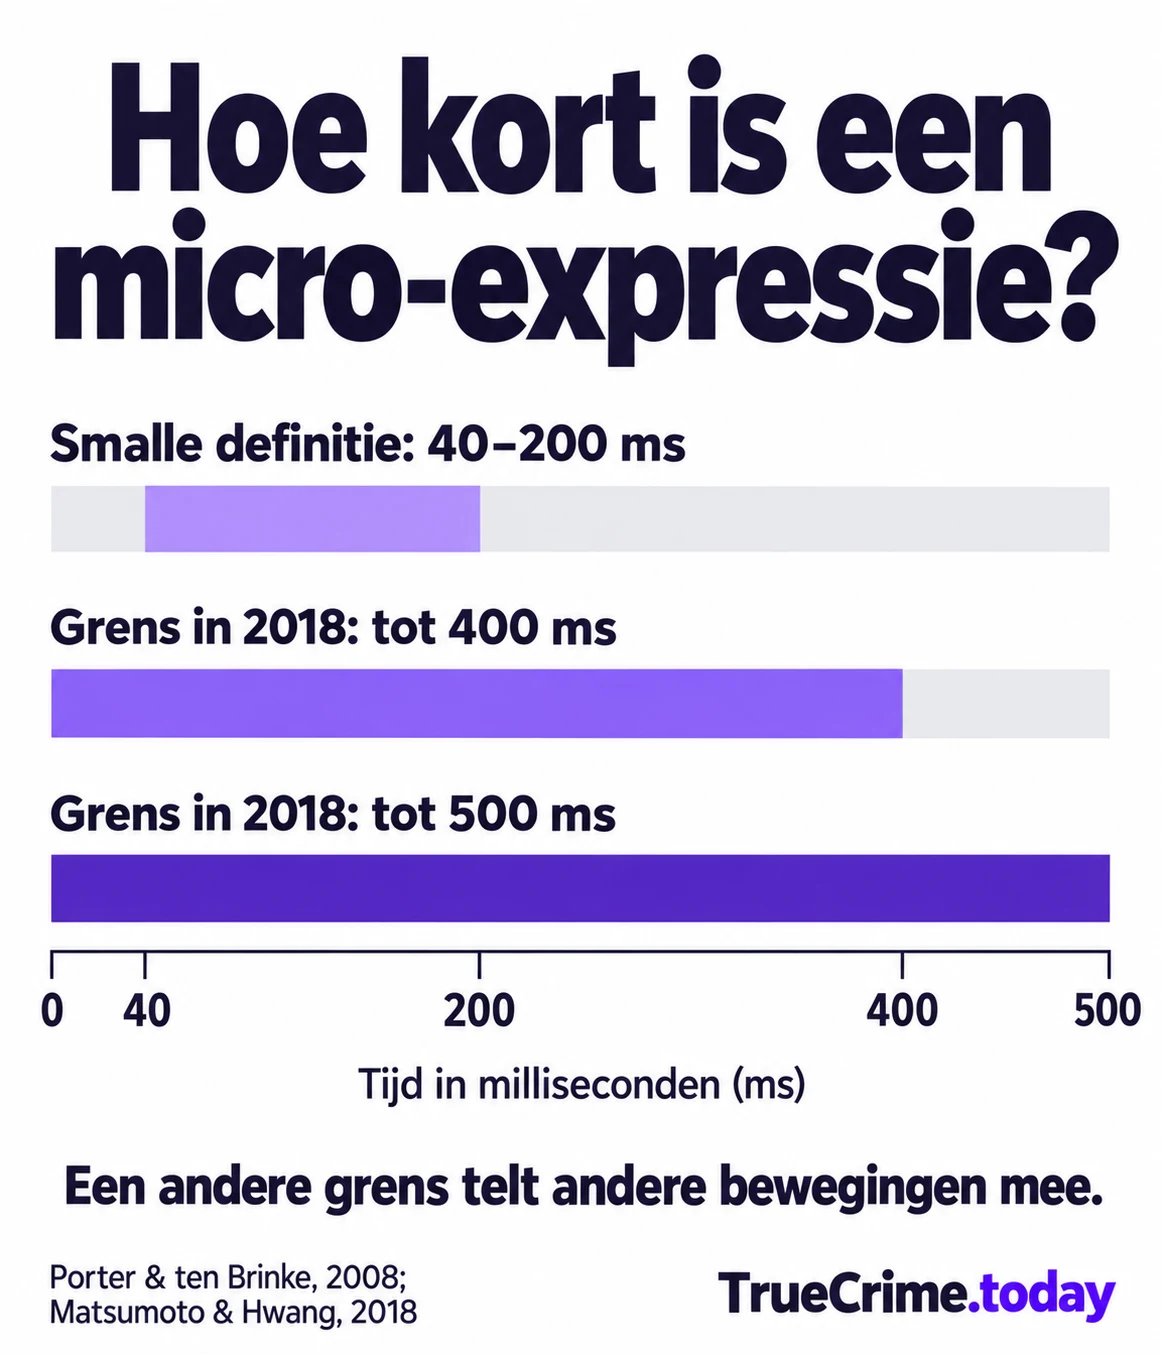
Een uitdrukking van 350 milliseconden valt buiten de smalle definitie, maar binnen beide ruimere grenzen. Dat verandert de verzameling gebeurtenissen die je analyseert. Ook het tonen van emoties en het verbergen van een intentie zijn andere opdrachten. De zeldzame korte uitdrukkingen en de verschillen bij een ruimer venster moeten daarom met hun omstandigheden worden besproken.
Waarom zegt een hoge score weinig over één waarschuwing?
We kunnen het verschil zichtbaar maken met een verzonnen test, niet met de prestaties van een bestaand product. Neem 200 uitspraken: twintig leugens en 180 waarheden. Stel dat de test zestien leugens vindt en vier mist. Van de waarheden markeert hij er achttien ten onrechte en laat hij er 162 terecht doorgaan.
Dan zijn 178 van de 200 beslissingen correct, oftewel 89%. Maar van de 34 waarschuwingen zijn er achttien onterecht. Slechts 16 ÷ 34, ongeveer 47%, wijzen op een echte leugen. Een hoge totaalscore en de kans dat een waarschuwing klopt zijn verschillende zaken.
Deze uitkomst hangt mede af van de gekozen verhouding tussen waarheid en leugen. Met een andere verhouding verandert de betekenis van een melding, ook als de test dezelfde eigenschappen houdt. Die verhouding ken je meestal niet in een willekeurige verzameling interviews.
Voor iemand die onterecht wordt verdacht, is het aantal correct doorgelaten waarheden geen oplossing. Vraag daarom afzonderlijk naar gemiste leugens en ten onrechte verdachte waarheden. Dat voorkomt dat de grootste reclamewaarde het relevante risico verstopt.
Maken lastige vragen het verschil groter?
Een gesprek kan informatie opleveren die je later kunt controleren. Dat kan nuttiger zijn dan passief naar zenuwachtig gedrag zoeken. Moeilijker antwoorden hoeft echter niet te betekenen dat iemand iets verzint. Een echte herinnering ophalen of een ingewikkelde vraag begrijpen kan ook moeite kosten.
Mac Giolla en Luke rapporteerden in hun meta-analyse uit 2021 naar cognitieve interviewbenaderingen een totale beoordelaarsnauwkeurigheid van 60%. Na correctie voor publicatiebias daalde die naar ongeveer 55%, met een gecorrigeerd 95%-betrouwbaarheidsinterval van 48,83% tot 61,16%. Verschillende taken en kennis van de beoordelaars beperkten een algemene succesbelofte.
Verschuere en collega’s verzamelden in 2018 ook 21 reactietijdstudies met 792 deelnemers. Extra cognitieve belasting verkleinde het tijdverschil tussen waarheid en leugen. Dat resultaat gaat over die reactietijdtaken, niet over iedere vorm van interviewen.
In het fietsvoorbeeld kan een vraag naar de gevolgde weg een nieuwe mogelijkheid tot controle geven. Een langere pauze na een moeilijke vraag geeft die controle niet. Het helpt om de waarde van de verkregen informatie te onderscheiden van de moeite waarmee iemand antwoordt.
Is iemands gewone gedrag een goede uitgangsmeting?
Een vergelijking met dezelfde persoon kan nuttig zijn, maar alleen als je begrijpt welke omstandigheden veranderen. Praten over een favoriete maaltijd en antwoorden op een beschuldiging verschillen in onderwerp, spanning en mogelijke gevolgen. Een gedragsverandering kan met elk daarvan samenhangen.
Een betere vergelijking zou vergelijkbare vragen en onafhankelijk vastgestelde ware antwoorden gebruiken. Ook daarna moet je onderzoeken welke verandering waarheid en leugen daadwerkelijk onderscheidt. Een oude opname alleen maakt de vergelijking nog niet geldig.
Pas bovendien op met het optellen van tekenen. Een pauze, een afgewende blik en een gespannen stem kunnen uit één moeilijke situatie voortkomen. Ze als onafhankelijke bevestigingen tellen kan je vertrouwen vergroten zonder evenveel informatie toe te voegen.
Kunnen een cursus, polygraaf of algoritme het wel?
Een cursus kan je beter maken in het benoemen van gezichtsuitdrukkingen. Voor de belofte van betere leugendetectie moet juist die andere vaardigheid worden getest, met bekende waarheid en geregistreerde fouten. De oorzaak van een herkende emotie blijft een afzonderlijke vraag.
Een polygraaf registreert lichamelijke reacties. De interpretatie hangt af van de vragen en werkwijze; het apparaat ziet de besproken gebeurtenis niet. De beoordeling van de National Research Council uit 2003 benoemde belangrijke beperkingen, vooral voor screening.
Een algoritme kan patronen in gezicht, stem of woorden gebruiken. Vraag of de testpersonen nieuw waren en of hun antwoorden onafhankelijk als waar of onwaar waren vastgesteld. Leren van menselijke verdenkingen kan een model goed maken in het herhalen van die verdenkingen, zonder de waarheid te bepalen.
Wat kun je na het kijken verantwoord bespreken?
Kies één concrete uitspraak en bewaar de volledige vraag erbij. Controleer onafhankelijke informatie en vermeld ontbrekende stukken van de opname. Je kunt dan zeggen welke gegevens elkaar tegenspreken, zonder te doen alsof je de bedoeling van de spreker al kent.
We hebben de besproken onderzoeken voor het laatst gecontroleerd op 8 oktober 2026. Bij een nieuwe doorbraakclaim blijven dezelfde vragen bruikbaar: wat is getest, welke fouten kwamen voor en werkte het ook bij nieuwe mensen? Daarmee blijft je nieuwsgierigheid verbonden met iets dat werkelijk te controleren is.
Wil je een bewering over leugendetectie bespreken? Stuur het openbare onderzoek of filmpje en de precieze uitspraak. Deel geen privéberichten of persoonlijke documenten.
Een bewering bespreken