Wie gut funktioniert Lügenerkennung? So prüfst du die Forschung
Was Trefferquoten wirklich aussagen: bekannte Wahrheiten, Fehlalarme, neue Testpersonen und die Grenzen von KI und Befragungsstudien.
TL;DR
Ob wissenschaftliche Lügenerkennung funktioniert, hängt davon ab, welche Aufgabe geprüft wurde. Ein Modell kann bekannte Aufnahmen gut sortieren und bei unbekannten Personen scheitern. Eine hohe Gesamtquote kann außerdem viele falsche Warnungen verbergen.
Wenn du ein Urteil über ein Interview beurteilen willst, brauchst du deshalb den Versuchsaufbau neben der Zahl: Woher war die Wahrheit bekannt? Welche Fehler wurden gezählt? Was geschah mit unklaren Fällen? Die folgenden Rechenbeispiele sind erfunden; sie erklären die Begriffe und bewerten kein konkretes Produkt.
Die Zahl neben dem KI-Urteil
Auf dem Bildschirm steht ein genauer Wert. Daneben bezeichnet ein Programm die Antwort einer Person als unwahr. Gerade die scheinbare Genauigkeit macht den Eindruck stark: Es sieht nach Messung aus, während ein menschlicher Verdacht nur wie eine Meinung wirkt.
In ihrer Warnung vom Mai 2024 zu KI-Lügenerkennung beschreiben Suchotzki und Gamer über die Universität Würzburg Probleme bei Variablenauswahl, kleinen oder wenig repräsentativen Datensätzen und der Annahme eindeutiger Täuschungsmerkmale. Forschungsnutzen und praktischer Einsatz sind für sie getrennte Fragen. Die Mitteilung ist kein neuer Genauigkeitstest.
Für Lügenerkennung bleibt daher zuerst zu klären, was hinter dem Wert steht. Eine Schätzung von Anspannung ist keine Prüfung einer Zahlung oder eines Aufenthalts. Die hier besprochenen Quellen haben wir zuletzt am 20. Oktober 2026 kontrolliert.
Was das Modell überhaupt unterscheiden soll
Ein System kann Gesichtsausdrücke, bekannte Informationen oder den Eindruck von Glaubwürdigkeit unterscheiden. Das kann für die jeweilige Forschung sinnvoll sein. Es beantwortet nicht automatisch, ob ein bestimmter Satz absichtlich falsch ist.
Stell dir vor, die Aufgabe lautet, lächelnde von nicht lächelnden Bildern zu trennen. Selbst ein fehlerfreies Ergebnis würde nicht zeigen, ob ein lächelnder Mensch einen Termin verheimlicht. Die richtige Beschreibung des Gesichts und die Wahrheit des Termins sind verschiedene Zielgrößen.
Bei einer Fallanalyse muss die Prüfung zur strittigen Behauptung passen. Wenn der Streit eine Übergabe betrifft, sind Gegenstand, Zeitpunkt und beteiligte Personen relevant. Ein Hinweis auf eine mögliche Emotion kann weitere Fragen auslösen; die Übergabe belegt er nicht.
Ein Test mit unbekannten Personen
Für ein Versprechen über neue Menschen muss die Auswertung Menschen tatsächlich neu vorfinden. Andere Dateien allein reichen nicht. Mehrere Ausschnitte derselben Stimme können stabile Merkmale enthalten, die das Modell schon kennt.
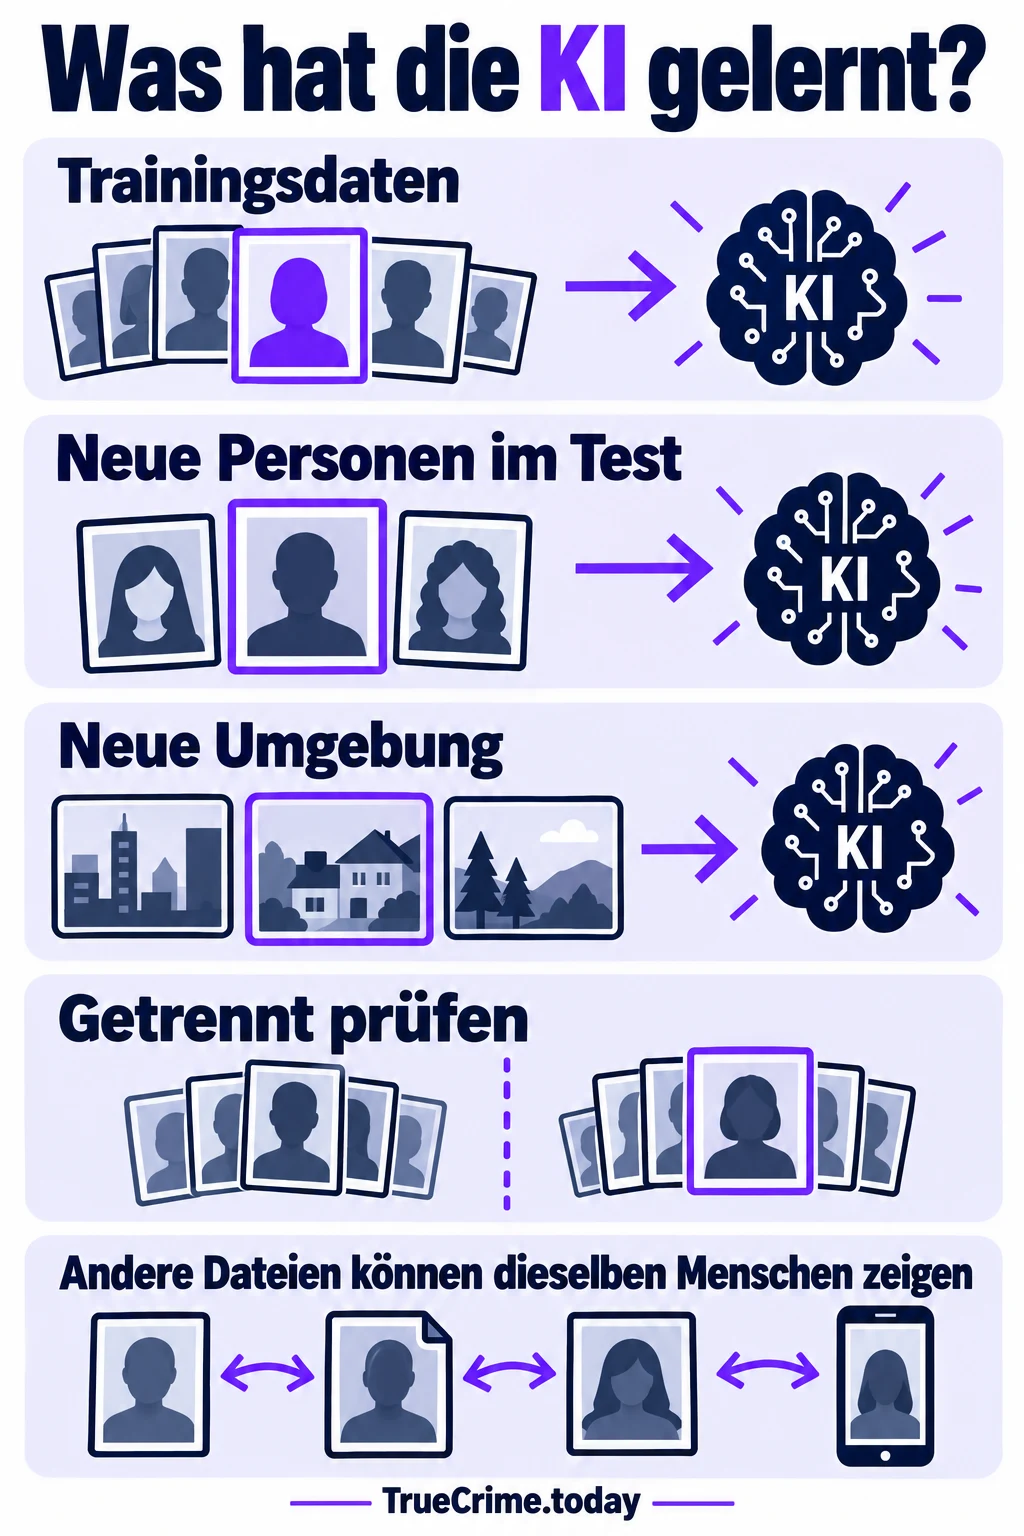
Auch Mikrofone, Räume oder Aufnahmezeiten können unbeabsichtigt mit den Etiketten zusammenhängen. Ein Modell könnte daran die Gruppen unterscheiden, ohne das behauptete Verhalten erfasst zu haben. Das ist eine Möglichkeit, die der Aufbau ausschließen soll, keine pauschale Unterstellung gegen eine bestimmte Untersuchung.
Frage deshalb nach der Trennung von Personen, nicht nur nach der Menge der Aufnahmen. Soll das System in einer anderen Umgebung funktionieren, muss auch diese Übertragung untersucht werden. Tausend Ausschnitte einer Sitzung ergeben nicht tausend unabhängige Lebenssituationen.
Wer kennt im Versuch die richtige Antwort?
Der Überblick von Bond und DePaulo aus dem Jahr 2006 berichtet rund 54% richtige Urteile bei Personen ohne spezielle Schulung oder Hilfsmittel. Diese Zahl beschreibt die untersuchten Aufgaben. Sie ist keine Obergrenze jeder Ermittlung.
Damit eine richtige Antwort gezählt werden kann, muss sie zunächst bekannt sein. In einem Versuch können einige Personen einen Gegenstand nehmen und andere ihn liegen lassen. Die Versuchsleitung kennt den Auftrag und vergleicht die Urteile damit. Das ist kontrollierbar, aber eine andere Lage als eine wirkliche Anschuldigung.
Bei autobiografischen Geschichten ist zu klären, wie deren Herkunft geprüft wurde. Eine Bestätigung durch die erzählende Person, ein unabhängiger Beleg und die Beobachtung des Ereignisses bieten verschiedene Grundlagen. Wird ein verdächtiger Eindruck selbst zum Wahrheitsmaßstab, kann ein Test bloß diesen Eindruck reproduzieren.
Warum ein genauer Eindruck noch kein Treffer ist
Du kannst eine Geschichte sehr glaubwürdig finden und sie trotzdem falsch einordnen. Eine Bewertung auf einer Skala misst zunächst ein Urteil über Glaubwürdigkeit. Für die Entscheidung „wahr oder gelogen“ braucht es einen festgelegten Übergang von dieser Skala zur Auswahl.
Angenommen, ein wahrer Bericht erhält sieben Punkte und ein erfundener sechs. Werden beide als wahr eingestuft, ist die Erfindung unentdeckt. Ein kleiner Unterschied in den Punkten darf nicht als erfolgreicher Nachweis dieser Erfindung berichtet werden.
Auch eine Beziehung zwischen einem Merkmal und Verdachtsurteilen ist noch keine Beziehung zur tatsächlichen Täuschung. Vielleicht erklärt das Merkmal, weshalb Beobachtende häufig denselben Fehler machen. Die unabhängige Prüfung verhindert, dass eine geteilte Überzeugung als Beweis gilt.
Befragung und Beobachtung sind verschiedene Aufgaben
Wer einen fertigen Clip betrachtet, kann keine neue Antwort mehr bekommen. In einer Befragung lässt sich dagegen nach einem überprüfbaren Detail fragen. Dadurch verändert sich das Material, das später beurteilt wird.
Mac Giolla und Luke berichteten 2021 für kognitive Befragungsansätze im Mittel 60% Genauigkeit, nach einer Bias-Korrektur etwa 55%. Das korrigierte 95%-Intervall von 48,83–61,16% schloss Zufallsniveau ein. Informierte Beobachtende erreichten 75,81%, nicht informierte 52,37%. Unterschiedliche Studienergebnisse, Publikationsbias und offene Praxisfragen begrenzen die Übertragung.
Der günstigere Teil des Ergebnisses verdient Beachtung. Er erlaubt aber kein Versprechen, wonach Druck oder eine schwierige Frage jede Lüge sichtbar machen. Die Art der Befragung und die Anweisung an die Auswertenden gehören zum Ergebnis dazu. Ohne sie wird aus einem definierten Versuch ein viel weiteres Versprechen.
80 richtige Warnungen, 90 falsche
Nehmen wir 1 000 erfundene Aussagen: 100 falsch, 900 wahr. Ein hypothetischer Test erkennt 80% der falschen und entlastet 90% der wahren korrekt. Wir wählen diese Werte für die Rechnung; sie stammen nicht aus einem getesteten Gerät.
Er findet 80 falsche Aussagen und übersieht zwanzig. Von den 900 wahren lässt er 810 richtig unmarkiert, markiert aber 90 fälschlich. Es gibt insgesamt 170 Warnungen, davon 80 ÷ 170, rund 47,1%, berechtigte.
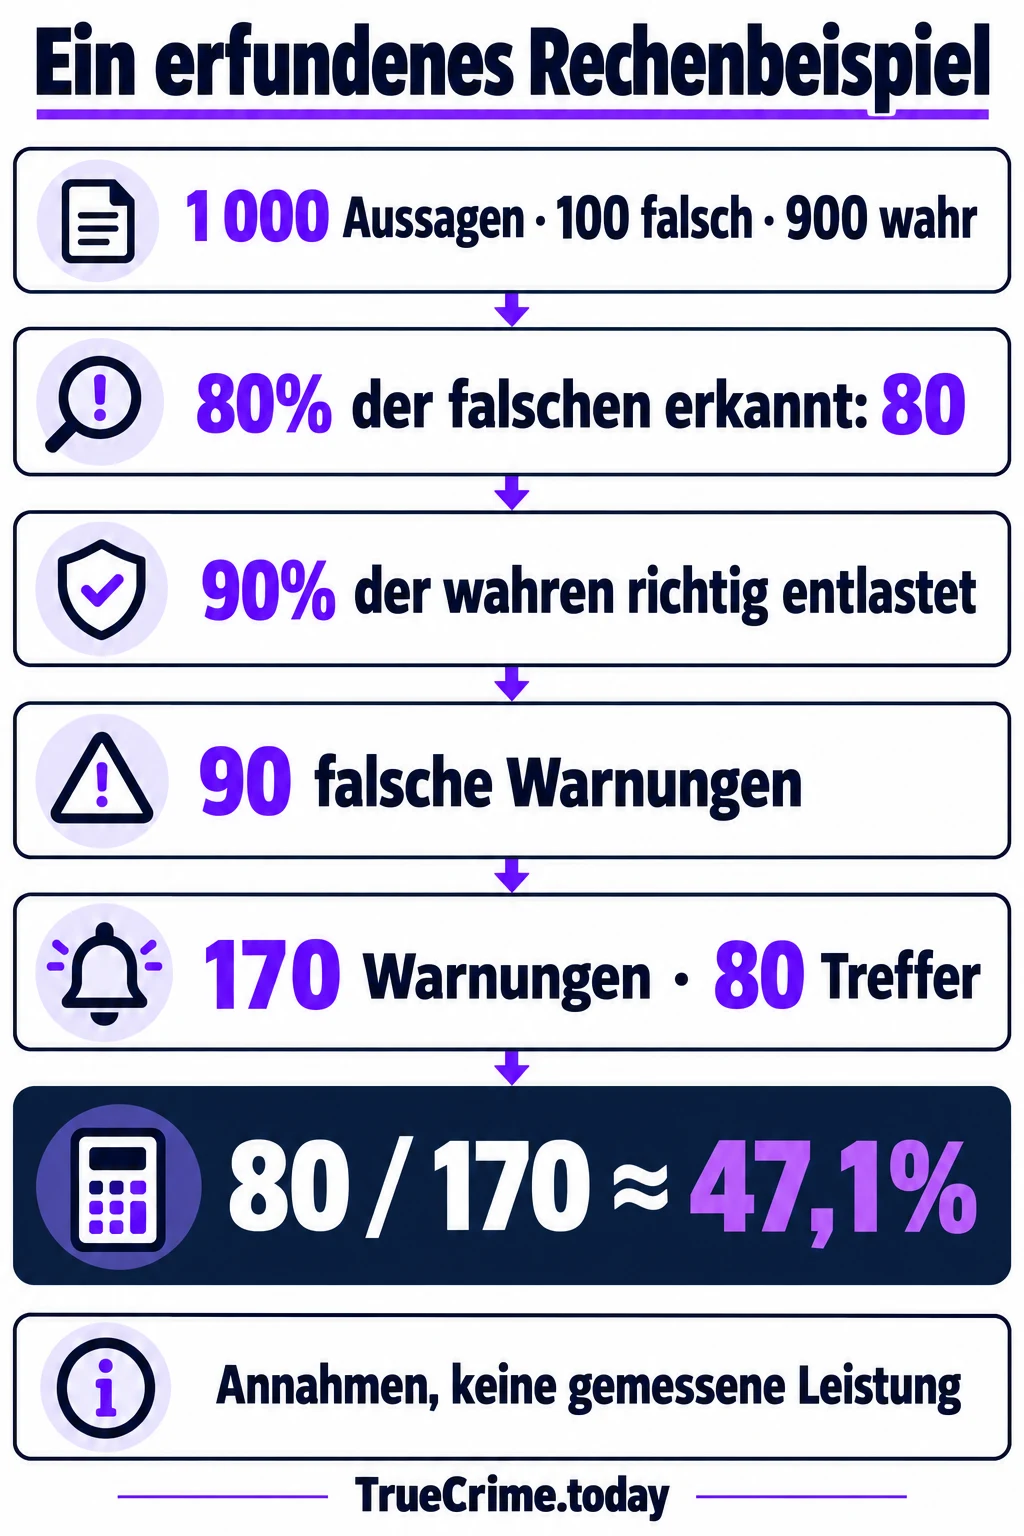
Die Gesamtgenauigkeit beträgt dennoch (80 + 810) ÷ 1 000 = 89%. Beides kann gleichzeitig stimmen. Die erste Quote betrachtet nur die Warnungen, die zweite alle Entscheidungen. Ändert sich die Zusammensetzung der Aussagen, ändert sich auch der Anteil berechtigter Warnungen. Die Rechnung liefert keine Wahrscheinlichkeit für eine wirkliche Person.
Was die beiden Fehlerquoten bedeuten
Sensitivität fragt, welcher Anteil der falschen Aussagen entdeckt wurde. Spezifität fragt, welcher Anteil der wahren richtig unverdächtig blieb. Die Nenner unterscheiden sich. Eine gute Quote in der einen Gruppe sagt die andere nicht voraus.
Eine niedrigere Schwelle für einen Verdacht kann mehr Täuschungen finden und zugleich mehr Wahrheiten belasten. Daher solltest du beide Fehler sehen. Ein zusammengefasster Wert kann den Tausch verdecken.
Dasselbe gilt für unentschiedene Fälle. Eine Methode darf Unsicherheit zulassen. Werden diese Fälle aus dem Endergebnis entfernt, muss ihre Zahl genannt werden. Die Genauigkeit der verbleibenden Antworten sagt nicht, wie oft überhaupt eine Antwort möglich war.
Ein Mittelwert entscheidet keinen Einzelfall
Zwei gedachte Gruppen haben die Werte 1, 2, 3 beziehungsweise 2, 3, 4. Die Mittelwerte unterscheiden sich, die Werte 2 und 3 kommen aber in beiden Gruppen vor. Eine Person mit dem Wert 3 ist dadurch nicht eindeutig zuzuordnen.
Ein echter Gruppenunterschied kann wissenschaftlich nützlich sein. Für die individuelle Entscheidung braucht es eine Regel und eine Prüfung der Fehler auf neuem Material. Der Unterschied selbst enthält diese Prüfung nicht.
Auch ein Zusammenhang beweist nicht seine Ursache. Ein Verhalten kann von Erinnerung, Aufgabenverständnis oder Situation abhängen. Wenn die Erklärung auf Täuschung hinausläuft, muss untersucht werden, ob andere Erklärungen ausreichend ausgeschlossen wurden. Die Plausibilität der Geschichte ersetzt den Vergleich nicht.
Wenn nur das beste Ergebnis sichtbar bleibt
Luke zeigte 2019 anhand von Analysen und Simulationen, wie kleine Stichproben, seltene Wiederholungen und selektive Berichterstattung Täuschungsmerkmale überschätzen können. Das beweist nicht, dass alle Effekte null sind.
Wer viele Kombinationen ausprobiert und nur den besten Treffer präsentiert, zeigt den Leserinnen und Lesern nicht die Zahl der Gelegenheiten für Zufallserfolge. Eine vorher festgelegte Auswertung und eine neue Stichprobe können diese Unsicherheit besser prüfbar machen.
Reale Aussagen mischen außerdem oft wahre Hintergründe mit einem verborgenen Detail. Menschen können sich vorbereiten oder nicht kooperieren. Solche Bedingungen müssen getestet werden. Eine Vermutung, dass die Praxis schwieriger sei, ist noch keine gemessene Fehlerquote für die Praxis.
Die abgesagte Raumbuchung
In einem erfundenen Verein streiten Mitglieder darüber, ob ein Probenraum rechtzeitig abbestellt wurde. Eine Person nennt Freitag, das System zeigt Montag. Die Antwort klingt sicher; ein Programm hält sie für unwahr.
Zuerst ist zu prüfen, welches Ereignis das System datiert: abgesendete Nachricht, Eingang beim Anbieter oder Bearbeitung der Stornierung. Auch die Buchungsnummer muss passen. Vielleicht betreffen zwei Unterlagen verschiedene Termine.
Ein Widerspruch zwischen Unterlagen kann wichtig sein, unabhängig vom Gesichtsausdruck. Ob eine Person sich irrte oder bewusst täuschte, braucht eine weitere Prüfung. Die Warnung eines Systems nennt weder automatisch das richtige Datum noch die Absicht hinter einer falschen Angabe.
Welche Belege vor einem Einsatz fehlen
Lass dir die Aufgabe, den bekannten Wahrheitsmaßstab, beide Fehlerquoten und die unentschiedenen Fälle zusammen zeigen. Frage danach, ob fremde Personen, neue Aufnahmen und eine unabhängige Wiederholung geprüft wurden.
Forschung muss nicht perfekt sein, um etwas beizutragen. Ihr Beitrag sollte aber so eng beschrieben werden, wie die Daten es zulassen. Für eine Anschuldigung reicht weder ein präzise wirkender Bildschirmwert noch die Behauptung, das Verfahren sei wissenschaftlich.
Du kannst nach einer Trefferquote oder einer Forschungsmethode fragen. Schicke keine privaten Aufnahmen oder persönlichen Dokumente.
Frage zur Forschung stellen