Peut-on détecter le mensonge ? Ce que les études vérifient
Une voix convaincante, un score élevé, une vraie preuve : comment distinguer les impressions, les bonnes réponses et les erreurs d’un test.
TL;DR
La détection scientifique du mensonge consiste à tester une méthode, pas à deviner une intention à partir d’une impression. Tu dois savoir quelle réponse était connue, ce qui comptait comme une réussite et combien de personnes sincères ont été soupçonnées à tort.
Certains résultats sont encourageants. Ils ne donnent pas pour autant un pourcentage valable pour toutes les conversations. Nous allons suivre le chemin entre une voix qui inspire confiance, une réponse correctement classée et une preuve sur un fait précis. Les calculs proposés sont fictifs et leurs hypothèses sont explicites.
Une voix peut convaincre sans prouver
Quelqu’un dit « bonjour » et sa voix te semble chaleureuse. Tu pourrais avoir envie de lui faire confiance avant même de savoir quoi que ce soit de son histoire. Cette impression mérite d’être étudiée, mais elle ne confirme aucun événement.
La présentation du CNRS de mars 2018 sur l’intonation du mot « bonjour » explique un travail sur les jugements sociaux transmis par la prosodie, notamment la confiance et la dominance. Elle ne décrit pas un test qui vérifie la vérité des récits. Aucun taux de détection des mensonges n’en découle.
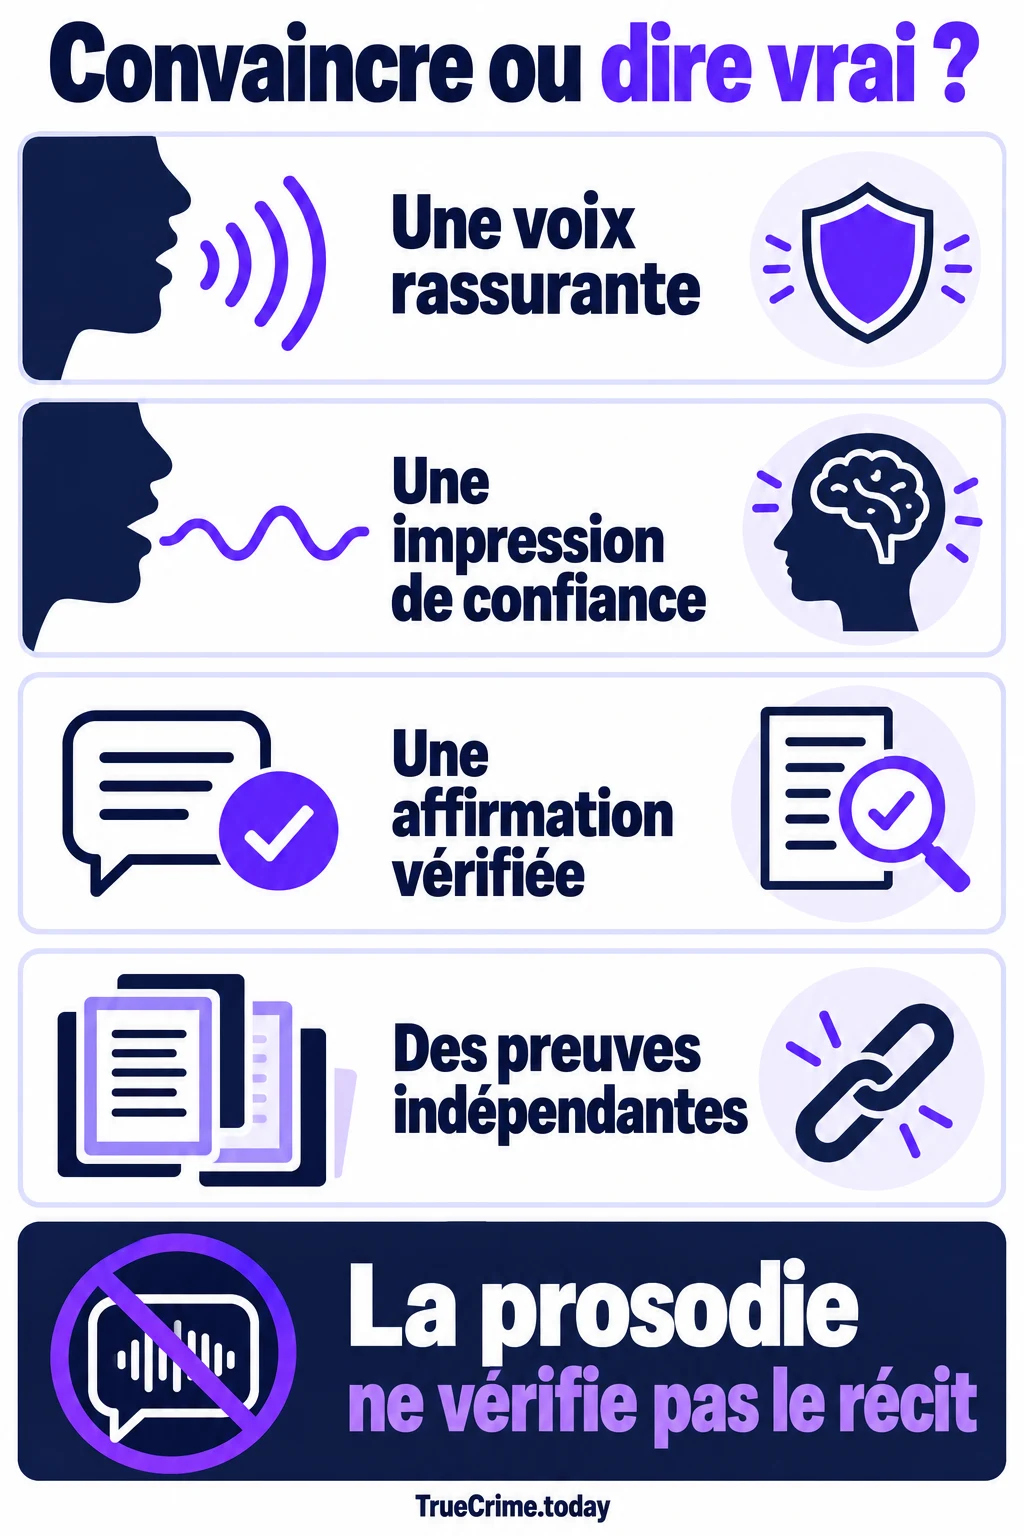
Pour la détection du mensonge, le piège est de passer de « cette personne paraît fiable » à « ce qu’elle affirme est établi ». La voix explique parfois notre confiance. Le fait raconté réclame toujours sa propre vérification. Nous avons contrôlé ces sources pour la dernière fois le 20 octobre 2026.
La question posée change le résultat
Avant de regarder le score, demande ce que l’expérience cherchait à distinguer. Une émotion demandée, un souvenir reconnu, une histoire jugée convaincante et une affirmation fausse sont des réponses différentes.
Imagine un programme qui reconnaît parfaitement les sourires sur les images utilisées pour le tester. Rien dans ce résultat ne permet de dater un virement. Le programme peut avoir accompli sa tâche tout en étant incapable de répondre à la question qui t’intéresse.
Dans une analyse d’affaire criminelle, il faut donc garder la proposition précise à vérifier. Une observation sur le ton peut suggérer une question. Elle ne remplace pas un message, une trace ou un témoignage indépendant concernant l’événement. Employer le même mot « exactitude » pour ces tâches ne les rend pas équivalentes.
Comment établir la vérité avant de tester
Dans un laboratoire, on peut demander à certaines personnes de prendre un objet et à d’autres de ne pas le toucher. L’équipe connaît les consignes. Elle dispose d’une réponse de référence pour noter les jugements.
Une histoire autobiographique pose une autre difficulté. A-t-on confirmé son origine par un proche, par un document ou seulement par la déclaration de la personne qui la raconte ? Il faut connaître cette procédure avant d’interpréter les bonnes réponses.
Si la fausseté est décidée parce qu’un récit semble suspect, puis que ce même soupçon valide la méthode, le raisonnement tourne en rond. On peut avoir reproduit une opinion plutôt que découvert la vérité. Cela ne condamne pas toute recherche ; cela précise ce que la comparaison permet de montrer.
Quand une note de crédibilité devient une décision
Dans l’étude de Bogaard et ses collègues de 2026, 246 personnes évaluaient huit récits. Une faible association avec la crédibilité accordée aux histoires vraies ne se retrouvait pas clairement dans leur classement binaire correct : p = 0,062. Le format de présentation n’avait pas d’effet statistiquement clair dans cette tâche.
Tu peux trouver une histoire vraie légèrement plus convaincante qu’une histoire inventée, puis déclarer les deux vraies. La différence de note existe, mais l’invention reste inaperçue. Une appréciation et une décision correctement notée ne mesurent donc pas la même chose.
Cela vaut aussi pour une corrélation entre un geste et le soupçon. Elle peut montrer pourquoi des observateurs se méfient, y compris à tort. Sans réponse indépendante, elle ne montre pas que le geste accompagnait réellement un mensonge.
Des résultats encourageants à garder dans leur contexte
Verschuere et ses collègues ont rapporté neuf études en 2023 où l’attention portée aux détails permettait de distinguer des récits vrais et faux mieux que le jugement libre. Ce résultat ne transforme pas chaque longue histoire en vérité.
Un détail est utile lorsqu’il ouvre une possibilité de contrôle : une heure peut mener à un registre, un lieu à une image. Une invention peut aussi s’appuyer sur des détails authentiques autour d’un seul fait dissimulé. La vérification doit concerner ce fait.
Le repère ancien de Bond et DePaulo, environ 54% de bonnes classifications sans aide ni entraînement en 2006, concerne les tâches rassemblées. Il n’interdit pas le progrès d’autres méthodes. À l’inverse, une réussite particulière ne rend pas toutes les intuitions fiables. Pour comparer les résultats, conserve la tâche à côté du nombre.
Deux manières de se tromper
Un test peut laisser passer une histoire fausse. Il peut aussi accuser une histoire vraie. Si on l’incite à signaler presque tout, on détectera davantage d’inventions, mais on soupçonnera aussi davantage de récits sincères.
La sensibilité compte la part des récits faux repérés. La spécificité compte la part des récits vrais correctement laissés sans alerte. Les dénominateurs ne sont pas les mêmes. Une bonne valeur pour l’un ne fournit pas la valeur de l’autre.
Demande aussi ce qu’il advient des cas indécis. Reconnaître une incertitude peut être préférable à forcer une réponse. Mais retirer ces cas sans les compter donne une impression trompeuse de la couverture du test. Le lecteur doit savoir à quelle proportion du matériel le score s’applique.
Quarante-huit alertes, mais que signalent-elles ?
Prenons 400 récits fictifs, dont 40 faux et 360 vrais. Supposons une méthode qui repère 75% des faux et laisse correctement sans alerte 95% des vrais. Nous choisissons ces valeurs pour expliquer la différence entre les comptes, pas pour évaluer un outil existant.
Elle repère 30 récits faux et en manque dix. Parmi les vrais, elle en laisse 342 sans alerte et signale 18 à tort. Il y a donc 48 alertes, dont 30 ÷ 48 = 62,5% concernent effectivement un récit faux.
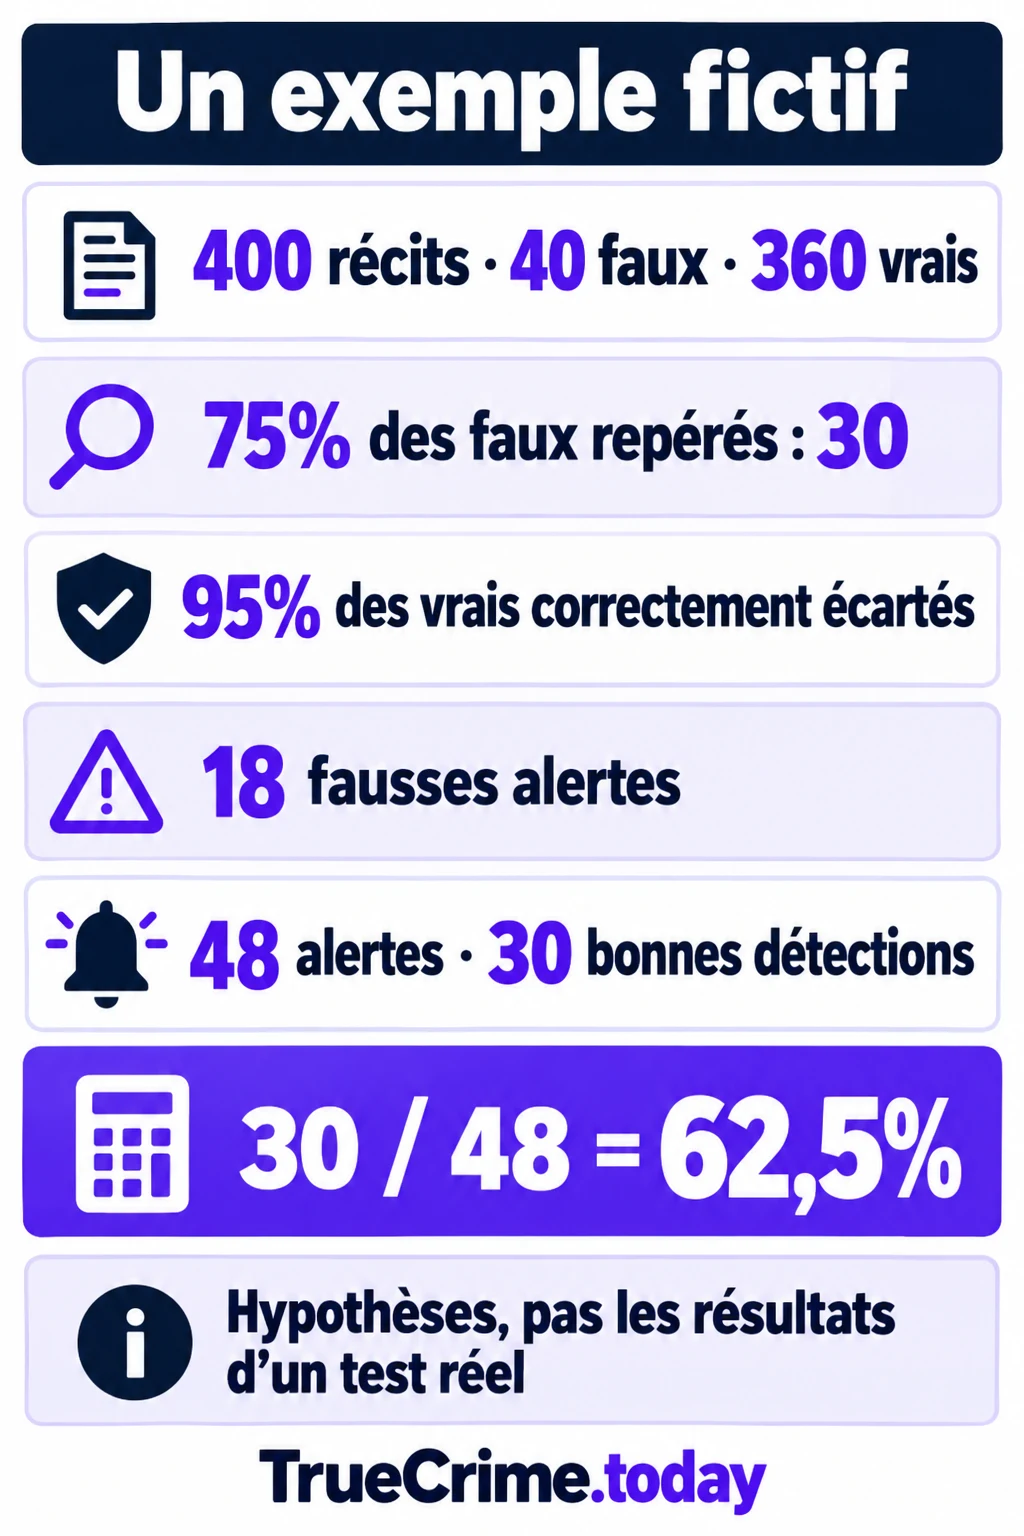
Le score général serait pourtant (30 + 342) ÷ 400 = 93%. Les deux nombres sont justes parce qu’ils répondent à deux questions. Change la proportion de récits faux ou un taux d’erreur, et la composition des alertes change. Ce calcul ne donne pas une probabilité pour la personne que tu regardes.
Le visage inconnu au prochain essai
Une évaluation automatique peut utiliser des extraits nouveaux de personnes déjà présentes dans l’apprentissage. C’est une nouveauté de fichiers, pas nécessairement de visages. Le système peut avoir retenu des caractéristiques de la voix ou de l’enregistrement.
Si la promesse porte sur des personnes inconnues, ces personnes doivent être séparées de l’apprentissage. Si elle porte sur un autre environnement, il faut étudier ce changement. Une caméra, une pièce ou une session peuvent accidentellement coïncider avec les étiquettes.
Mille extraits d’un entretien ne remplacent pas mille entretiens indépendants. La question n’est pas seulement la quantité disponible, mais ce qui est resté réellement inconnu au moment de l’essai. Une forte performance ne résout pas d’elle-même ce problème.
Une moyenne ne décrit pas chaque personne
Deux groupes imaginaires ont les valeurs 1, 2, 3 et 2, 3, 4. Leurs moyennes diffèrent, pourtant 2 et 3 apparaissent des deux côtés. Une valeur individuelle de 3 ne révèle pas sans erreur son groupe.
C’est une illustration arithmétique, pas une étude du mensonge. Elle montre pourquoi trouver une différence moyenne ne suffit pas à annoncer une précision individuelle. Il faut une règle de décision et ses erreurs sur du nouveau matériel.
Même un sentiment correctement identifié ne répondrait pas encore à toutes les questions. Avoir peur peut concerner la caméra, les conséquences de l’entretien ou un autre sujet. La cause de la réaction ne se lit pas dans son seul nom.
Vérifier si le résultat se répète
Luke a montré en 2019 comment petits échantillons, rares répétitions et sélection des résultats peuvent exagérer certains indices. Ce n’est pas la preuve que tous sont nuls. C’est une raison d’examiner le chemin vers le résultat publié.
Si l’on essaie plusieurs combinaisons et ne conserve que la meilleure, le lecteur ne voit pas les occasions de réussite fortuite. Décrire les choix avant les résultats, puis refaire l’essai sur un autre échantillon, rend la proposition plus facile à contrôler.
Les gens peuvent aussi préparer une version ou mélanger vrai et faux. Il faut tester ces conditions avant d’annoncer une performance dans la vie courante. Les personnes qui présentent un outil devraient pouvoir expliquer les limites de son évaluation autant que son meilleur score.
Le livre rendu et la date du catalogue
Dans une scène inventée, une personne affirme avoir rendu un livre à une bibliothèque associative le samedi. Le catalogue porte le lundi. Sa voix rassure, mais un système signale un mensonge. Quel élément répond à la question de la restitution ?
Le livre peut être arrivé dans une boîte de retour avant d’être enregistré. Il peut aussi avoir été remis à un autre endroit ou confondu avec un autre exemplaire. La réception physique et la mise à jour du catalogue ne datent pas forcément le même événement.
Un numéro d’exemplaire incompatible mérite une explication, même si la voix semble sincère. Mais le signal informatique ne décide pas qui s’est trompé ni s’il y avait intention de tromper. Il faut vérifier le fait, puis comprendre l’écart.
Ce que tu peux demander à un score
Garde ensemble la tâche, la façon de connaître la vérité, les deux erreurs et les cas sans décision. Demande ensuite si le résultat tient avec des personnes nouvelles et une répétition indépendante.
Une étude peut améliorer les questions sans résoudre une accusation. Sa valeur tient aussi à la clarté de ce qu’elle ne démontre pas. Une impression convaincante peut commencer une réflexion ; elle ne devrait pas la terminer à la place des preuves.
Tu peux poser une question sur un résultat ou une méthode de recherche. N’envoie pas d’enregistrements privés ni de documents personnels.
Poser une question sur la recherche