Forensisch auteurschapsonderzoek: van schrijfstijl naar bewijskracht
Wat zegt een overeenkomst tussen berichten over de schrijver? Onderzoek naar functiewoorden, vergelijkingsmateriaal, foutpercentages en alternatieve verklaringen.
Je leest een anoniem bericht en denkt meteen aan iemand. Dezelfde stopwoorden, dezelfde uitroeptekens, misschien zelfs dezelfde merkwaardige uitdrukking. Herkennen is een begin, maar hoe controleer je of die indruk klopt? Forensisch auteurschapsonderzoek vergelijkt taalpatronen en onderzoekt wat ze zeggen over de mogelijke schrijver. Daarvoor moet duidelijk zijn waar de teksten vandaan komen, welke alternatieven zijn onderzocht en hoe het gebruikte onderzoek presteert.
TL;DR
Schrijfstijl kan informatie over auteurschap bevatten. Voor een bruikbaar onderzoek zijn betrouwbare vergelijkingsstukken, passende omstandigheden en een getest procedé nodig. Gewone woorden en opvallende kenmerken kunnen elkaar aanvullen. Een gedeelde bron, ander onderwerp of gezamenlijke redactie kan een overeenkomst verklaren. Een score of eerste plaats onder kandidaten is geen zelfstandige kans op identiteit of schuld.
Je herkent een schrijfstijl. Hoe controleer je dat?
Je kunt een herkenbare formulering opmerken zonder te weten hoe bijzonder die werkelijk is. Misschien gebruikt de hele groep haar, of komt ze uit een standaardbericht. Wat voor jou ongewoon klinkt, kan in de betreffende werkomgeving heel normaal zijn.
Daarom moet een vergelijking ook kijken naar verschillen en variatie. Gebruikt dezelfde persoon de formulering op andere momenten? Doen andere relevante schrijvers dat ook? Alleen overeenkomende zinnen tonen geeft op die vragen geen antwoord. De selectie kan de indruk versterken zonder nieuwe informatie toe te voegen.
Wat het NFI met gewone woorden onderzoekt
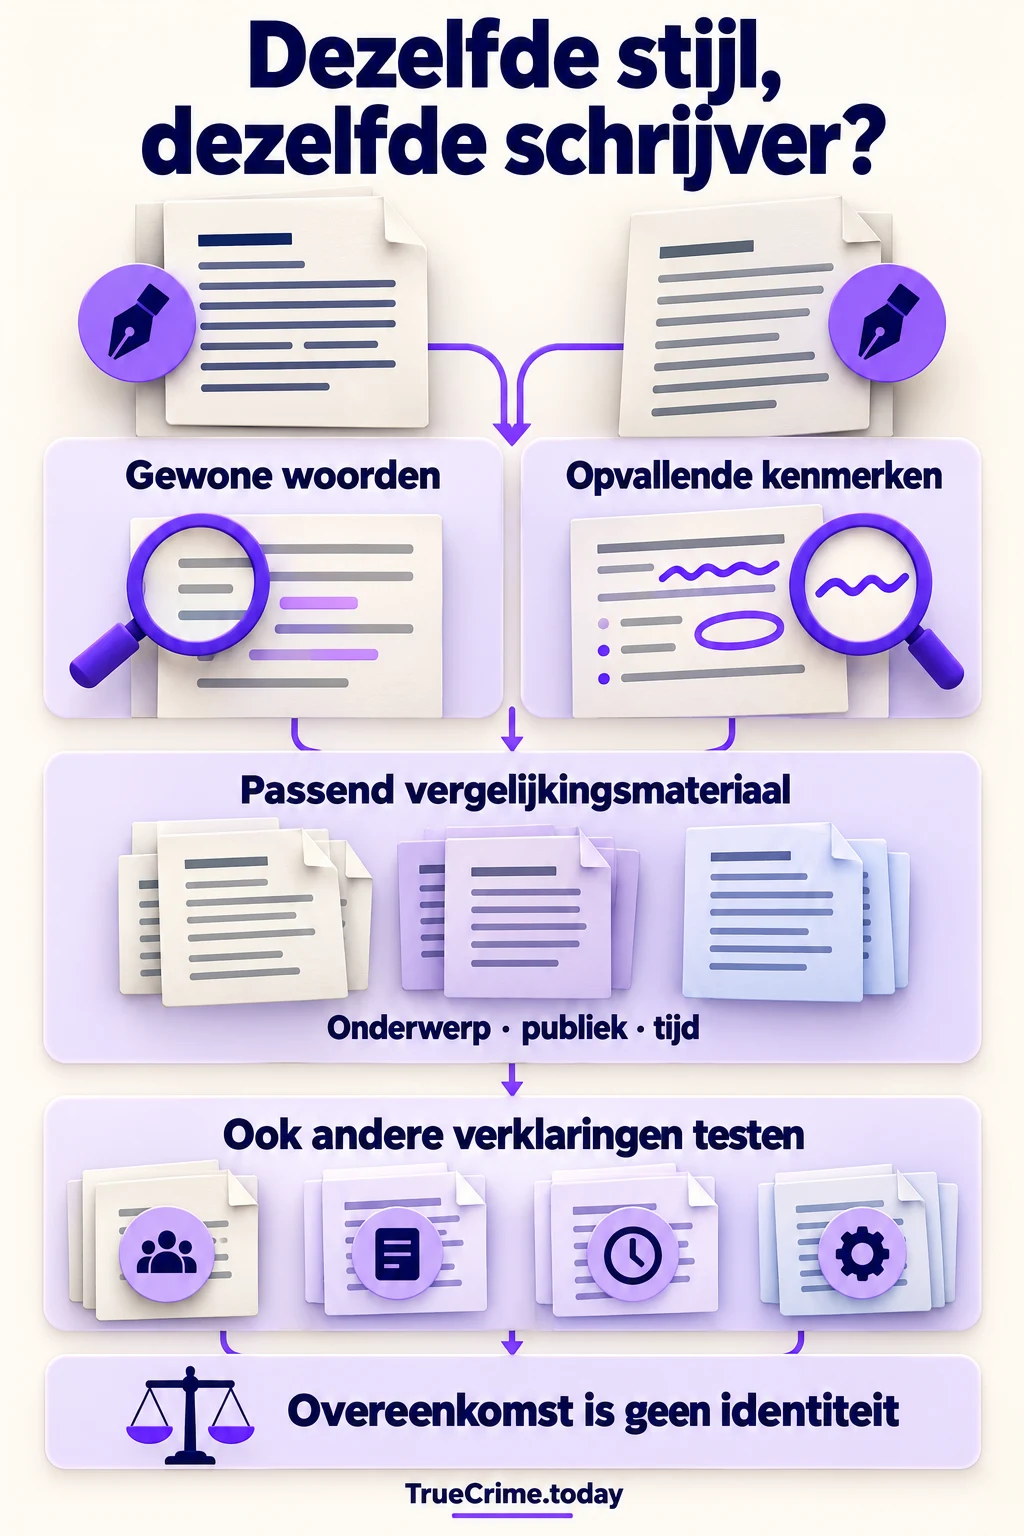
In zijn toelichting van april 2024 op auteurschapsherkenning beschrijft het NFI hoe tellingen van veelgebruikte woorden en onderzoek naar opvallende taalverschijnselen elkaar aanvullen. Kleine woorden hangen minder rechtstreeks aan een onderwerp dan inhoudswoorden. Ook passend vergelijkingsmateriaal krijgt nadruk.
Het gaat om een methodologische uitleg, niet om een universeel foutpercentage. Je kunt daaruit begrijpen waarom een onderzoek meer doet dan bijzondere uitdrukkingen zoeken. Of een concrete conclusie goed onderbouwd is, hangt nog steeds af van het materiaal, de gebruikte toetsing en de alternatieven.
Wat forensisch auteurschapsonderzoek precies vraagt
Binnen de forensische taalkunde zijn de betekenis en de herkomst van taal verschillende onderzoeksvragen. Vaststellen hoe een dreigende zin gelezen kan worden, bepaalt niet wie die zin heeft samengesteld. Ook de waarheid van het bericht blijft een eigen vraag.
Bij auteurschap kun je kandidaten vergelijken, gemeenschappelijk auteurschap toetsen of anonieme teksten groeperen. De conclusie moet aansluiten op die gekozen taak. Een groep berichten bij elkaar zetten levert bijvoorbeeld nog geen naam op. De meest gelijkende kandidaat aanwijzen bewijst evenmin dat de lijst compleet was.
Het bericht uit de buurtmoestuin
Neem een verzonnen conflict over een buurtmoestuin. Een anoniem bericht bekritiseert de verdeling van subsidie. Een formulering lijkt op die in e-mails van een bestuurslid. Vervolgens blijkt dezelfde zin in een aanvraag te staan die alle deelnemers hebben ontvangen.
De overeenkomst is daarmee niet verdwenen. Er is wel een andere verklaring bijgekomen: overname uit een gezamenlijke bron. Die mogelijkheid verandert het gewicht van de zin, zonder op zichzelf iemand aan te wijzen of uit te sluiten.
Als je een true-crimezaak onderzoekt, moet die verandering ook in het verhaal terechtkomen. Anders blijft de eerste verdenking staan terwijl de reden om de formulering persoonlijk te vinden inmiddels verzwakt is.
Vergelijkingsmateriaal: dezelfde persoon in welke situatie?
Een tekst geldt niet alleen door een naam onder het bericht als vaststaand werk van die persoon. Accounts kunnen gedeeld zijn, een collega kan redigeren en een passage kan geciteerd zijn. De bekende herkomst moet onafhankelijk van de te bewijzen gelijkenis worden onderbouwd.
Vervolgens tellen omstandigheden mee. Een subsidieaanvraag en een appje aan een vriend vragen om verschillende keuzes. Tijd, publiek en tekstsoort helpen verklaren waarom iemand varieert. Het origineel bewaren is nuttig: een overgetypte versie kan juist de spelling en leestekens veranderen die onderzocht zouden worden.
Waarom meer dezelfde woorden niet vanzelf meer bewijs is
Een tekst kan door een enkele overgenomen zin meerdere overeenkomsten vertonen. Hetzelfde woord, dezelfde zinsbouw en dezelfde komma horen dan bij één gedeelde bron. Ze als drie onafhankelijke aanwijzingen tellen kan de bewijskracht overschatten.
Ook een lijst met veel kenmerken heeft dus uitleg nodig. Naast woordfrequenties kunnen grammatica, interpunctie en tekenreeksen worden onderzocht. Een teken-n-gram is een reeks van een bepaald aantal tekens. Zulke reeksen maken het mogelijk patronen te meten zonder alleen opvallende woorden te selecteren.
Wat een onderzoek met bekende antwoorden laat zien
Patrick Juola rapporteerde in zijn onderzoek uit 2021 naar een computergestuurd verificatieprotocol 77 procent correcte beslissingen bij meer dan 32.000 documentparen uit Engelstalige blogs. Dat is een resultaat van dat protocol onder die onderzoeksomstandigheden. Het levert geen algemeen succespercentage voor Nederlands auteurschapsonderzoek op.
De totaalscore laat ook niet zelfstandig zien hoe de fouten verdeeld waren. Verschillende schrijvers onterecht gelijkstellen is iets anders dan teksten van dezelfde schrijver uit elkaar houden. Voor de interpretatie heb je die uitsplitsing en de beslisregels nodig. De 77 procent is bovendien geen individuele kans op auteurschap.
Negen keer dus tegenover drie keer dus
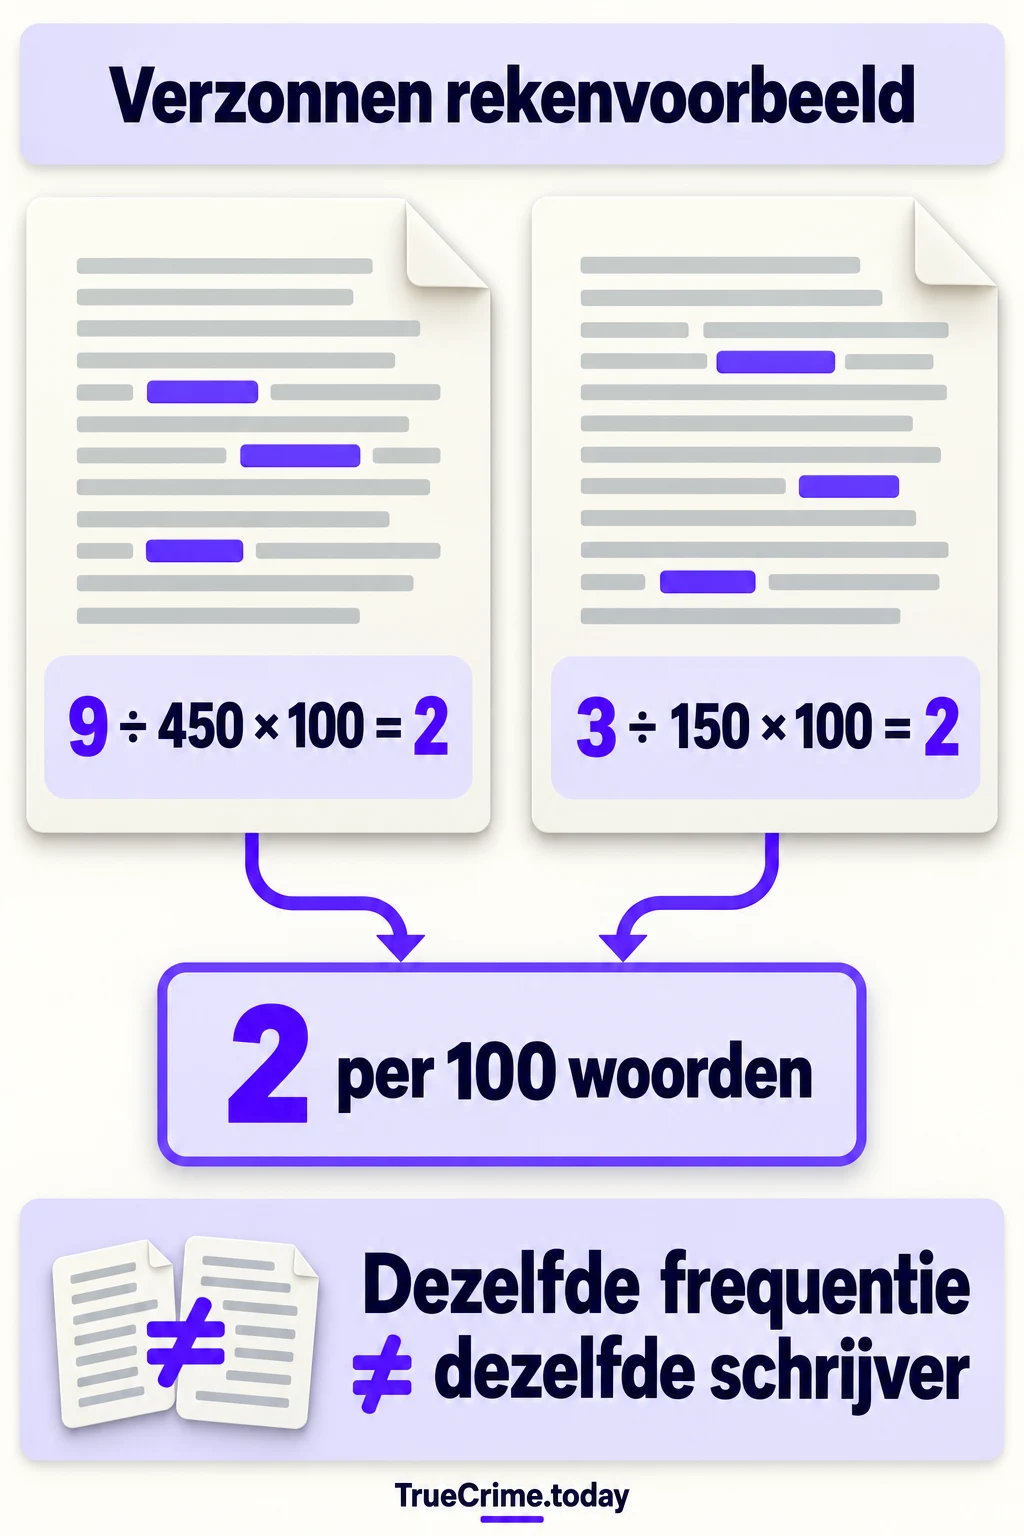
In ons verzonnen moestuinvoorbeeld komt dus negen keer voor in 450 woorden van het bekende materiaal en drie keer in 150 woorden van het anonieme bericht. Beide berekeningen geven twee per honderd woorden: 9 ÷ 450 × 100 = 2 en 3 ÷ 150 × 100 = 2.
De aantallen zijn bedacht om normaliseren uit te leggen. Dezelfde frequentie vertelt niet of dezelfde persoon schreef. Je wilt ook de variatie in andere teksten kennen, de frequentie bij andere schrijvers en de invloed van de gezamenlijke aanvraag. De rekensom maakt twee maten vergelijkbaar; zij voert geen identificatie uit.
Een keuze uit kandidaten kan iemand missen
Een gesloten vergelijking biedt een beperkt aantal kandidaten. Het systeem kan altijd de meest gelijkende kiezen, ook als geen van hen de echte schrijver is. De rangorde zegt dan iets over de aangeboden mogelijkheden, niet over de juistheid van de afbakening.
Verificatie vraagt naar steun voor gezamenlijke of verschillende herkomst. Ook daarvoor zijn alternatieven en toetsing nodig. Vraag bij een stellige uitkomst daarom welke vraag werkelijk is onderzocht en of de mogelijkheid van een ontbrekende schrijver een plaats in de methode had.
Hoe onderwerp en tekstsoort de uitslag sturen
Een moestuinbericht en een subsidieaanvraag kunnen dezelfde inhoudswoorden bevatten. Een systeem dat vooral daarop reageert, kan het onderwerp herkennen in plaats van de persoon. Een andere ontvanger kan daarnaast de toon en zinsbouw beïnvloeden.
Dit betekent niet dat elke vergelijking tussen onderwerpen onbruikbaar is. Het betekent dat het gebruikte procedé die verschillen moet aankunnen en dat die prestatie moet zijn onderzocht. Een fraai resultaat met volledige romans toont nog niet aan dat korte appjes even goed behandeld worden.
Van een score naar bewijskracht
Een likelihood ratio vergelijkt hoe waarschijnlijk de waargenomen kenmerken zijn onder twee benoemde verklaringen. Dat kunnen dezelfde schrijver en verschillende schrijvers uit een relevante populatie zijn. De keuze van die populatie bepaalt mede wat het getal betekent.
Een afstand of overeenkomstscore is niet automatisch zo’n verhouding. Er moet worden onderzocht hoe scores zich bij bekende antwoorden gedragen en welke bewijssterkte ermee verantwoord kan worden. Een onnauwkeurige vergelijking wordt niet beter doordat het resultaat veel cijfers achter de komma krijgt.
Waarom bewijskracht geen kans op schuld is
Een verhouding voor de taalbevindingen bepaalt niet zelfstandig hoe waarschijnlijk een persoon als auteur is. Daarvoor zijn ook uitgangspunten en andere gegevens van belang. Die mogen niet ongemerkt in de interpretatie worden gestopt.
Bovendien is schrijven iets anders dan een strafbaar feit plegen. Een bericht kan gelogen zijn of namens een ander zijn opgesteld. Zelfs een goed onderbouwde herkomst laat vragen over bedoeling, waarheid en handelen open. Hetzelfde gegeven in verschillende stappen opnieuw meetellen zou het bewijs sterker laten lijken dan het is.
Hoe een onderzoek voor anderen controleerbaar blijft
Een rapport moet het onderzochte materiaal, de herkomst, de selectie en de metingen herkenbaar maken. Ook de geteste verklaringen en de beperkingen horen erbij. Een andere onderzoeker moet kunnen begrijpen waarom bepaalde tekst is verwijderd of behouden.
Bij toetsing hoort materiaal waarvan het antwoord via een andere weg bekend is. Gegevens waarmee een systeem is ontwikkeld of afgesteld moeten duidelijk worden onderscheiden van gegevens waarmee het wordt geëvalueerd. Anders kan een goede score vooral vertrouwdheid met het materiaal weerspiegelen.
Van literaire stijl tot chatberichten
Vragen over schrijverschap komen al lang voor bij literaire en historische teksten. De stilometrie voegt systematische metingen toe aan die vergelijkingen. Bij een forensische vraag kunnen de fragmenten korter zijn en de oorsprong van de versies onzekerder.
Die verbinding is interessant, maar levert geen bewijs voor iedere nieuwe toepassing. Je moet opnieuw vaststellen welk materiaal en welke taak worden onderzocht. De reputatie van een geslaagde literaire toeschrijving vervangt geen toetsing met vergelijkbare berichten.
Korte berichten en teksten van meerdere handen
Een kort bericht biedt minder kansen om terugkerende keuzes te zien. Dat maakt niet elk kort tekstje waardeloos, maar er is geen universeel minimumaantal woorden dat een betrouwbaar antwoord garandeert. De bruikbaarheid hangt samen met de methode en het beschikbare vergelijkingsmateriaal.
Vertaling, dicteren en redactie brengen andere bijdragen in het tekstbeeld. Ook een taalmodel kan formuleringen toevoegen of fouten wegwerken. Een detector voor automatisch gegenereerde tekst beantwoordt een andere vraag dan een vergelijking tussen menselijke schrijvers. De ontstaansgeschiedenis moet daarom in beeld blijven.
Wat nieuwe grammaticamodellen nog moeten aantonen
Een in 2026 gepubliceerde studie van Nini en collega’s onderzocht grammaticale verificatie met twaalf Engelstalige datasets en zeven referentiemethoden. Het bredere testbereik is interessant, maar alle onderzochte taal was Engels. Twaalf datasets zijn geen twaalf geteste talen.
De auteurs benoemen beperkingen rond genre en taalafhankelijke verwerking. Voor een Nederlandse toepassing zijn dus passende aanvullende toetsen nodig. Zo kun je de waarde van nieuw onderzoek erkennen zonder er prestaties aan toe te schrijven die nog niet zijn vastgesteld.
Vragen na een online vergelijking
De vorm van een presentatie kan de indruk wekken dat de stap naar een naam klein is. Twee vragen helpen om die stap apart te bekijken, in plaats van hem met de herkenning mee te laten verdwijnen.
Is taal hetzelfde als een vingerafdruk?
De vergelijking is een beeldspraak. Mensen delen formuleringen en veranderen hun taalgebruik per situatie. Een taalonderzoek moet uitleggen hoe onderscheidend en stabiel de gemeten kenmerken zijn; de beeldspraak bewijst dat niet.
Bewijst auteurschap ook dat een bericht klopt?
Nee. De herkomst van de woorden en de juistheid van de inhoud blijven verschillende vragen. Ook een vastgestelde schrijver kan zich vergissen, iets verzinnen of misleiden. De beschreven gebeurtenissen vragen om eigen onderbouwing.
Wat je bij het volgende bericht wilt weten
Vraag na een herkenning naar de bekende teksten, de vergelijking en de andere verklaringen. In de moestuin maakt de gedeelde aanvraag duidelijk waarom één formulering te weinig vertelt. Een bruikbaar onderzoek laat zien welke extra informatie het toevoegt en waar de taalbevindingen ophouden. Daarmee kun je veel meer dan met alleen de mededeling dat twee stijlen op elkaar lijken.
Je kunt een vraag stellen over een tekstvergelijking of een onderzoeksgetal. Stuur geen privéberichten, dossiers of documenten van anderen mee.
Vraag over auteurschap stellen