FACS : comprendre les mouvements et les expressions du visage
Des sourcils au sourire : à quoi servent les unités d’action du FACS ? Exemples visuels, chiffres de recherche et précautions pour lire une vidéo.
TL;DR
Le FACS décrit les mouvements visibles du visage à l’aide d’unités d’action, les AU. Il permet de distinguer une paupière qui se lève, un sourcil qui descend ou une commissure qui se déplace. Ce vocabulaire ne contient pas à lui seul l’émotion, sa cause et la vérité d’un récit.
Les planches ci-dessous rendent les différences visibles. Elles sont créées par IA pour expliquer les mouvements, sans reproduire des personnes étudiées ni fournir des exemples certifiés de codage. Les chiffres viennent de recherches dont les tâches sont précisées : faire une pose, annoter une vidéo et interpréter un visage ne demandent pas les mêmes preuves.
Un visage expressif ne donne pas sa propre explication
Un personnage animé sourit et tu reconnais aussitôt une expression amicale. Pourtant, ce personnage n’a pas de sentiment à révéler. L’expression est lisible parce que des mouvements ont été choisis et combinés pour produire cet effet.
Devant une vraie personne, le passage de la forme à l’explication mérite autant d’attention. Une bouche souriante peut accompagner une salutation, une gêne ou un souvenir amusant. Reconnaître le déplacement des lèvres ne permet pas encore de choisir entre ces possibilités.
Dans la détection du mensonge, une étape supplémentaire est souvent ajoutée sans justification : on attribue une émotion, puis une raison de mentir. Le mouvement peut être correctement repéré alors que cette histoire reste une hypothèse. Pour savoir si une phrase est fausse, il faut vérifier ce qu’elle affirme.
Nous avons vérifié ces recherches pour la dernière fois le 20 octobre 2026.
Reconnaître une expression et en fabriquer une
La présentation de la thèse d’Arthur Crenn au LIRIS, soutenue en 2019, rapproche reconnaissance et synthèse d’expressions faciales et corporelles. Le projet cherche notamment à décrire des mouvements et leur style pour les utiliser dans l’animation. Ce résumé expose une question de recherche ; il ne fournit pas un taux de détection des mensonges.
Ce rapprochement est utile pour comprendre le Facial Action Coding System. Une description peut servir à comparer des observations ou à représenter une configuration. Elle n’est pas nécessairement un accès à l’expérience intérieure de la personne observée.
Le premier manuel FACS date de 1978 et sa révision de 2002. Ses unités d’action découpent les changements visibles. Une AU n’est pas une mesure électrique directe d’un muscle, et son numéro ne donne pas la force d’une émotion. Ce qu’on mesure et ce qu’on interprète doivent rester identifiables.
Les sourcils ne font pas le travail des paupières
AU1 relève la partie interne des sourcils, près du nez. AU2 relève leur partie externe. AU4 les abaisse et les rapproche. AU5 relève la paupière supérieure. Un œil plus ouvert et un sourcil plus haut sont donc deux changements différents, même s’ils peuvent se produire ensemble.
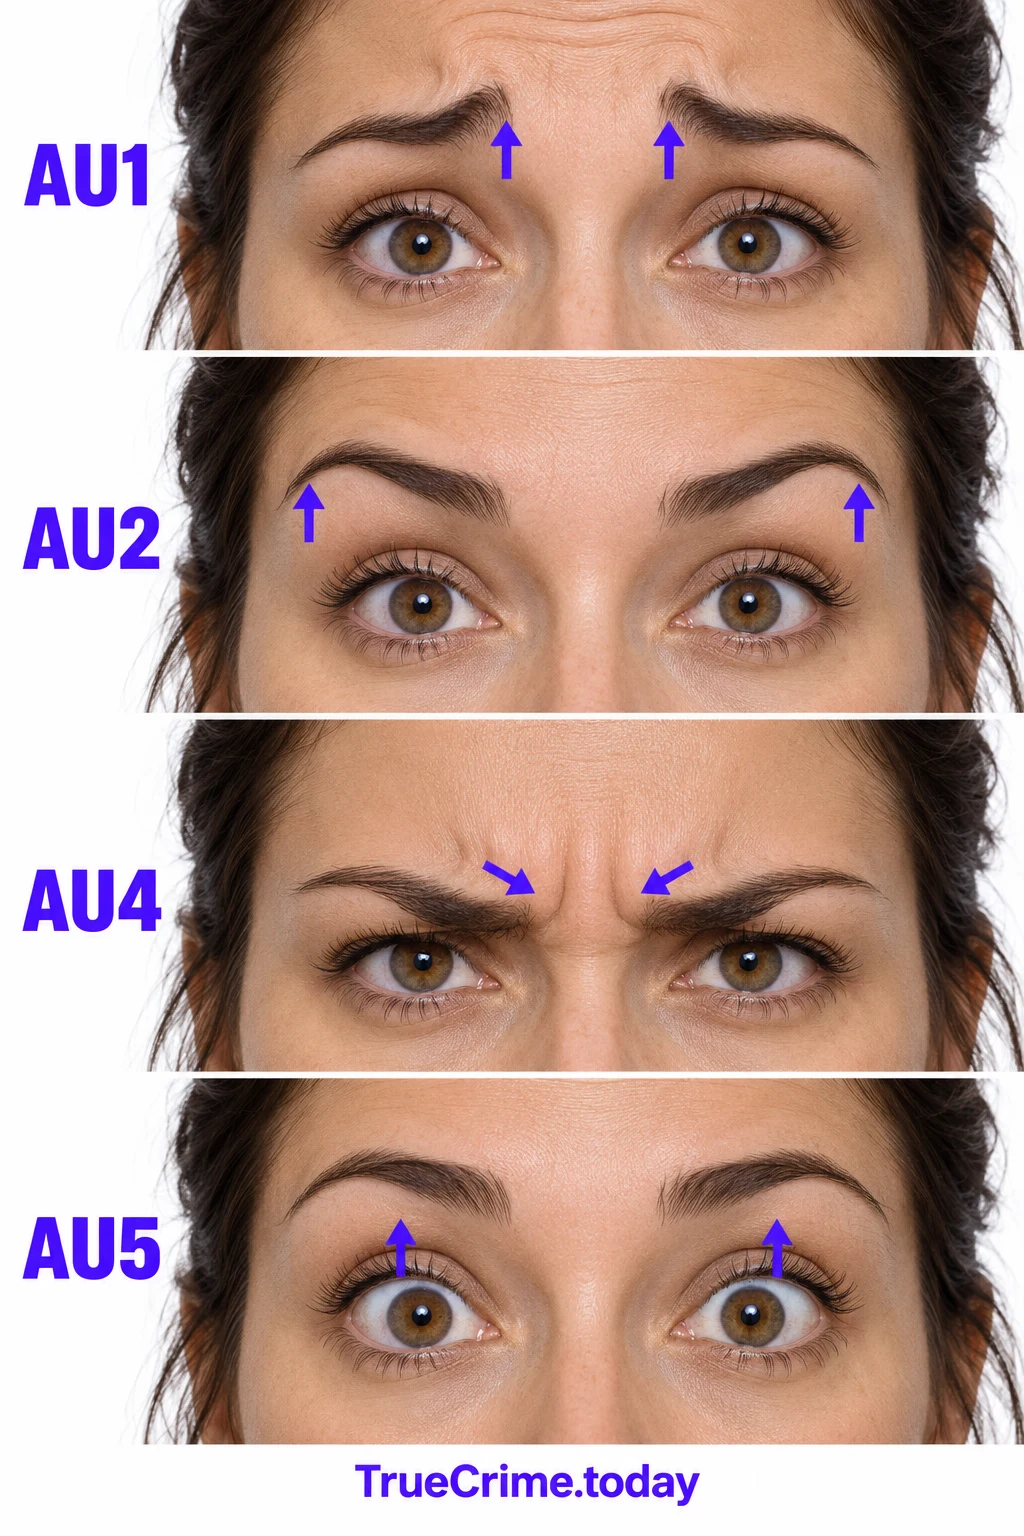
Pour les comparer, regarde d’abord la même zone avant et pendant le mouvement. Une ride déjà présente au départ n’est pas automatiquement une action nouvelle. Pendant la parole, la forme de la bouche change aussi sans que chaque ouverture constitue une réaction émotionnelle.
Le corpus GFT décrit par Girard et ses collègues montre comment cette description devient une annotation de recherche : la présence et l’intensité de certaines actions y sont examinées séparément. Cela permet de poser des questions précises, plutôt que de ranger tout un visage sous un seul mot.
Le sourire se décompose lui aussi
AU12 tire les commissures des lèvres vers le haut et les côtés. AU6 relève les joues et modifie la région sous les yeux et près de leurs coins. Leur combinaison est souvent associée au sourire de Duchenne. Elle ne garantit pas une joie involontaire.
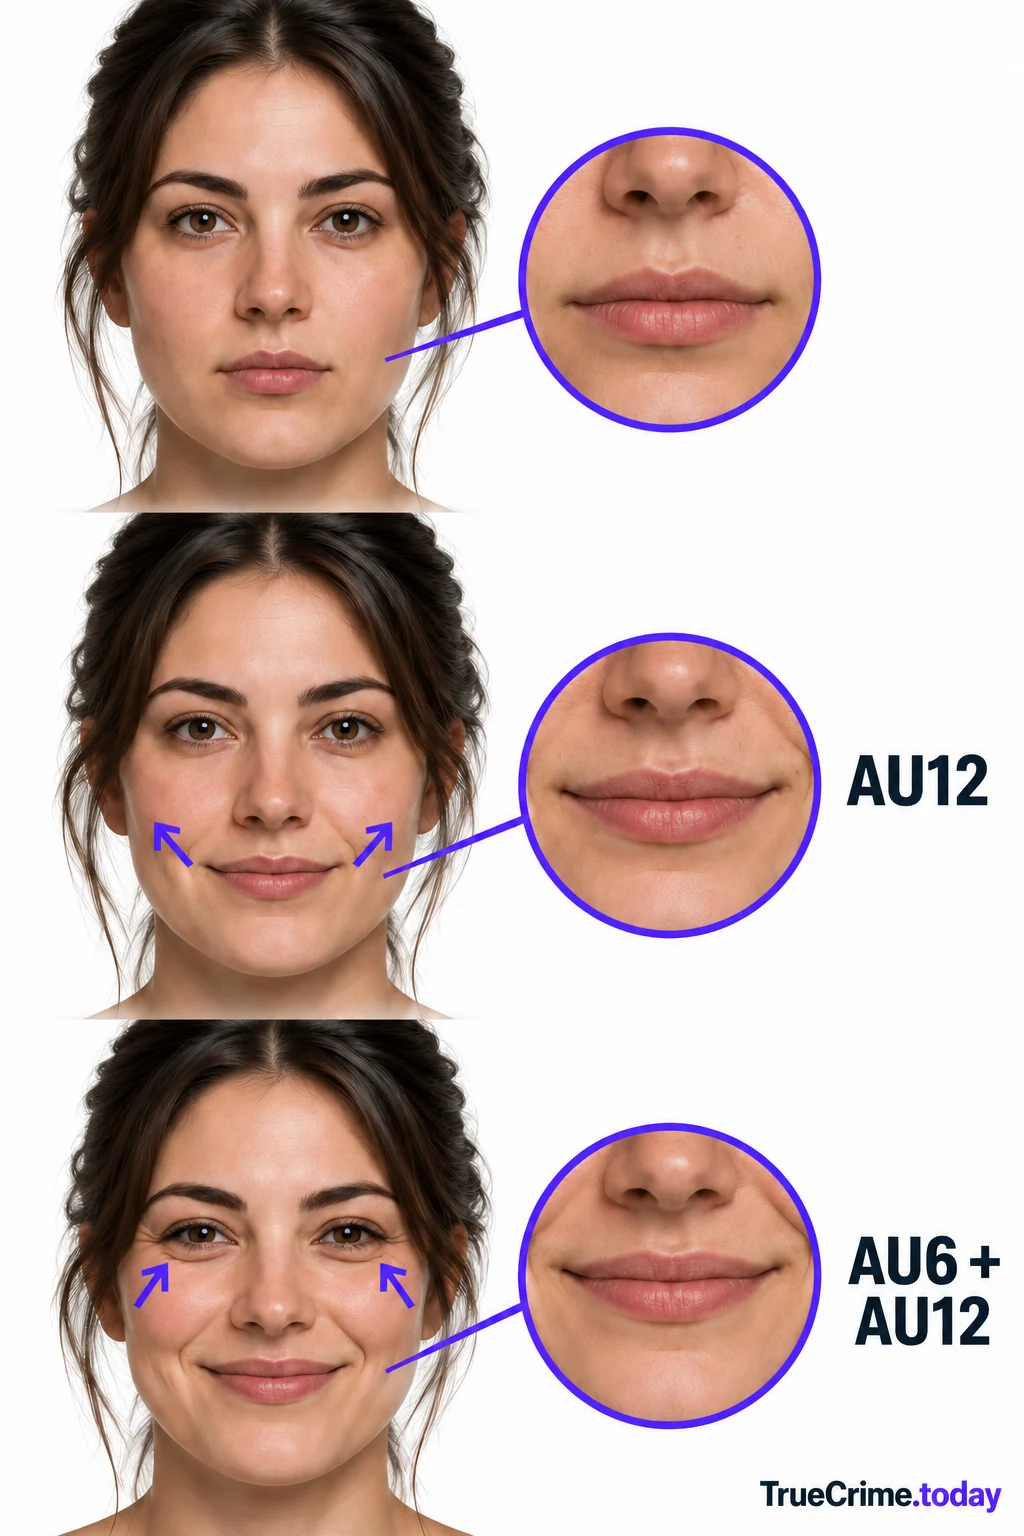
Dans leur étude de 2009, Krumhuber et Manstead ont comparé des sourires produits devant un contenu amusant à des sourires demandés. Leur premier essai a trouvé des proportions comparables de sourires de Duchenne et d’autres sourires dans ces conditions. Il est donc possible de produire volontairement la configuration habituellement présentée comme une garantie de spontanéité.
Regarde la bouche, puis les joues, sans ajouter tout de suite une intention. Même une joie réelle pourrait concerner la personne qui vient d’entrer dans la pièce. La question suivante est de savoir à quoi répond ce mouvement dans cette interaction.
Une expérience avec des consignes précises
Du et ses collègues ont étudié en 2014 les expressions de 230 personnes invitées à représenter des situations. Le dispositif distinguait 22 catégories : six simples, quinze composées et une neutre. Il s’agissait de photographies prises dans des conditions contrôlées et retenues pour des expressions reconnaissables.
Les résultats montrent une organisation des configurations demandées. Une surprise heureuse et une surprise en colère ne se réduisent pas forcément à la même image. C’est une raison positive d’étudier les mouvements avec précision.
Mais le nom de la catégorie venait de la consigne. Le sentiment réellement éprouvé n’était pas une réponse intérieure établie indépendamment et retrouvée par une caméra. Un bon résultat dans cette tâche ne devient pas une preuve sur la sincérité d’un entretien.
Six poses, quelques mouvements en commun
Les six portraits représentent 1 la joie, 2 la tristesse, 3 la peur, 4 la colère, 5 la surprise et 6 le dégoût, sous forme de poses illustratives. Compare la peur et la surprise : des lèvres entrouvertes peuvent apparaître dans les deux, mais le rapprochement des sourcils et l’étirement latéral de la bouche changent la configuration.
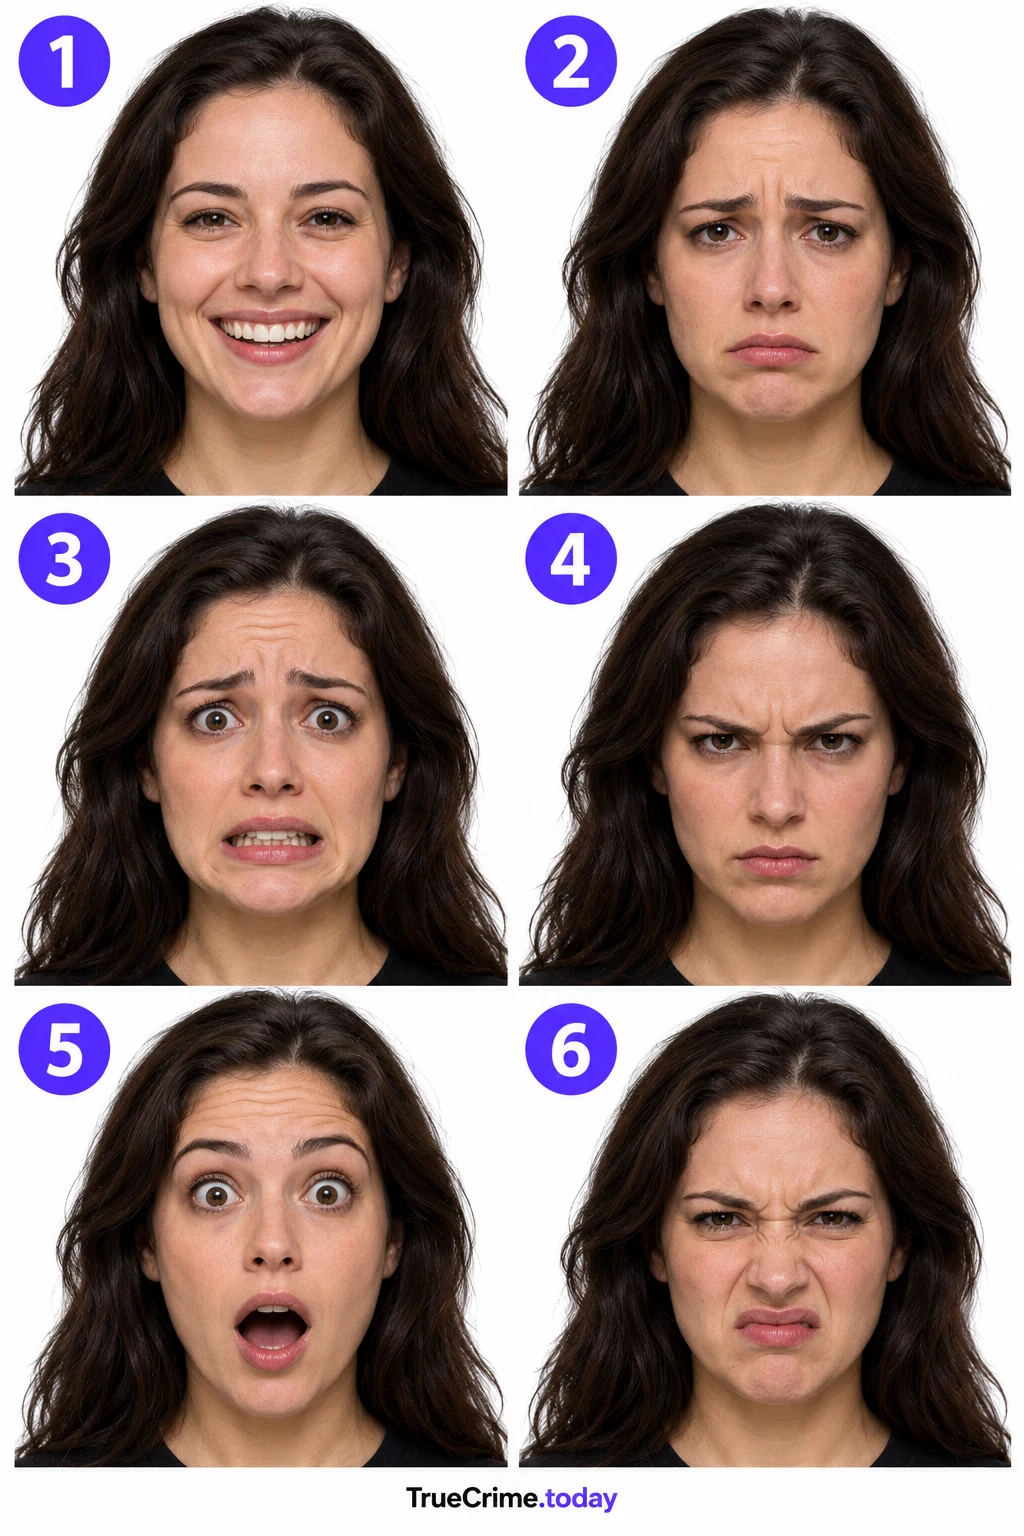
Dans les données de Du, les ensembles récurrents comprenaient 12 + 25 pour la joie, 4 + 15 pour la tristesse, 1 + 4 + 20 + 25 pour la peur et 4 + 7 + 24 pour la colère. AU25 correspond aux lèvres qui se séparent ; AU20 à leur étirement latéral, AU7 à la tension des paupières et AU24 à la pression des lèvres.
Pour une analyse d’affaire criminelle, ces descriptions ne répondent pas directement à une question sur un acte. Les lèvres d’une personne peuvent être ouvertes sans que tu saches si elle a envoyé le message dont elle parle. Le code concerne le visage ; l’envoi doit être vérifié autrement.
Ce que les différences entre personnes changent
Une pose reconnaissable n’exigeait pas tous les mouvements possibles chez chaque personne. AU6 était présent dans 51% des poses joyeuses, AU1 dans 60% des poses tristes et AU5 dans 66% des poses surprises. La combinaison récurrente reposait sur un seuil supérieur à 70% de présence dans la catégorie.
Les configurations de surprise incluaient 1 + 2 + 25 + 26, celles de dégoût 9 + 10 + 17. AU26 abaisse la mâchoire ; AU9 plisse le nez, AU10 relève la lèvre supérieure et AU17 le menton. Les actions partagées et les variantes sont plus instructives qu’une formule censée fonctionner pour tout le monde.
Ces pourcentages décrivent des poses dans ce matériel sélectionné. Ils ne donnent pas la probabilité d’un sentiment lorsque tu aperçois un mouvement sur une autre vidéo. L’absence d’une joue nettement relevée ne suffit donc pas à démasquer un sourire trompeur.
Une main devant la bouche laisse une inconnue
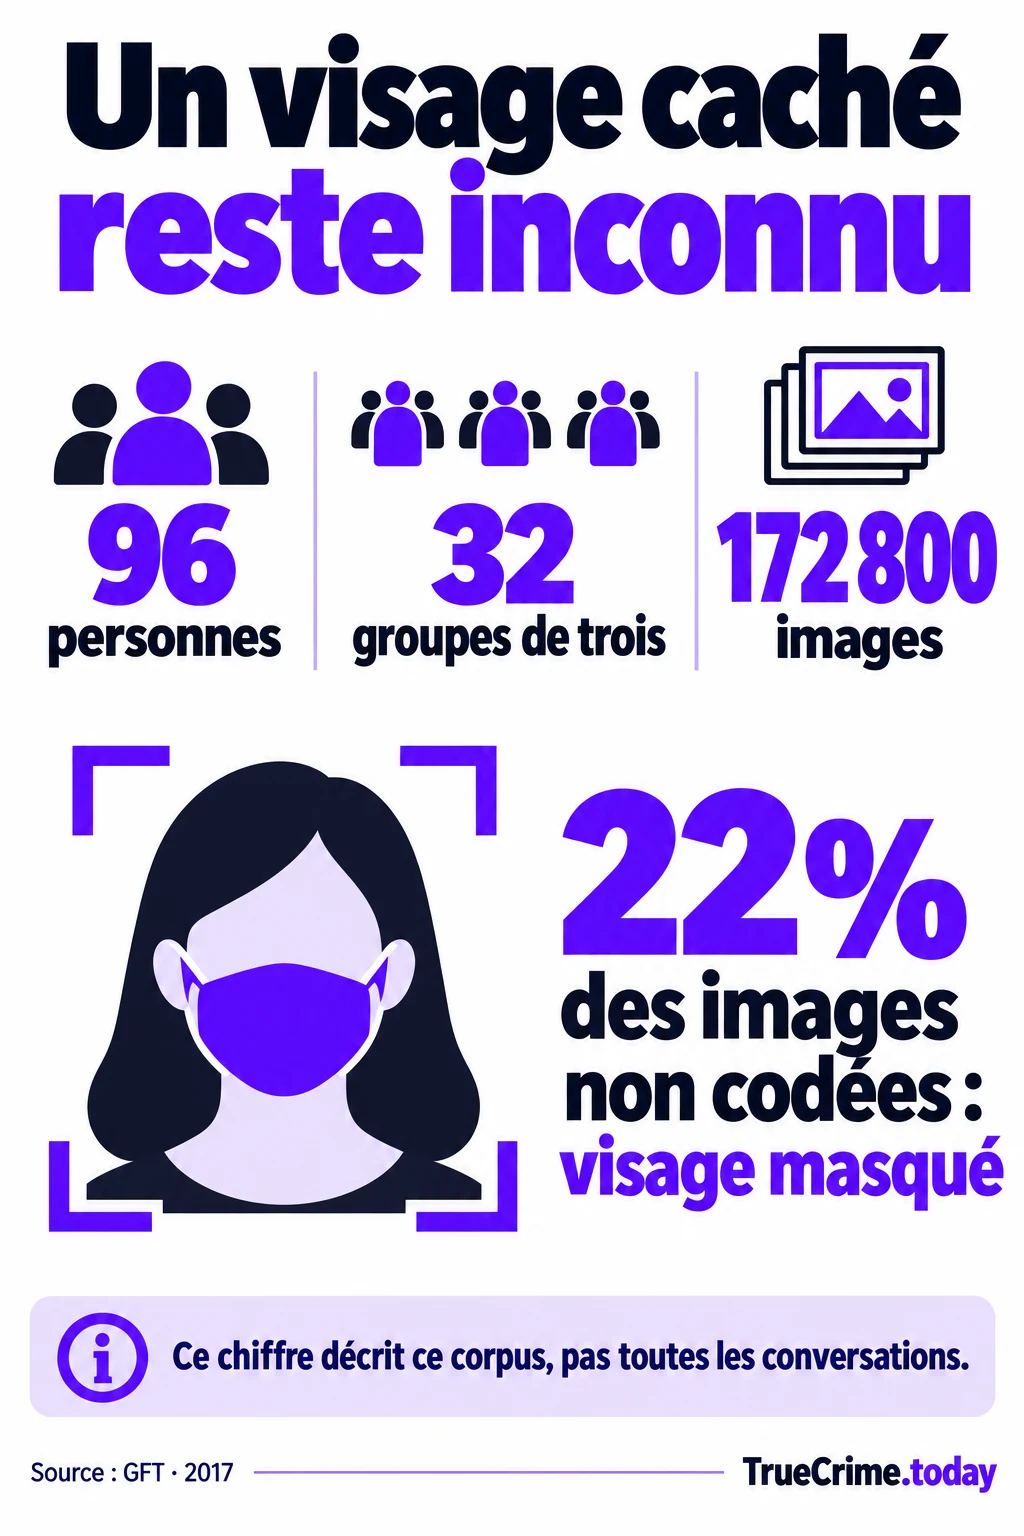
GFT rassemble 96 personnes en 32 groupes de trois, pour 172 800 images. Les participantes et participants discutaient dans un dispositif comportant alcool, placebo et condition témoin. Ce contexte et cette sélection de jeunes adultes font partie de ce que les données peuvent représenter.
Les auteurs ont laissé 22% des images sans codage à cause d’une obstruction du visage. Une main devant la bouche ne prouve pas que les lèvres étaient immobiles. Elle peut simplement empêcher de les observer.
C’est une règle de description très concrète : ne transforme pas une zone invisible en zone sans mouvement. Sur une vidéo d’entretien, un microphone, une main ou un changement d’angle peut laisser la même question ouverte. Une annotation utile peut comporter une inconnue.
Pourquoi les petites intensités comptent
FACS permet aussi d’indiquer l’intensité visible d’une action avec des niveaux A–E. Il s’agit d’un ordre d’intensité, pas d’une quantité de joie ni d’une échelle de sincérité. Une action forte n’est pas cinq fois plus émotive qu’une action faible.
Dans le matériel de GFT annoté pour l’intensité, les proportions A–E étaient 42%, 39%, 15%, 3% et 1%. Les deux niveaux inférieurs totalisaient 81%. Vingt actions avaient reçu un codage de présence, et cinq un codage d’intensité : les deux ensembles ne sont pas interchangeables.
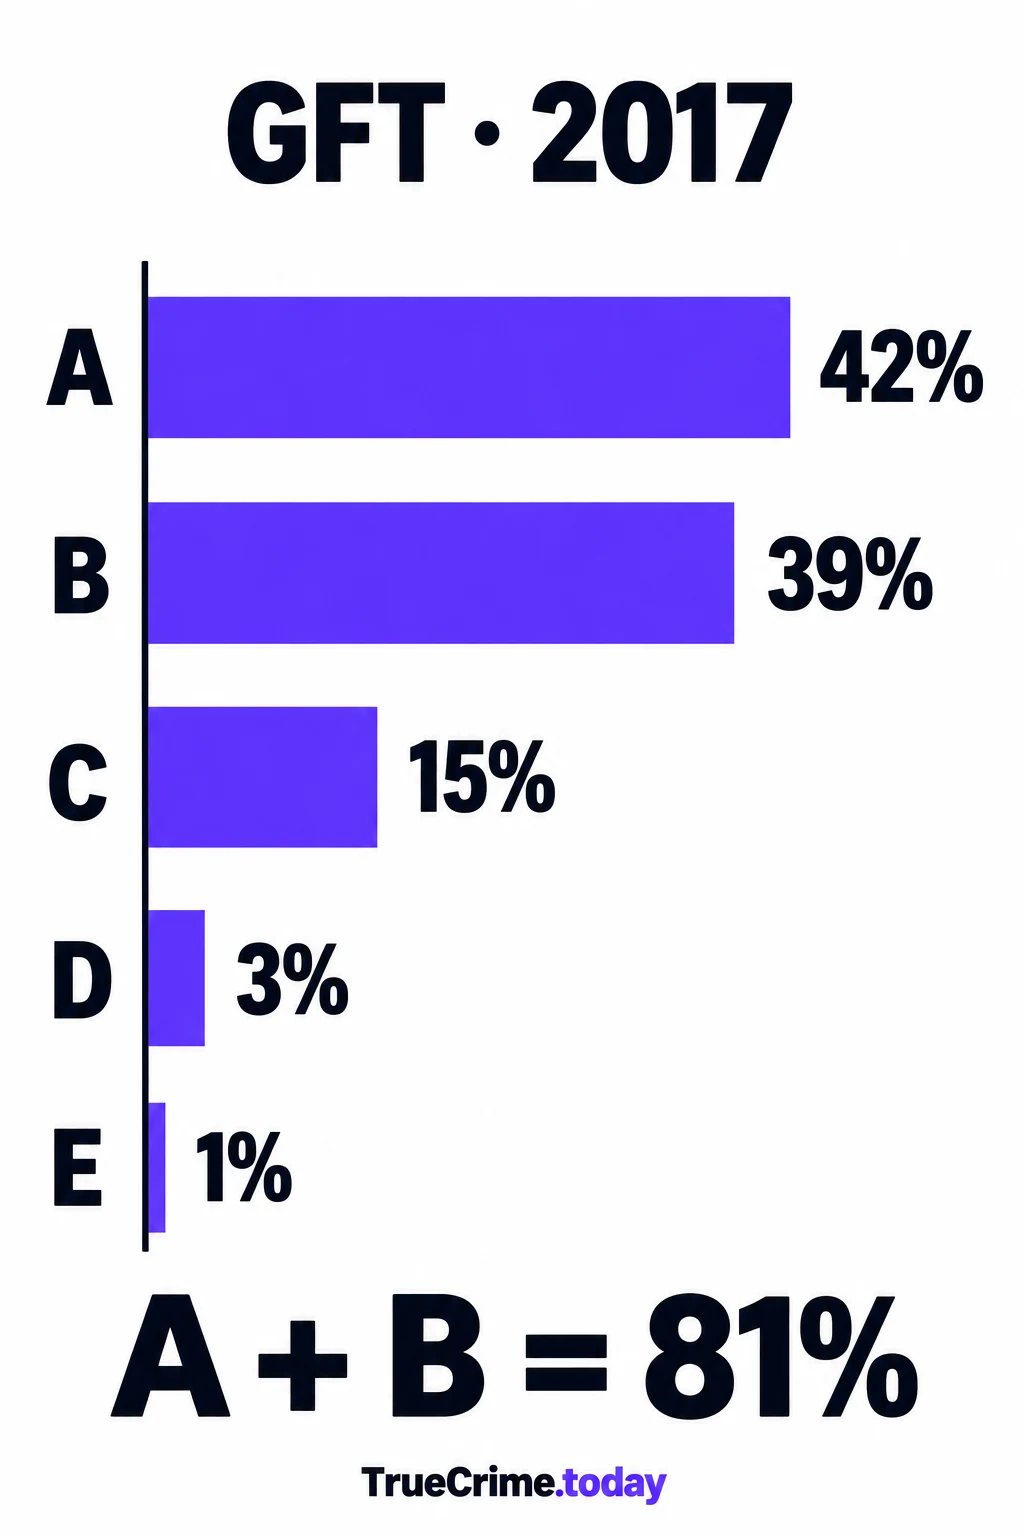
Ce ne sont pas les fréquences de toutes les expressions humaines. Ces chiffres montrent néanmoins pourquoi une collection de grandes grimaces ne couvre pas tout ce qu’il faut observer. Des mouvements discrets peuvent faire partie du travail sans raconter une émotion cachée.
Deux descriptions d’accord ne prouvent pas un sentiment
Dans DISFA, publié en 2013, 27 adultes ont fourni 4 845 images chacun, soit un produit de 130 815 images. Douze actions ont été annotées de 0 à 5. Un second codage de dix personnes a donné des coefficients ICC de 0,80 à 0,94, selon l’action.
L’accord porte sur l’intensité décrite. Ce n’est pas 80–94% de mensonges identifiés. Deux personnes peuvent reconnaître le même relèvement de joue et partager une interprétation erronée de sa cause.
La revue de Barrett et ses collègues, en 2019, aide à comprendre cette distinction : une association répétée avec une émotion ne suffit pas si le mouvement apparaît aussi dans d’autres situations. La description peut être reproductible sans que l’inférence soit assez spécifique pour conclure sur une personne.
Des millions de vidéos, mais quelle question ?
Cowen et ses collègues ont analysé six millions de vidéos de 144 pays, avec seize types d’expressions. Ils ont trouvé 70% de conservation des associations entre expression et contexte dans douze régions. Ce résultat soutient l’existence de régularités partagées, pas une précision de 70% pour connaître les sentiments individuels.
En 2012, Jack et ses collègues avaient demandé à quinze personnes d’Europe occidentale et quinze personnes chinoises d’Asie orientale de classer chacune 4 800 animations. Leurs résultats concernaient les représentations de ces observateurs et leurs différences, pas toutes les personnes de ces régions.
Les deux études ne se réfutent pas en comparant la taille des nombres. Elles portent sur des tâches différentes. Un modèle qui reconnaît une association dans une vidéo ne connaît pas nécessairement la raison d’une expression dans l’entretien que tu regardes.
Un visage change dans le temps
Dans une vidéo illustrative à 30 images par seconde, quatre intervalles représentent environ 133 millisecondes. Entre le premier et le quatrième instant échantillonné, il n’y a que trois intervalles, soit 100 millisecondes. La différence vient de ce que l’on compte, pas d’un changement d’émotion.
Le début et la fin réels peuvent tomber entre les images. Le ralenti ne rétablit pas les instants manquants, et un montage peut supprimer le déclencheur de la réaction. Il faut regarder l’avant et l’après avant d’associer une expression à une phrase.
De nombreuses images d’une même personne ne créent pas non plus de nouvelles personnes indépendantes. Pour évaluer un système, demande si les visages examinés étaient absents de son apprentissage, plutôt que de te contenter d’un grand nombre d’images.
Quand une note automatique devient une accusation
Une sortie automatique peut être une intensité AU, une classe ou une note interne. Demande à quoi elle a été comparée pendant l’évaluation : annotation humaine, expression demandée ou information indépendante sur le vécu ? Les réponses ne se remplacent pas.
Une note de 0,8 ne veut pas forcément dire une probabilité vérifiée de 80% d’avoir peur. Et une émotion correctement estimée ne rend pas une phrase fausse. Il reste à établir ce qui s’est passé et ce que la personne savait.
Les lunettes, la compression, la lumière et la position de la tête peuvent également changer le problème. Le résultat obtenu sur des visages frontaux dégagés ne décrit pas automatiquement une vidéo de mauvaise qualité.
Le remboursement et le salut hors champ
Imaginons une personne qui raconte avoir remboursé un colis. Elle sourit au début d’une réponse et le fragment est présenté comme un plaisir à tromper. La séquence complète fait entendre une voix amie qui la salue juste avant.
Ce contexte fournit une autre cause possible du sourire. Il ne prouve pas le remboursement. Une demande de virement, son exécution et son arrivée sur un compte peuvent porter des dates différentes. Ces étapes doivent être identifiées avant de déclarer les versions incompatibles.
Si une pièce contredit le fait affirmé, l’écart mérite une explication, sourire ou non. Si les pièces concordent, une impression défavorable ne fabrique pas le mensonge manquant. Cette scène est inventée pour séparer les vérifications, sans attribuer de comportement à une personne réelle.
Ce qu’il faut garder avec le code
Garde le moment, la zone du visage, la qualité de l’image et ce qui se passait autour. Précise si un mouvement est incertain. Si tu proposes une émotion ou une intention, indique quelles informations supplémentaires permettent d’en discuter.
La valeur du FACS tient à une observation plus précise et comparable. Plus une conclusion sur une personne est lourde de conséquences, plus ses preuves doivent correspondre à ce qui est affirmé. Un code bien choisi peut aider à formuler la question ; il ne dispense pas de chercher la réponse.
Tu peux poser une question sur une étude ou une affirmation concernant les mouvements du visage. N’envoie pas d’enregistrements privés ni de documents personnels.
Poser une question sur les recherches