FACS: come si descrivono i movimenti del viso
Sopracciglia, palpebre, sorrisi ed espressioni in posa: che cosa codifica la FACS, con esempi visivi, dati e limiti delle interpretazioni.
TL;DR
La FACS descrive i cambiamenti visibili del viso tramite unità d’azione, indicate con AU. Un codice può precisare dove si è mosso il volto; non stabilisce da solo un sentimento, la sua causa o la verità di una frase. Per ogni passaggio servono informazioni adatte alla domanda.
Le immagini ti permettono di confrontare sopracciglia, palpebre, sorrisi e sei espressioni in posa. Sono illustrazioni didattiche generate con IA, non fotografie dei partecipanti agli studi né esempi certificati di codifica. I dati aiutano a capire che cosa è stato effettivamente osservato, senza trasformare una configurazione in una diagnosi.
Un’espressione ambigua non diventa chiara con un codice
Un volto compare sullo schermo con una scritta: “paura”. Subito dopo arriva la spiegazione: quella persona teme che venga scoperto qualcosa. In realtà sono state unite almeno tre domande. Quale movimento è visibile? Quale emozione potrebbe esserci? Perché proprio quell’emozione?
La precisione del numero non risolve i passaggi mancanti. Anche un movimento descritto correttamente può ricevere una spiegazione sbagliata. E una paura reale non dimostra che una frase sia falsa: potrebbe riguardare la telecamera, l’esposizione o una conseguenza diversa da quella immaginata.
La FACS è utile quando rende più controllabile l’osservazione. Non ha bisogno di promettere un accesso diretto ai pensieri. Le ricerche discusse qui sono state ricontrollate per l’ultima volta il 20 ottobre 2026.
Anche chi guarda partecipa al riconoscimento
L’Università di Padova ha presentato nel settembre 2026 uno studio sul riconoscimento delle espressioni e la paralisi facciale, coordinato da Paola Sessa con la collaborazione di Pier Francesco Ferrari. Il confronto riguardava persone con paralisi congenita o acquisita; la comunicazione descrive anche una limitazione temporanea dei movimenti in volontari sani.
Di fronte alle espressioni ambigue, la mobilità residua era collegata alla capacità di riconoscerle. Il lavoro riguarda il contributo sensori-motorio di chi osserva e le differenze fra condizioni. Non misura la sincerità e non fornisce una regola per interpretare o diagnosticare il volto di qualcuno a distanza.
Il punto per chi guarda un’intervista è concreto: riconoscere non significa semplicemente ricevere un messaggio già completo dalla faccia altrui. Anche la situazione percettiva e il tipo di compito contano. Per questo dobbiamo distinguere un giudizio sull’espressione da un fatto accertato sulla persona.
Le chiavi riconsegnate e la persona fuori campo
Immagina una scena inventata: una persona racconta quando ha restituito le chiavi di un appartamento. Durante la risposta sorride. Un breve estratto viene presentato come il piacere di raccontare una bugia sull’orario della riconsegna.
La ripresa intera mostra l’arrivo di una persona amica appena prima del sorriso. È un’altra possibile causa della reazione, non una conferma dell’orario. L’appuntamento, la consegna fisica e la firma del verbale possono avvenire in momenti diversi.
In un’analisi di un caso, la verifica deve riguardare il fatto in discussione. Un verbale può contraddire o chiarire il racconto; il sorriso non decide che cosa sia successo alle chiavi. Separare le domande permette di esaminare un’incongruenza reale senza inventarne una dal viso.
Descrivere prima di attribuire un’emozione
Il Facial Action Coding System fu pubblicato come manuale nel 1978 e rivisto nel 2002. Le unità d’azione descrivono cambiamenti visibili. Non sono percentuali di emozione né letture elettriche dirette dell’attività muscolare.
Nella rilevazione delle bugie, la distinzione è necessaria anche quando un’emozione sembra plausibile. Dire che una persona appare in tensione non identifica la frase inesatta, né dimostra che la persona ne conosca l’inesattezza. Servono verifiche sul contenuto e, quando si attribuisce un inganno intenzionale, su ciò che sapeva.
La faccia di partenza e i movimenti della parola vanno considerati. Una caratteristica già presente non è automaticamente una nuova reazione. Un fotogramma preso durante una vocale può sembrare una smorfia emotiva, mentre appartiene alla pronuncia.
Che cosa cambia fra due sorrisi
AU12 tira gli angoli delle labbra verso l’alto e lateralmente. AU6 solleva le guance e modifica l’area sotto gli occhi e vicino ai loro angoli. La combinazione è spesso chiamata sorriso di Duchenne, ma non certifica un piacere involontario.
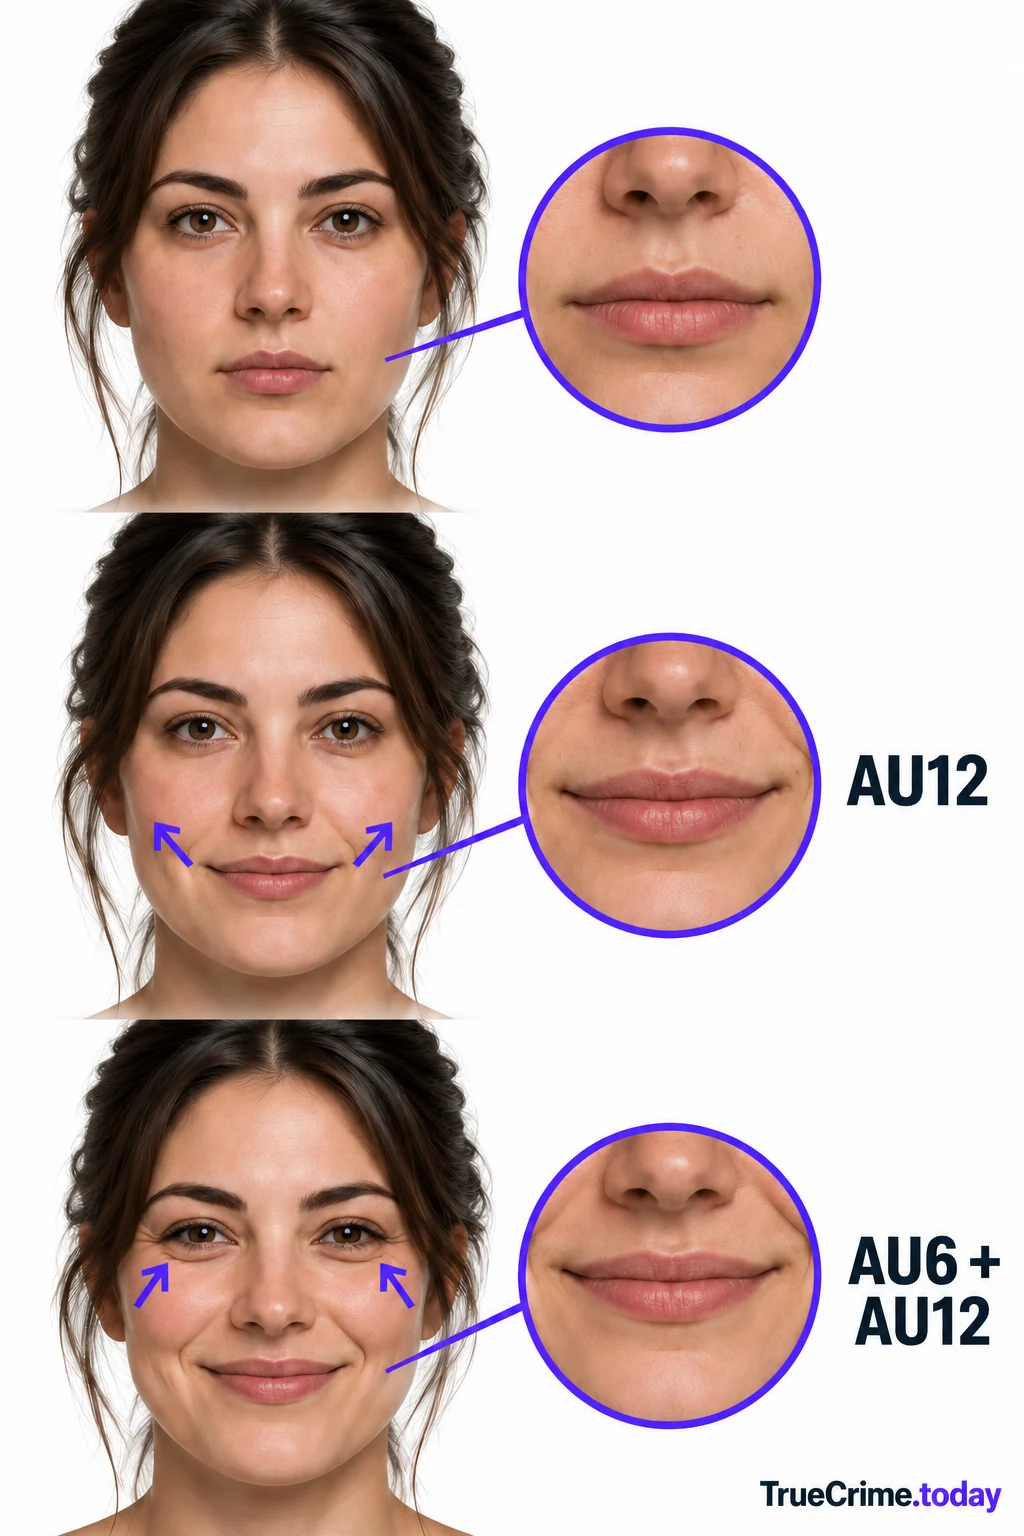
Krumhuber e Manstead confrontarono nel 2009 sorrisi davanti a materiale divertente e sorrisi richiesti ai partecipanti. Nel primo esperimento trovarono proporzioni simili di sorrisi di Duchenne e di altri sorrisi nelle due condizioni. Quella configurazione può quindi essere prodotta deliberatamente.
Confronta prima la bocca e poi la zona delle guance. Notare la differenza migliora la descrizione, ma non stabilisce se il sorriso riguardi una battuta, un saluto o l’argomento della domanda. Anche un piacere autentico deve essere collegato al suo contesto prima di attribuirgli un motivo.
Una consegna può produrre una faccia riconoscibile
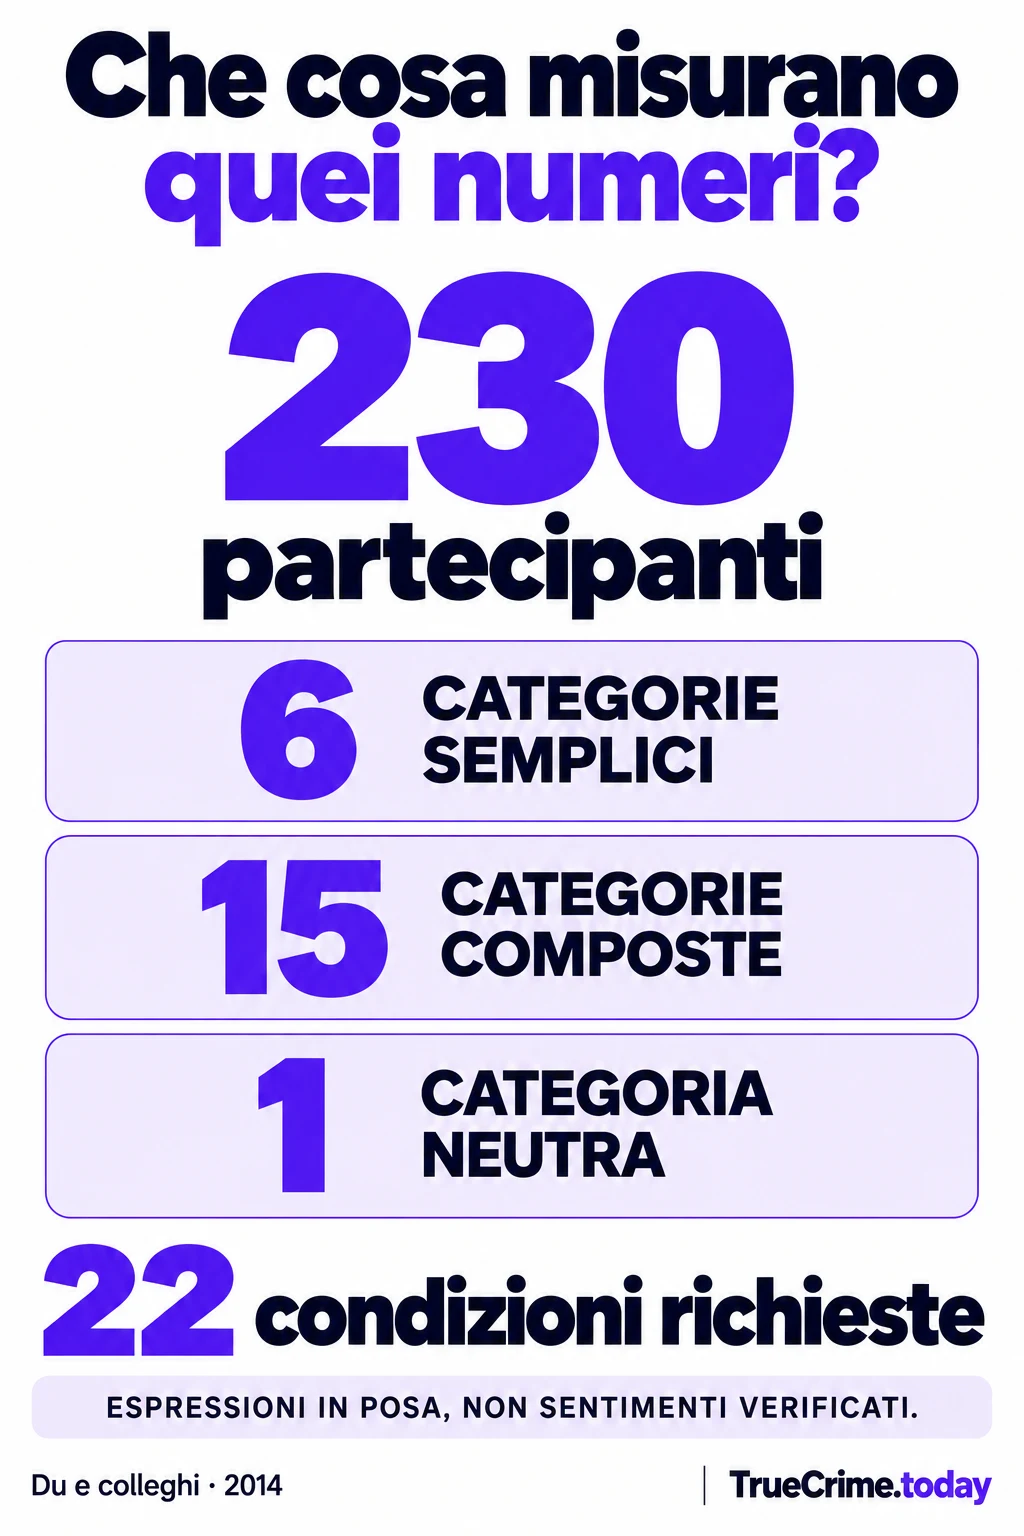
Nello studio di Du e colleghi del 2014, 230 persone produssero espressioni seguendo istruzioni e situazioni proposte. Furono considerate 22 categorie: sei semplici, quindici composte e una neutra. Le fotografie venivano realizzate in condizioni controllate e selezionate per espressioni riconoscibili.
La ricerca trovò regolarità nelle combinazioni e differenze fra le categorie. Questo è un risultato a favore dell’analisi dei movimenti. Una sorpresa felice e una sorpresa arrabbiata possono avere configurazioni diverse, invece di essere semplicemente due immagini della stessa sorpresa.
Il nome della categoria apparteneva però alla consegna. Non era un sentimento privato verificato indipendentemente e indovinato dalla macchina. Riconoscere una posa richiesta e interpretare una reazione spontanea durante un’intervista sono compiti diversi.
Sei pose da confrontare, non sei diagnosi
La tavola rappresenta 1 gioia, 2 tristezza, 3 paura, 4 rabbia, 5 sorpresa, 6 disgusto. Confronta paura e sorpresa: entrambe possono mostrare labbra aperte, ma cambiano il disegno delle sopracciglia e la tensione laterale della bocca. Tristezza e rabbia possono condividere un avvicinamento delle sopracciglia senza coincidere nell’intera configurazione.
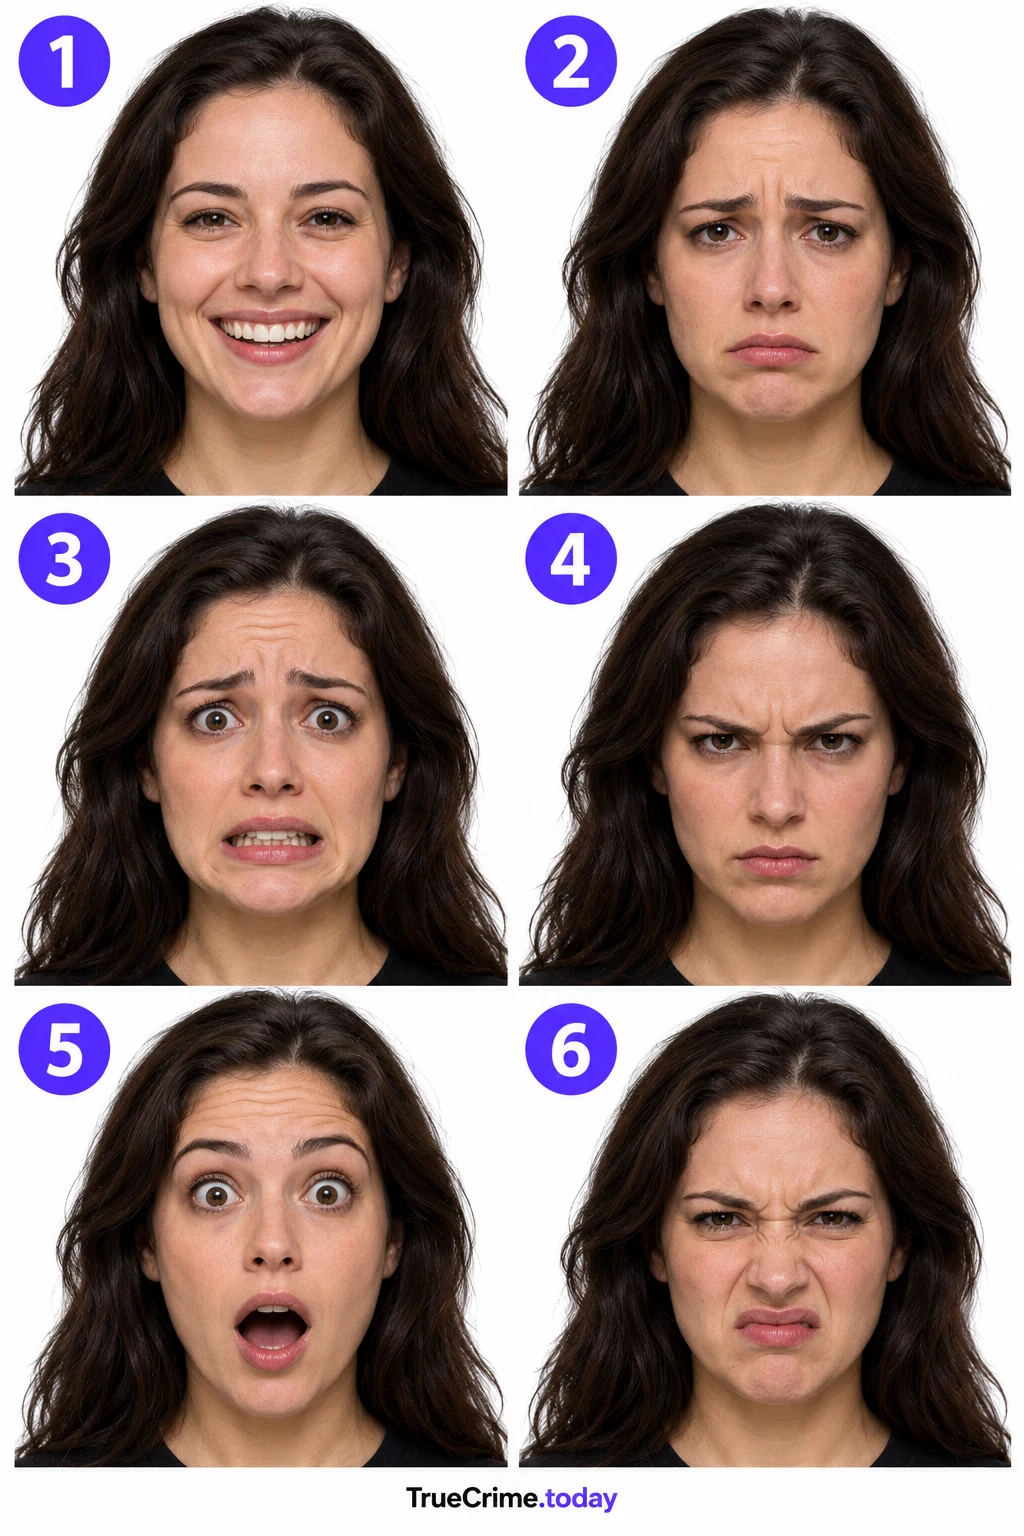
Nei dati di Du, le combinazioni ricorrenti comprendevano 12 + 25 per gioia, 4 + 15 per tristezza, 1 + 4 + 20 + 25 per paura e 4 + 7 + 24 per rabbia. AU25 separa le labbra, AU20 le tende lateralmente, AU7 contrae le palpebre e AU24 preme le labbra.
Per sorpresa compariva 1 + 2 + 25 + 26; per disgusto 9 + 10 + 17. Qui AU26 abbassa la mandibola, AU9 arriccia il naso, AU10 solleva il labbro superiore e AU17 il mento. La figura è un’approssimazione didattica: non dimostra l’esatta presenza o assenza di ogni azione come farebbe una codifica controllata.
Quando una variante compare solo in parte del campione
Anche nelle pose richieste c’era variabilità. AU6 era presente nel 51% delle pose di gioia; AU1 nel 60% di quelle di tristezza; AU5 nel 66% di quelle di sorpresa. Gli autori includevano nella combinazione ricorrente le azioni presenti in oltre il 70% dei partecipanti della categoria.
Queste percentuali descrivono quel materiale e quella consegna. Non sono la probabilità che una persona provi gioia quando le guance si sollevano. La domanda inversa richiederebbe informazioni sui movimenti in altri stati e contesti.
Non funziona neppure l’inversione più sbrigativa: se il sollevamento delle guance manca, allora il sorriso è una bugia. Una caratteristica che non compare in tutte le pose riconoscibili non diventa obbligatoria per ogni sentimento nella vita reale.
Quattro differenze intorno agli occhi
Ora isola le parti superiori del volto. AU1 solleva la porzione interna delle sopracciglia; AU2 quella esterna. AU4 le abbassa e le avvicina. AU5 solleva la palpebra superiore: un occhio più aperto non coincide necessariamente con un sopracciglio più alto.
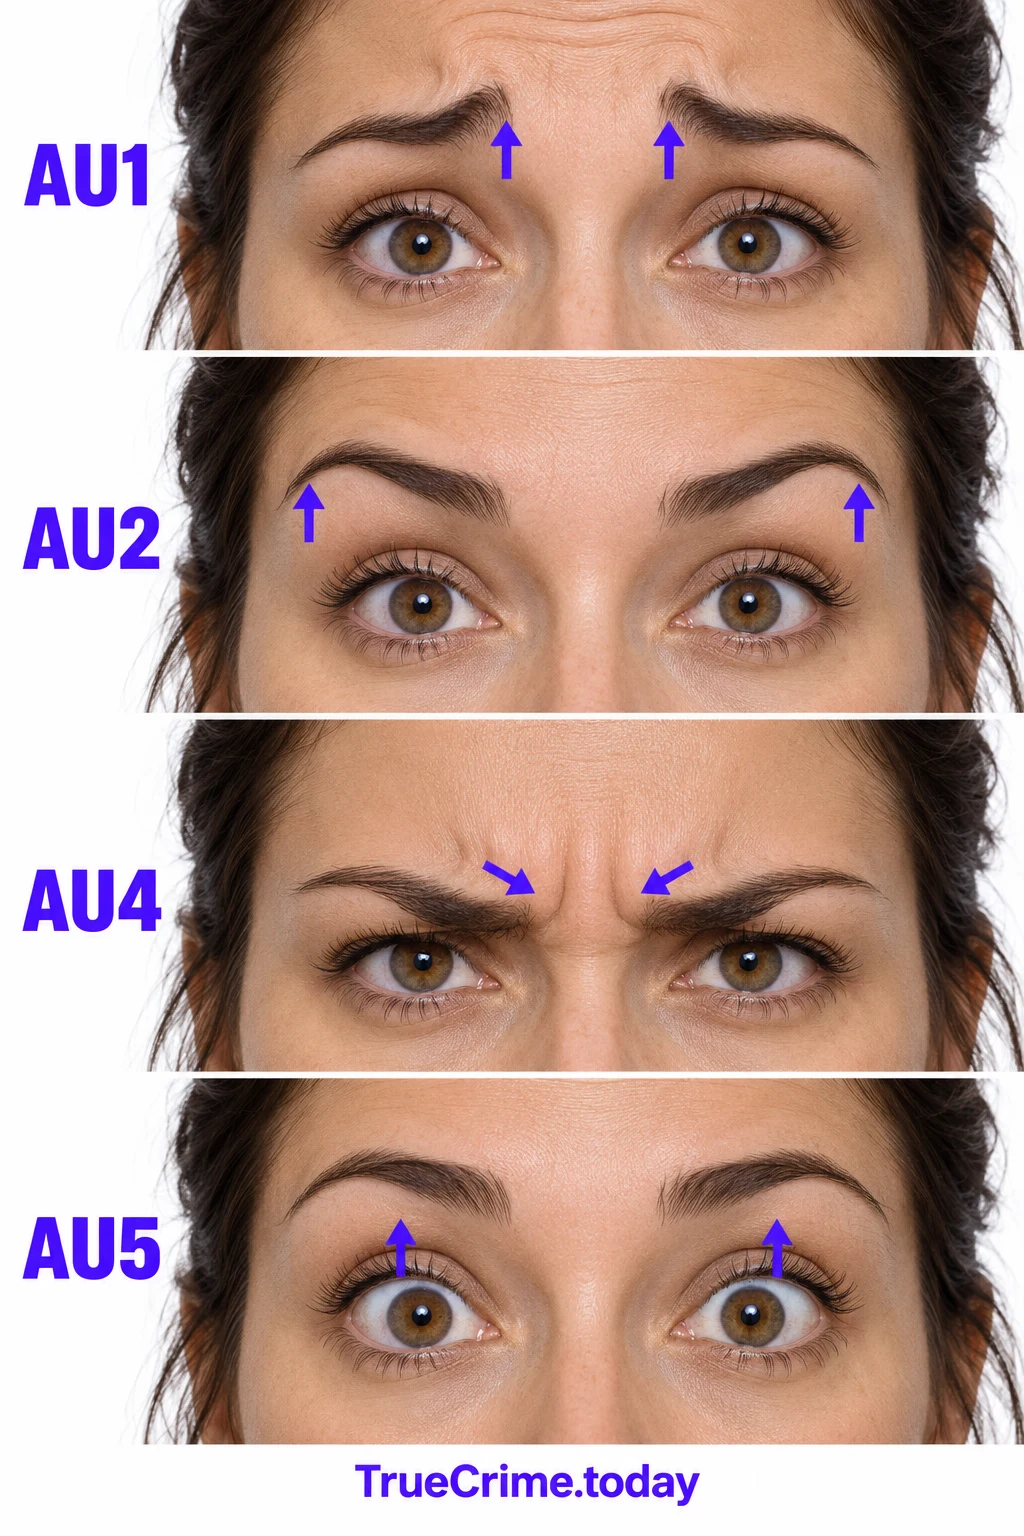
Questa scomposizione aiuta a capire perché un solo elemento non identifica tutta la posa. Un sopracciglio può cambiare posizione senza che la bocca segua lo stesso schema. Per osservare una variazione occorre inoltre confrontarla con il viso iniziale, non soltanto con una faccia ideale a riposo.
Le immagini sono prodotte con IA e non sostituiscono il manuale. In una registrazione sfocata può essere più corretto lasciare un dubbio che scegliere una AU con una precisione non sostenuta dai pixel disponibili.
Che cosa contengono davvero 130 815 fotogrammi
La base DISFA del 2013 registrò 27 adulti, con 4 845 fotogrammi per persona. Il prodotto è 130 815 fotogrammi. Dodici azioni furono annotate su una scala ordinata da 0 a 5; un secondo codificatore valutò i filmati di dieci partecipanti.
La concordanza di intensità, misurata con ICC, variava da 0,80 a 0,94 fra le azioni. Non è l’80–94% di bugie riconosciute. Il dato sostiene un uso concreto della FACS: ottenere descrizioni confrontabili del movimento nelle condizioni esaminate.
Mille immagini adiacenti di una persona non sono mille persone indipendenti. Se un modello vede alcuni fotogrammi durante l’apprendimento e viene valutato sui vicini, il risultato non mostra ancora come funzionerà su un volto sconosciuto. Per interpretare un punteggio bisogna sapere come sono stati separati i partecipanti.
La forza di un movimento non misura la sincerità
L’intensità visibile può essere registrata con i livelli A–E. Sono livelli ordinati, non quantità equivalenti di sentimento. Un’azione al livello E non esprime cinque volte più intenzione di una al livello A. Anche l’assenza va distinta da un’azione debole.
Nel materiale annotato per intensità della base GFT del 2017, le proporzioni A–E erano 42%, 39%, 15%, 3% e 1%. A e B insieme erano 81%. La base comprendeva 96 persone in 32 gruppi di tre e 172 800 fotogrammi; venti azioni erano codificate per presenza e cinque per intensità.
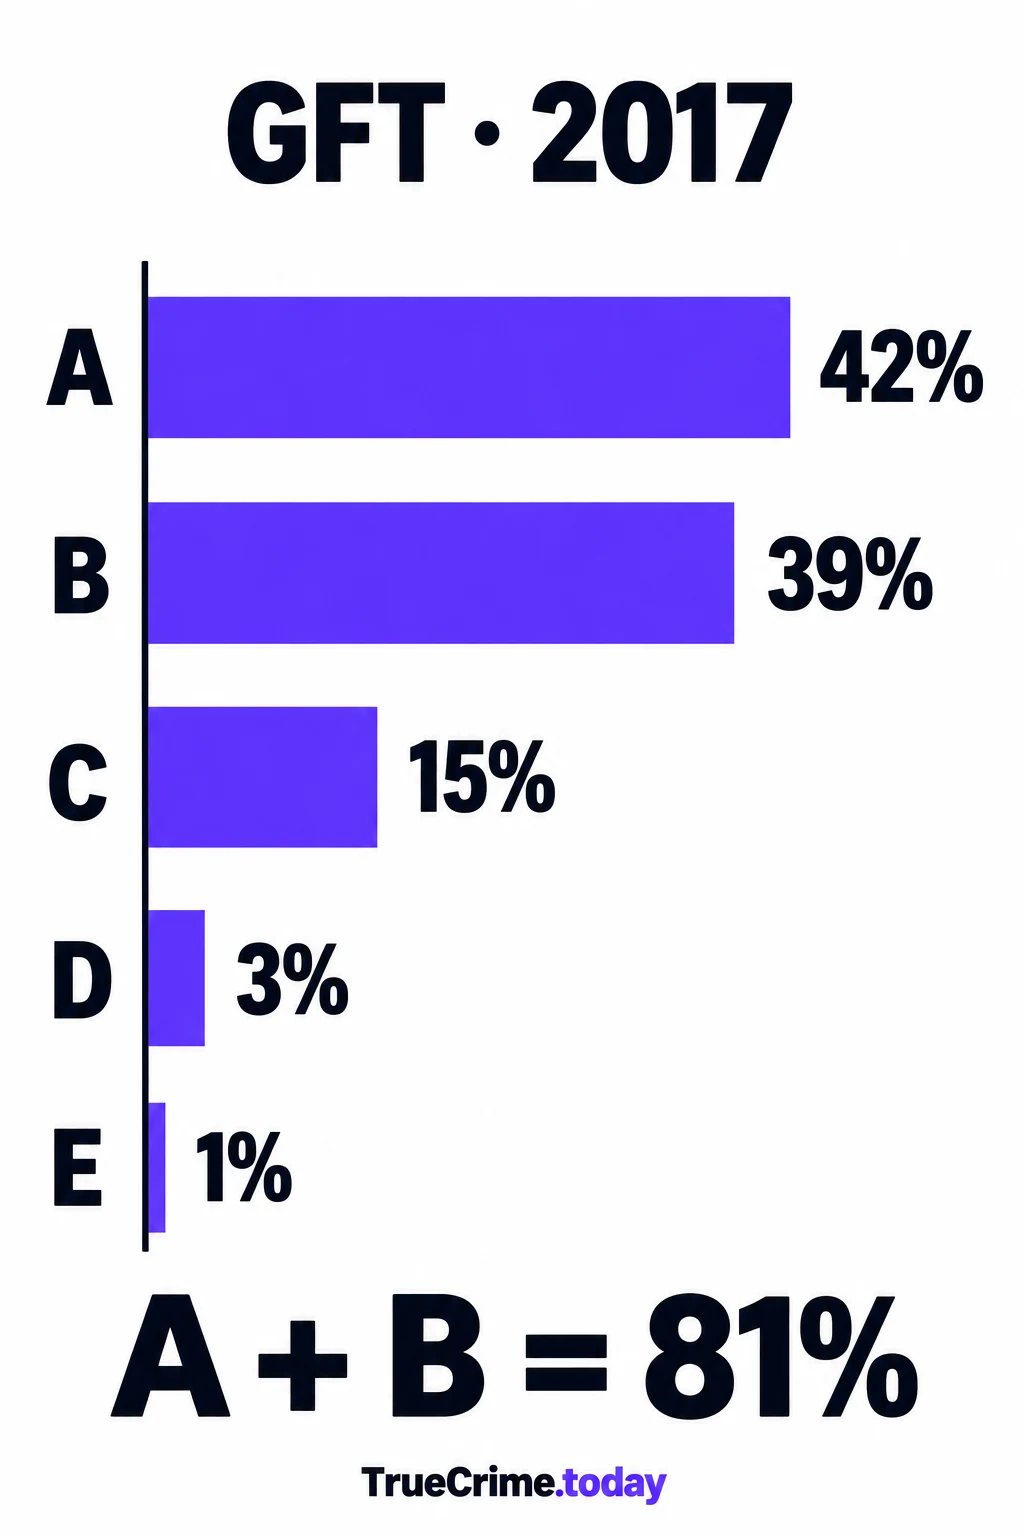
Il campione era selezionato, di giovani adulti, con condizioni alcol, placebo e controllo. Le quote non descrivono tutte le espressioni umane. Mostrano però perché le pose molto marcate non esauriscono ciò che una ricerca può dover annotare.
Un viso coperto non è un viso immobile
GFT lasciò senza codifica il 22% dei fotogrammi per ostruzione del volto. Una mano può impedire di vedere le labbra senza dire nulla sulla loro immobilità. “Non osservabile” e “non presente” sono due risultati diversi.
Questo vale anche per un’uscita automatica. Se un microfono copre gli angoli della bocca, un punteggio di assenza richiede cautela. Un sistema non dovrebbe inventare una zona immobile dove manca l’immagine.
La revisione di Barrett e colleghi del 2019 distingue inoltre la ripetibilità di una descrizione dalla specificità di un’interpretazione emotiva. Due osservatori possono concordare su un movimento e sbagliare entrambi il motivo. La concordanza è utile, ma non misura un sentimento che nessuno ha verificato separatamente.
I risultati sulle culture rispondono a domande diverse
Cowen e colleghi analizzarono sei milioni di video di 144 paesi, considerando sedici tipi di espressioni. Il 70% di conservazione delle associazioni tra contesto ed espressione fra dodici regioni è un risultato positivo sui pattern condivisi, non una precisione del 70% nel leggere sentimenti individuali.
Jack e colleghi, nel 2012, chiesero a quindici osservatori dell’Europa occidentale e quindici cinesi dell’Asia orientale di classificare ciascuno 4 800 animazioni. Le differenze trovate riguardano le rappresentazioni di quei gruppi nella prova, non ogni individuo di una cultura.
Contare i video o le risposte non basta per decidere quale studio “vince”. Una ricerca esamina associazioni nei video, l’altra interpretazioni di movimenti generati. Per la faccia concreta che stai guardando, resta da capire il contesto dell’espressione.
Che cosa manca a un fermo immagine
A 25 fotogrammi al secondo, quattro intervalli occupano 160 millisecondi. Fra l’istante del primo e quello del quarto fotogramma ci sono tre intervalli, 120 millisecondi. È un calcolo illustrativo sul campionamento: non definisce una microespressione né una soglia di verità.
Il movimento può essere iniziato fra due immagini o proseguire da una fase precedente della conversazione. Un taglio può eliminare il saluto o la battuta che lo ha preceduto. Il rallentatore aiuta a osservare ciò che è registrato, non recupera ciò che manca.
Per i programmi, chiedi anche che cosa rappresenta il valore mostrato: un’intensità, una classe o un punteggio interno? Un numero di 0,8 non è necessariamente una probabilità verificata dell’80% di paura. Nemmeno una stima emotiva corretta risolverebbe la verità di una data o di una cifra.
Un’annotazione che lascia spazio alla verifica
Conserva il punto della registrazione, la zona che cambia e ciò che succede intorno. Distingui ciò che si vede da ciò che si ipotizza. Se la qualità non consente una scelta affidabile, dillo.
La FACS offre un lessico utile per confrontare osservazioni e formulare domande migliori. Quanto più seria è la conclusione su una persona, tanto più le prove devono riguardare proprio il sentimento, la conoscenza o l’atto attribuito. Il dettaglio del viso è una parte della verifica, non il suo sostituto.
Puoi fare una domanda su uno studio o su un’affermazione relativa ai movimenti del viso. Non inviare registrazioni private né documenti personali.
Chiedere delle ricerche sulla mimica