Wie zuverlässig sind Lügendetektoren, Hirnscans und KI?
Was misst ein Lügendetektor? Studien zu Polygraph, P300, Hirnscans und KI erklären Treffer, Fehlalarme und den Unterschied zwischen Wissen und Schuld.
TL;DR
Zur Zuverlässigkeit eines Lügendetektors gehört mehr als eine hohe Trefferquote. Du brauchst die untersuchte Aufgabe, eine unabhängige Feststellung der richtigen Antwort und die vollständigen Fehlerzahlen. Unentschiedene Ergebnisse gehören dazu.
Polygraphen erfassen körperliche Reaktionen. P300-Tests untersuchen unter anderem das Wiedererkennen von Informationen; funktionelle Hirnscans messen andere Signale. KI ordnet Material anhand vorgegebener Kategorien ein. Für einige Verfahren gibt es günstige Versuchsergebnisse. Daraus folgt keine allgemeine Wahrheitsprüfung für unbekannte Menschen.
Für wen gilt die hohe Trefferquote?
Eine Vorführung verspricht, Lügen mit beeindruckender Genauigkeit zu erkennen. Du siehst ein Diagramm und möchtest wissen, ob du dem Ergebnis vertrauen kannst. Die erste Frage lautet aber: Wem gehörten die Daten, mit denen diese Zahl zustande kam?
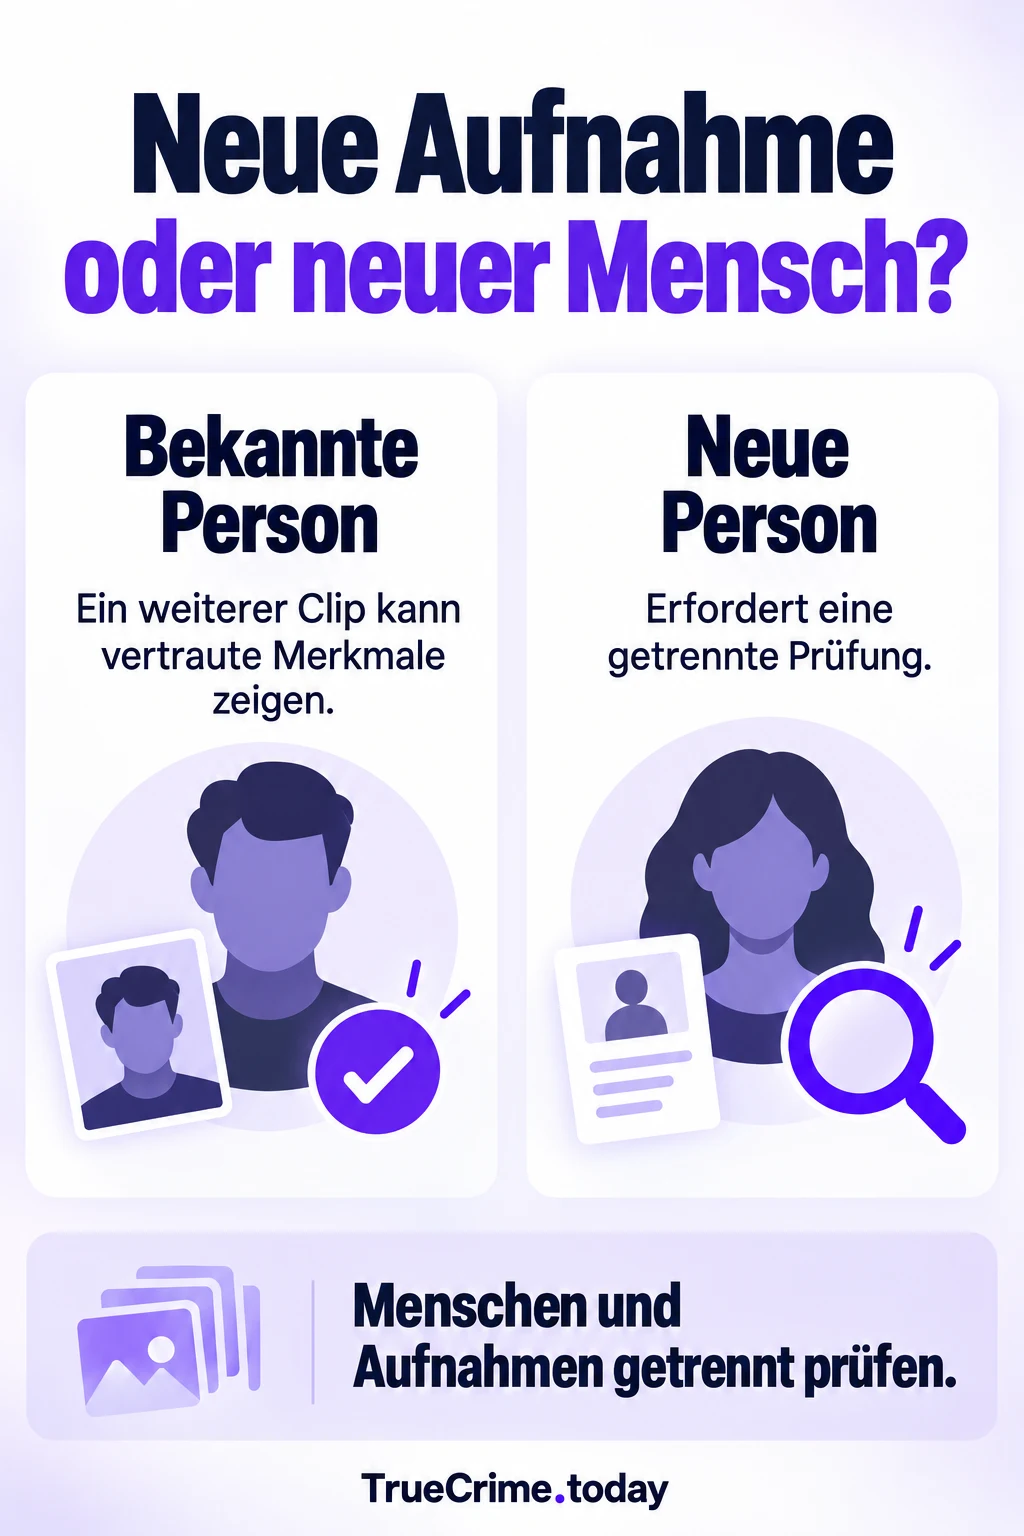
Ein Modell kann mit bekannten Personen oder Aufnahmesituationen gut zurechtkommen. Ob es bei einem neuen Menschen funktioniert, ist eine weitere Frage. Eine andere Aufnahme derselben Person beantwortet sie noch nicht.
Bei der Forschung zum Erkennen von Lügen müssen Messung, Interpretation und tatsächlicher Ablauf getrennt werden. Selbst eine fehlerfreie Aufzeichnung kann mit einer falschen Erklärung verbunden sein. Das ist bei einer technischen Kurve ebenso möglich wie bei einer auffälligen Pause.
Suchotzki und Gamer benannten in einer Forschungseinordnung der Universität Würzburg von 2024 Probleme mit Nachvollziehbarkeit, Verzerrungen und theoretischer Begründung von KI-Verfahren. Unabhängige Prüfungen und geeignete Daten sollen zeigen, ob eine Anwendung mehr leistet als eine überzeugende Demonstration.
Die hier besprochenen Forschungsarbeiten haben wir zuletzt am 19. Oktober 2026 geprüft.
Warum eine KI-Erklärung noch kein Beleg ist
Ein Programm kann eine Aussage als falsch einstufen und danach einen gut lesbaren Grund nennen: zu vage, zu zögerlich, zu stark betont. Dadurch entsteht leicht der Eindruck einer zweiten Bestätigung. Tatsächlich kann der Text dieselbe falsche Einordnung nur ausführen.
Eine ACL-Untersuchung von 2025 fand durch zusätzliches Begründen keine durchgängige Verbesserung. In der Fehleranalyse wurden auch Unsicherheit und stockende wahre Aussagen als Täuschung interpretiert. Die Begründung musste also ebenfalls überprüft werden.
Wenn du einen True-Crime-Fall recherchierst, brauchst du deshalb einen überprüfbaren Widerspruch. Eine zutreffend beschriebene Pause ist noch kein Widerspruch zwischen Aussage und Ereignis. Zuerst muss geklärt werden, ob die Erklärung des Programms überhaupt zum vollständigen Material passt.
Das gleiche Problem tritt bei anderen Messverfahren auf: Ein Ergebnis braucht eine nachvollziehbare Verbindung zur behaupteten Tatsache. Mehr Fachbegriffe schließen diese Lücke nicht.
Was der Polygraph tatsächlich aufzeichnet
Ein herkömmlicher Polygraph erfasst etwa Atmung, Herz-Kreislauf-Reaktionen und Hautleitfähigkeit. Die Auswertung vergleicht Reaktionen innerhalb eines bestimmten Frageverfahrens. Das Gerät zeichnet keine unwahre Aussage als eigenen körperlichen Stoff auf.
EEG misst elektrische Aktivität an der Kopfoberfläche. Die P300 ist ein Bestandteil einer ereignisbezogenen Reaktion auf einen Reiz. Bei der funktionellen MRT werden dagegen Veränderungen untersucht, die mit der Sauerstoffversorgung des Blutes zusammenhängen.
Diese Verfahren messen verschiedene Vorgänge. Ein Hirnbild ist nicht automatisch näher an der Wahrheit als eine Atemkurve. Entscheidend ist, welche Schlussfolgerung die jeweilige Untersuchung tatsächlich geprüft hat.
Eine Metaanalyse zu P300-Tests von 2025 liefert günstige experimentelle Befunde für das Erkennen verborgener Informationen. Sie betrifft eine festgelegte Aufgabe und ein Signal, keine allgemeine Freigabe beliebiger Gehirnanalysen.
Die Fragen gehören zum Messverfahren
Beim Vergleichsfragentest, dem CQT, werden Reaktionen auf unterschiedliche Fragekategorien gegenübergestellt. Es genügt nicht, die stärkste Reaktion aus einer Aufnahme herauszuschneiden. Wortlaut, Ablauf und Auswertungsregel gehören zum Verfahren.
Der Concealed Information Test, kurz CIT, untersucht eine andere Frage: Reagiert jemand auf ein möglicherweise bekanntes Detail anders als auf Alternativen? Damit lässt sich unter geeigneten Bedingungen Wissen untersuchen. Die Herkunft dieses Wissens ist noch offen.
Eine Person kann eine Tatortaufnahme aus einem Bericht kennen oder ein Detail bei einer früheren Befragung erfahren haben. Wer das übersieht, macht aus Wiedererkennen vorschnell Tatbeteiligung.
Auch die Trennung der Testdaten gehört dazu. Wenn Aufnahmen derselben Person bei Entwicklung und Prüfung auftauchen, können Stimme, Bildhintergrund oder Aufnahmebedingungen helfen. Für das Versprechen, neue Menschen beurteilen zu können, muss genau diese Situation geprüft werden.
Wenn Unentschieden aus der Rechnung verschwinden
Ein Ergebnis ohne eindeutige Entscheidung kann sachgerecht sein. Es sollte dann sichtbar bleiben. Andernfalls kann die Genauigkeit steigen, weil schwierige Antworten aus dem Nenner entfernt werden.
Uchaev und Apanovich untersuchten 2023 zwei getrennte Gruppen mit jeweils vierzig Personen. Eine herzfrequenzbasierte Klassifikation erreichte in der zweiten Aufgabe zunächst 72,4%. Nach Einführung eines Unsicherheitsbereichs wurden 74,5% bei 9,2% unentschiedenen Antworten berichtet.
Das waren wiederholte Antworten innerhalb eines Experiments, keine Erfolgsquote für beliebige neue Personen. Die höhere Zahl beschreibt die Entscheidungen, die das Modell unter der geänderten Regel noch traf.
Du brauchst deshalb beide Angaben: Wie viele Antworten wurden richtig eingeordnet, und wie viele erhielten gar keine eindeutige Einordnung? Ein Verfahren muss nicht überall entscheiden. Seine Darstellung sollte aber zeigen, wo es aufhört.
Wie aus guten Einzelwerten viele Fehlalarme werden
Ein eigenes gedachtes Beispiel zeigt einen zweiten Nennerfehler. Angenommen, 5.000 Menschen werden untersucht; fünfzig kennen eine geschützte Information. Wir nehmen eine Sensitivität von 90% und eine Spezifität von 98% an. Alle erhalten eine eindeutige Antwort.
Von den fünfzig Wissenden werden 45 erkannt und fünf übersehen. Von den 4.950 anderen lösen zwei Prozent einen Fehlalarm aus: 99 Menschen. Bei 4.851 wird richtigerweise kein Alarm ausgelöst.
Damit stimmen 45 von insgesamt 144 Alarmen, also rund 31,3%. Das widerspricht den angenommenen Einzelwerten nicht. Es gibt sehr viele Menschen ohne das gesuchte Wissen und nur wenige mit ihm.
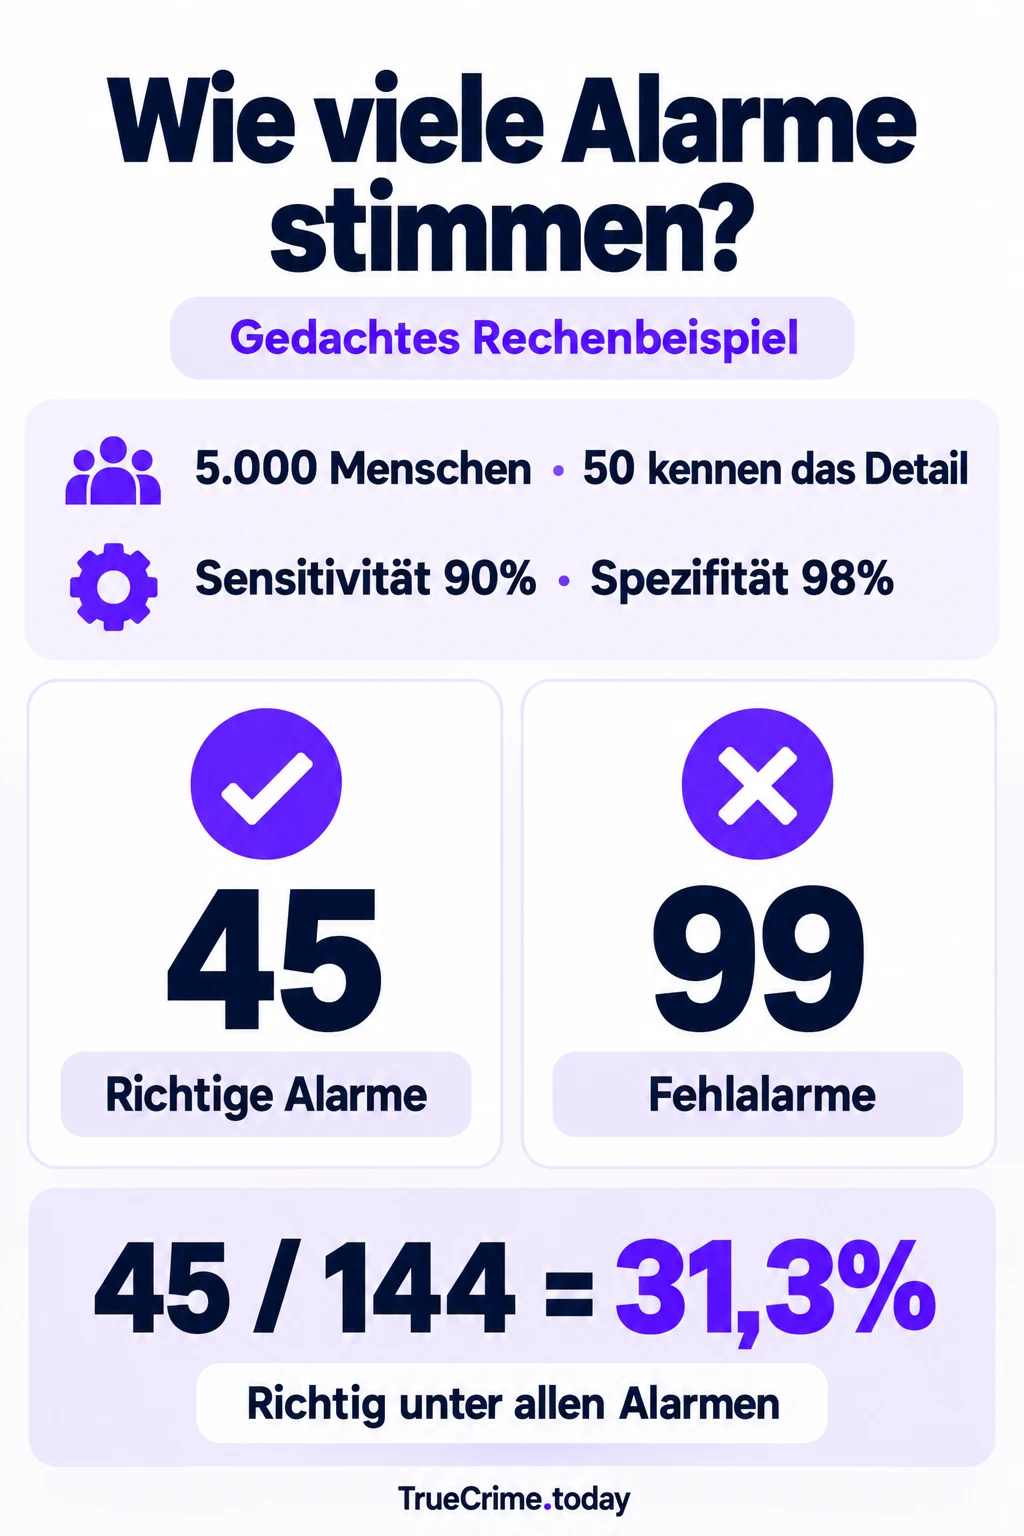
Die Rechnung beschreibt kein gemessenes Gerät. Sie setzt auch Wissen nicht mit Schuld gleich. Sie erklärt, warum die Frage nach einem Alarm eine andere ist: Wie viele der gemeldeten Fälle sind wirklich Treffer? Dazu brauchst du auch die Häufigkeit dessen, wonach gesucht wird.
Was ein Wiedererkennen erklären kann
Ein geschütztes Detail kann einen CIT interessant machen. Wenn uninformierte Personen es nicht von den Alternativen unterscheiden können, liefert eine abweichende Reaktion möglicherweise einen Anlass für weitere Überprüfungen.
Dafür muss das Detail tatsächlich geschützt geblieben sein. Öffentlich zugängliche Fotos, Gespräche oder frühere Fragen können eine andere Erklärung schaffen. Umgekehrt ist ein ausbleibendes Wiedererkennen nicht automatisch der Beweis, dass ein Ereignis nie erlebt wurde.
Meijer und Kollegen fanden 2014 in ihrer CIT-Metaanalyse positive Effekte verschiedener physiologischer Maße. Der Vorteil von P300 gegenüber Hautleitfähigkeit zeigte sich bei persönlichen Informationen, nicht beim Vergleich mit simulierten Straftaten.
Das macht die Aufgabe wichtig. Die Reaktion auf den eigenen Namen ist nicht ohne Weiteres auf eine Erinnerung an einen komplexen Vorgang übertragbar. Eine Methode kann eine Aufgabe gut erfassen und für eine andere noch unzureichend geprüft sein.
54 Studien zur P300: Was das positive Ergebnis bedeutet
Knappe, Ullsperger und Kirschner berichteten 2025 für 54 experimentelle Studien einen mittleren Effekt von d = 1,59*. Das ist ein standardisiertes Unterschiedsmaß. Es ist weder eine Trefferquote von 159% noch von 59%.
Die Art des Versuchs, das Testprotokoll und absichtliche Beeinflussungsversuche veränderten die Ergebnisse. Die Autoren bewerten das komplexe Versuchsprotokoll günstig. Diese Bedingungen gehören zur Aussage über das Verfahren.
Alle eingeschlossenen Untersuchungen fanden unter kontrollierten Laborbedingungen statt. Viele Stichproben bestanden aus jungen gesunden Erwachsenen. Die Übertragbarkeit auf vielfältigere Personengruppen und echte Untersuchungsbedingungen bleibt eine Aufgabe für weitere Forschung.
Es wäre unfair, den positiven Effekt zu ignorieren. Ebenso unfair wäre es gegenüber einer untersuchten Person, aus diesem Effekt eine verlässliche individuelle Schuldzuweisung zu machen. Die Zahlen rechtfertigen eine engere, überprüfbare Schlussfolgerung.
Das perfekte Teilergebnis im Hirnscanner
Langleben und Kollegen verglichen 2016 funktionelle MRT und Polygraph bei 28 Personen, die eine geschriebene Zahl zwischen drei und acht verbergen sollten. Je drei Fachleute pro Verfahren beurteilten die Aufzeichnungen, ohne die Zahl zu kennen.
Für die MRT-Auswertung wurde ein relatives Verhältnis richtiger Erkennungen von 1,24 gegenüber dem Polygraphen berichtet. Das bedeutet keine Verbesserung um 24 Prozentpunkte. Bei einer ausgewählten Gruppe von siebzehn Personen, die eine Übereinstimmungsbedingung erfüllten, ergab die Kombination hundert Prozent richtige Ergebnisse.
Die Auswahlbedingung darf bei der Wiedergabe nicht verschwinden. Siebzehn erfolgreiche ausgewählte Fälle sind kein fehlerfreier Test bei allen 28. Interessant ist auch, wie häufig die Kombination überhaupt eine gemeinsame Entscheidung erlaubt.
Die Aufgabe blieb zudem eine verborgene Zahl. Ein offenes Gespräch über ein Ereignis stellt andere Anforderungen. Ein gutes Laborexperiment beantwortet nicht alle Fragen, die ein eindrucksvoller Titel daran anschließt.
Drei Datensätze sind drei verschiedene Aufgaben
Die ACL-Arbeit von 2025 nutzte 121 Gerichtsausschnitte, 320 Videos mit angewiesener zwischenmenschlicher Täuschung und 1.600 Hotelbewertungen. Eine bestimmte GPT-4o-Konfiguration erreichte gerundet 79,6%, 55,1% und 71,9% Genauigkeit.
Die Werte hängen an dieser Konfiguration und den englischsprachigen Aufgaben. Sie sind keine aktuelle Produktgarantie und kein Nachweis für die Einordnung eines deutschsprachigen Gesprächs. Ein Unterschied zwischen den Aufgaben kann größer sein, als eine gemeinsame Bezeichnung „Lügenerkennung“ vermuten lässt.
Auch die Referenz ist verschieden. Der Ausgang eines Verfahrens beweist nicht jeden Satz einer Gerichtsaufnahme. Bestellte erfundene Bewertungen können sich außerdem in ihrer Entstehung von echten unterscheiden.
Mehr Eingabekanäle oder längere Begründungen lösen das nicht automatisch. Entscheidend bleibt eine unabhängige Prüfung unter den Bedingungen, für die das System eingesetzt werden soll.
Der Schrank im Serverraum
Stell dir einen erfundenen Einbruch vor. Eine Untersuchung deutet darauf hin, dass jemand die Farbe eines Schranks im Serverraum kennt. Daraus wird die Behauptung, nur die einbrechende Person könne das wissen.
Dann tauchen Unterlagen einer früheren Brandschutzunterweisung auf. Auf einem Foto ist der Schrank zu sehen. Die untersuchte Person hatte diese Unterlagen erhalten.
Das Wiedererkennen kann richtig gewesen sein. Die Erklärung seiner Herkunft war zu eng. Als Nächstes müsste geprüft werden, wer die Unterlagen wann erhalten hat und was darauf erkennbar war.
Eine erneute Betonung des starken Signals würde diese Frage nicht beantworten. Gute Auswertung sucht auch nach Erklärungen, die eine Person entlasten, und vergleicht sie mit Zugang, Zeitpunkt und sonstigen Spuren.
Was du von einem Prüfbericht erwarten darfst
Lass dir die genaue Aufgabe und die ursprüngliche Ergebnisformulierung zeigen. Danach zählt, wie die richtige Antwort unabhängig festgestellt wurde. Eine nachträgliche Aussage darf nicht unbemerkt die einzige Bestätigung eines zuvor angezeigten Verdachts werden.
Zur vollständigen Darstellung gehören Treffer, übersehene Fälle, Fehlalarme, richtige negative Entscheidungen und unentschiedene Ergebnisse. Prüfe, ob Personen, Antworten, mehrfach bewertete Aufzeichnungen oder ausgewählte Untergruppen gezählt wurden.
Eine neue Anwendung braucht neue Personen und passende Bedingungen. Frage nach Datenaufteilung, Schwellenwerten und Prüfungen außerhalb des Entwicklungsmaterials. Eine genaue Kurve ersetzt das nicht.
So lässt sich ein interessanter Befund ernst nehmen, ohne ihn mit mehr Bedeutung zu belasten, als untersucht wurde. Die offene Frage ist dann konkret genug, um sie mit weiteren Tatsachen zu prüfen.
Du kannst eine Frage zu Polygraphen, Gedächtnistests oder einer KI-Genauigkeitsangabe stellen. Schicke keine privaten Testergebnisse, Aufnahmen, Pässe, Verträge, Bankdaten oder anderen persönlichen Dokumente.
Frage zu Lügendetektoren stellen