Macchina della verità: quanto sono affidabili i test?
Dai sensori del poligrafo ai test P300 e all’IA: risultati degli studi, falsi allarmi e domande da fare prima di considerare una misura una prova.
TL;DR
La macchina della verità non certifica la verità di un’intera storia. Il poligrafo registra reazioni fisiologiche; alcuni test cerebrali cercano risposte legate al riconoscimento di informazioni; l’IA classifica materiale in base a categorie definite in precedenza. Per capire un risultato servono compito, errori e casi rimasti senza conclusione.
Esistono risultati sperimentali favorevoli. Non danno però un’unica percentuale applicabile a qualsiasi persona e situazione. Riconoscere un dettaglio, inoltre, non spiega ancora come lo si è conosciuto né quale azione sia stata compiuta.
Una promessa molto più grande dello strumento
«Macchina della verità» è un nome che sembra rispondere prima ancora di spiegare. Tu senti parlare di un esame superato e immagini che il dubbio sia finito. Ma quale dubbio? La conoscenza di un luogo, una frase su un episodio, un racconto completo?
Il nome nasconde una storia di misure e interpretazioni. La collezione di psicologia sperimentale dell’Università di Padova conserva strumenti legati alle ricerche di Vittorio Benussi, compresa una fascia per studiare i ritmi respiratori. Misurare il respiro aveva un significato sperimentale; l’esistenza dello strumento non stabilisce da sola quanto bene si riconosca una bugia.
Anche oggi, per riconoscere le bugie, bisogna collegare ciò che si misura a una risposta verificata in modo indipendente. Un sensore più preciso può registrare meglio un fenomeno senza eliminare le spiegazioni alternative.
L’ultima volta che abbiamo controllato le ricerche discusse qui è stato il 19 ottobre 2026.
Il respiro si misura, il significato si deve verificare
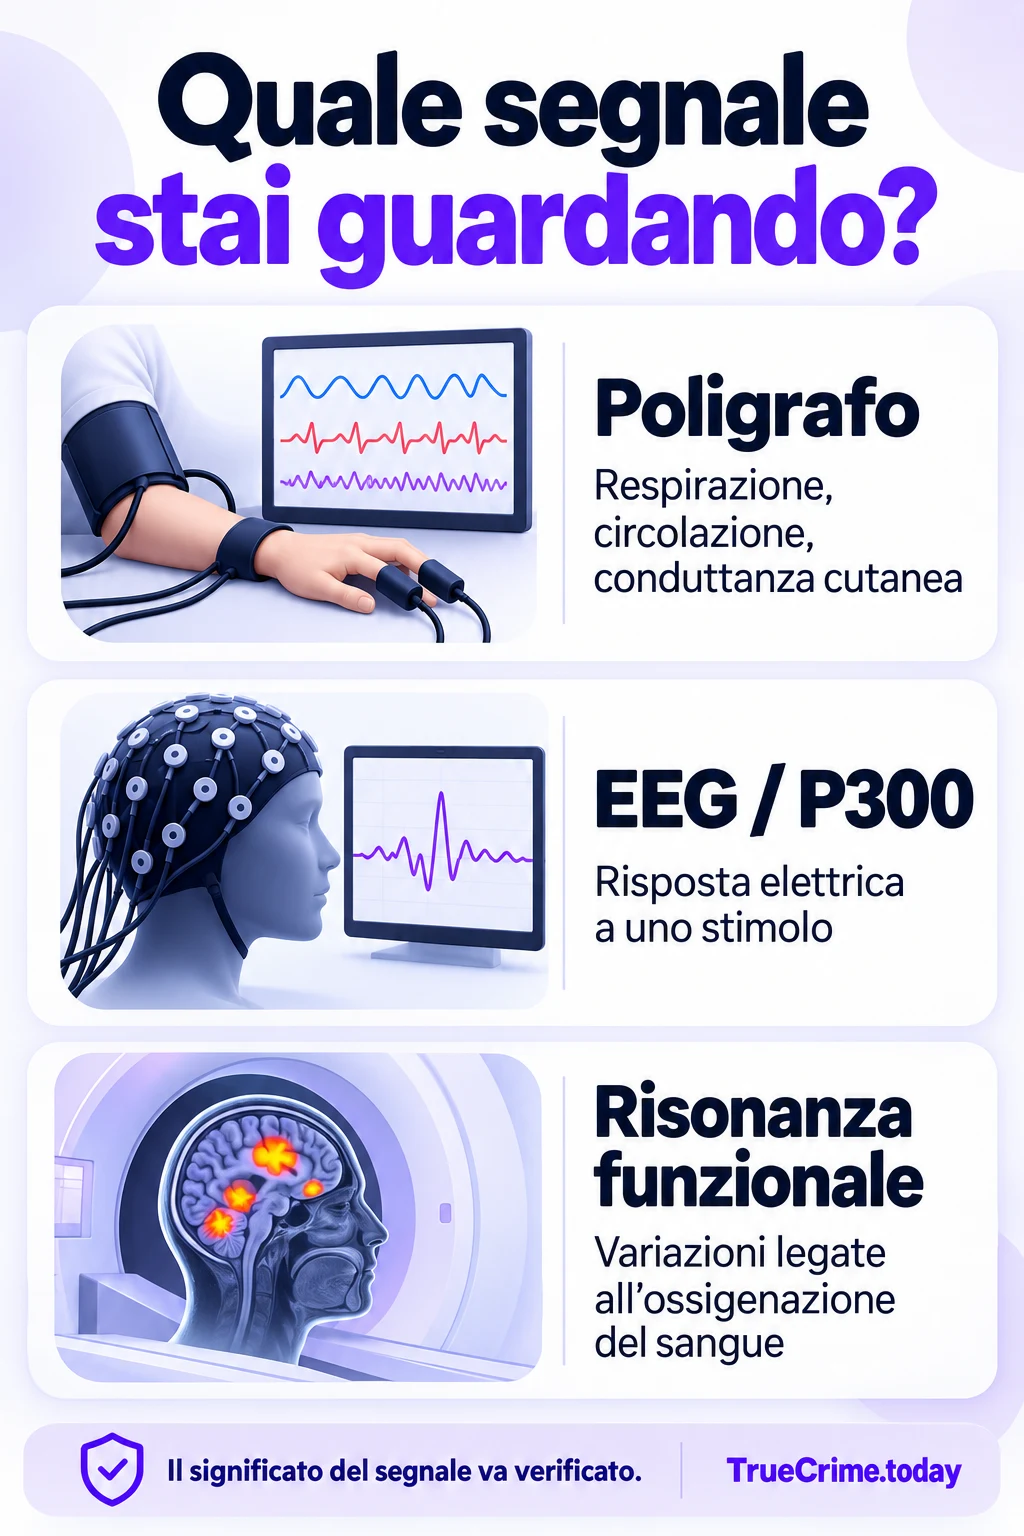
Un poligrafo convenzionale registra respirazione, attività cardiovascolare e conduttanza cutanea. L’interpretazione confronta reazioni durante una procedura di domande. Non esiste una traccia che riporti direttamente una proposizione falsa.
L’elettroencefalogramma, o EEG, rileva attività elettrica sulla superficie della testa. La P300 è una componente della risposta alla presentazione di uno stimolo. La risonanza magnetica funzionale rileva invece variazioni legate all’ossigenazione del sangue.
Una mappa colorata rappresenta di solito un confronto statistico tra condizioni. Non mostra una frase nascosta nella mente. Una regione attiva durante un compito non diventa per questo una zona esclusiva della menzogna.
La distinzione conta anche per l’IA. Il programma può classificare testo, voce o video, ma deve ricevere esempi con etichette. Non acquisisce un accesso indipendente ai fatti solo perché dispone di più dati.
Quale domanda viene davvero messa alla prova?
Il test delle domande di confronto, o CQT, paragona reazioni a categorie di domande. Formulazione, ordine e regole di valutazione sono parte del metodo. Isolare il picco più evidente di una registrazione non basta per riprodurlo.
Il test dell’informazione nascosta, o CIT, cerca invece una risposta diversa davanti a un dettaglio potenzialmente noto, presentato fra alternative. La domanda riguarda il riconoscimento. Il passaggio dal sapere all’aver fatto qualcosa deve ancora essere giustificato.
Una metanalisi del 2025 sui test P300 trova risultati sperimentali favorevoli proprio in questo ambito. Per valutarli occorre conservare il compito studiato, senza estenderli a qualunque interrogatorio o racconto.
Nell’analisi di un caso di true crime, sapere dove si trovava un oggetto e averlo preso sono due affermazioni distinte. L’esame può offrire un elemento sulla prima senza dimostrare la seconda.
La conoscenza di un dettaglio ha più di una spiegazione
Un dettaglio tenuto davvero riservato può rendere interessante una prova di riconoscimento. Ma una foto pubblicata, una conversazione o una precedente domanda possono farlo conoscere anche a chi non ha partecipato all’azione.
Prima di attribuire un significato al segnale, bisogna ricostruire questa circolazione dell’informazione. Il sensore può aver funzionato bene e la conclusione essere comunque troppo ampia.
Anche un mancato riconoscimento richiede cautela. Il fatto che un test non trovi una differenza non dimostra automaticamente che la persona non abbia mai incontrato il dettaglio. Memoria, stimoli e criterio di decisione hanno i propri limiti.
Un confronto di Meijer e colleghi del 2014 trovava effetti positivi per varie misure del CIT. Il vantaggio medio della P300 rispetto alla conduttanza cutanea emergeva per elementi personali, non nel confronto con reati simulati. Riconoscere il proprio nome non riproduce ogni problema posto da un evento.
Che cosa aggiungono gli studi sulla P300
Knappe, Ullsperger e Kirschner hanno incluso nel lavoro del 2025 54 studi sperimentali, con una dimensione media dell’effetto di 1,59. Si tratta di una differenza standardizzata, non del 159% o del 59% di risposte corrette.
Il risultato variava con il tipo di compito, il protocollo e la presenza di tentativi deliberati di alterare la prova. Gli autori considerano favorevole il protocollo a prova complessa. Non basta quindi trovare la sigla P300 per assegnare a qualsiasi dispositivo la stessa prestazione.
Tutti gli studi inclusi si svolgevano in laboratorio. Le persone esaminate erano spesso giovani adulte e in buona salute. Gli autori chiedono verifiche su popolazioni e condizioni più vicine all’impiego forense.
Il dato favorevole merita spazio. Il limite non lo annulla: indica quale ricerca serve ancora. Una differenza fra condizioni sperimentali e la capacità di decidere correttamente su una nuova persona restano risultati diversi.
Un numero nascosto non è un intero racconto
Nel 2016 Langleben e colleghi confrontarono poligrafo e risonanza funzionale con 28 partecipanti che nascondevano un numero scritto fra tre e otto. Tre specialisti per ciascuna modalità valutarono le registrazioni senza conoscere il numero.
La rilevazione corretta favoriva gli specialisti della risonanza con un rapporto relativo di 1,24. Non è un vantaggio di 24 punti percentuali. Il lavoro riferiva inoltre un risultato combinato perfetto in un sottogruppo selezionato di diciassette persone, che soddisfaceva una condizione di concordanza.
Diciassette persone selezionate non coincidono con tutte e ventotto. Il criterio di selezione fa parte del risultato e deve accompagnarlo. Altrimenti scompare proprio la domanda su chi non riceve una decisione condivisa.
L’esperimento può suggerire un modo promettente di combinare misure. Non dimostra che la stessa procedura stabilisca la verità di una narrazione libera su un episodio complesso. Fra i due compiti c’è un trasferimento da verificare.
Le risposte sospese non spariscono
Un esame può terminare senza una conclusione. È una possibilità da tenere nel resoconto, anche quando si calcola la precisione delle decisioni rimaste. Escludere i casi difficili cambia il denominatore.
In un lavoro russo del 2023, Uchaev e Apanovich esaminarono due gruppi separati di quaranta persone. Nella seconda prova, una classificazione basata sul ritmo cardiaco passava dal 72,4% al 74,5% quando il 9,2% delle risposte restava in un’area d’incertezza.
Erano risposte ripetute, non ottanta casi risolti. Il numero successivo all’esclusione non dimostra che ogni persona riceverà una valutazione migliore. Descrive le decisioni prese con una regola diversa.
La sospensione del giudizio può essere sensata. Il problema nasce se il pubblico sente soltanto il valore più alto. Servono sia la quota di decisioni corrette sia quella di risposte per cui la decisione non c’è.
Due errori diversi dietro la stessa percentuale
Facciamo un calcolo ipotetico originale, senza attribuirlo a un apparecchio reale. Fra mille persone, cinquanta conoscono un dettaglio protetto. Supponiamo una sensibilità dell’80% e una specificità del 90%, con risposte binarie per tutti.
Vengono individuate quaranta delle cinquanta persone informate; dieci sfuggono. Fra le 950 che non conoscono il dettaglio, il dieci per cento riceve un falso allarme: 95 persone. Le altre 855 restano correttamente senza allarme.
In totale ci sono 135 allarmi, di cui quaranta corretti. Quaranta diviso 135 equivale a circa il 29,6%. La sensibilità dice quanto spesso si rileva ciò che è presente. La specificità dice quanto spesso non si segnala ciò che è assente. La proporzione di allarmi corretti dipende anche da quanto è frequente ciò che si cerca.
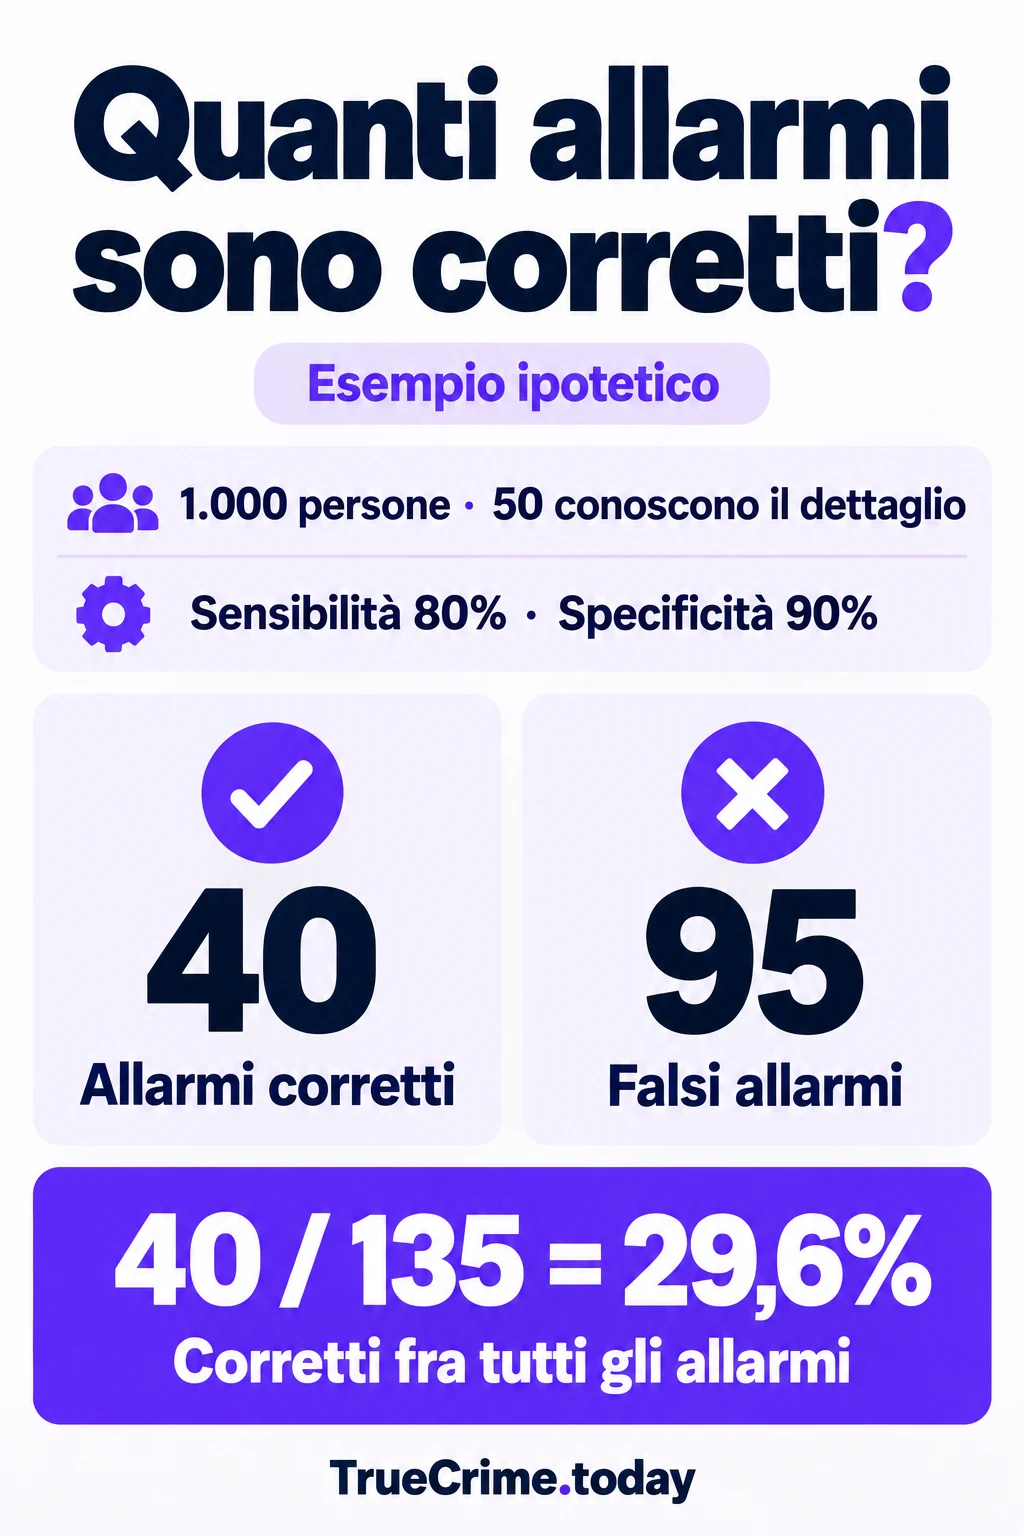
Il calcolo riguarda conoscenza, non colpevolezza. Una procedura reale con risultati incerti richiederebbe altri conteggi. La lezione è che un indice isolato non risponde automaticamente alla domanda: quanto posso credere a questo allarme?
Le prove favorevoli al poligrafo e le obiezioni
Il National Research Council concludeva nel 2003 che prove su singoli episodi potevano distinguere oltre il caso nelle popolazioni studiate, ma ben lontano dalla perfezione. Segnalava i limiti del trasferimento a controlli su grandi popolazioni.
La revisione professionale dell’American Polygraph Association del 2011 riporta circa l’89% di precisione delle decisioni e l’11% di esiti inconcludenti per tecniche riferite a un evento specifico. Le due cifre vanno conservate insieme. Non descrivono la probabilità che ogni frase di una persona sia vera.
Honts e colleghi presentarono nel 2021 una lettura favorevole del CQT su 138 insiemi di dati. Iacono e Ben-Shakhar, nella loro analisi critica del 2019, mantenevano obiezioni ai fondamenti e alla qualità dei dati sul campo.
Il disaccordo riguarda come si dimostra la prestazione: casi selezionati, riferimenti indipendenti e possibilità di generalizzare. Non si risolve facendo una media di percentuali che descrivono compiti diversi.
L’IA deve imparare da risposte già etichettate
Uno studio ACL del 2025 valutava modelli su 121 spezzoni giudiziari, 320 video di inganno assegnato per istruzione e 1.600 recensioni alberghiere. Una configurazione del GPT-4o otteneva circa il 79,6%, il 55,1% e il 71,9% di precisione nei tre insiemi.
I materiali erano in inglese. Le cifre descrivono quella configurazione, non la prestazione attuale di qualsiasi prodotto e neppure quella su un colloquio italiano. Le differenze fra compiti impediscono di usare una sola etichetta come garanzia generale.
Anche la spiegazione può ingannare. Nello stesso studio, generare ragionamenti non migliorava costantemente i risultati; incertezza e disfluenze di affermazioni vere potevano essere lette come inganno. Una giustificazione articolata non è una seconda prova.
Occorre inoltre separare le persone fra sviluppo e valutazione. Se la stessa voce compare nei due gruppi, il sistema potrebbe riconoscere l’identità o l’ambiente. Per promettere una prestazione su persone nuove bisogna metterlo alla prova proprio con persone nuove.
La custodia descritta nell’inventario
Immagina una scena inventata. Scompare uno strumento e un esame indica che una persona riconosce il colore della custodia. Qualcuno sostiene che solo chi l’ha sottratta poteva conoscere quel particolare.
Poi emerge un inventario inviato prima della scomparsa. La custodia è descritta e fotografata, e quella persona aveva ricevuto il documento. Il riconoscimento può essere corretto; la spiegazione esclusiva non regge più.
La verifica successiva riguarda data, destinatari e contenuto dell’inventario. La forza del segnale non distingue da sola fra conoscenza acquisita leggendo e conoscenza acquisita compiendo l’azione.
Un dettaglio davvero riservato potrebbe essere più informativo. Resterebbero comunque accesso, tempi e azioni da ricostruire. La buona interpretazione considera anche le ipotesi che allontanano un sospetto.
Prima di fidarti, ricostruisci il risultato
Parti dalla domanda precisa e dalla formulazione originale dell’esito. Cerca come è stata stabilita la risposta giusta in modo indipendente. Una dichiarazione ottenuta dopo il test può aprire verifiche, ma non dimostra da sola l’accuratezza dello strumento.
Conta rilevazioni corrette, omissioni, falsi allarmi, risultati negativi corretti e casi sospesi. Chiediti se l’unità sia una persona, una risposta ripetuta o un giudizio di più specialisti sulla stessa registrazione.
Per una nuova applicazione servono condizioni pertinenti e verifiche con persone nuove. Lingua, qualità del materiale, soglie e frequenza dell’evento ricercato non sono dettagli accessori.
Puoi così riconoscere un risultato interessante senza trasformarlo in una certificazione universale. La conclusione resta legata al fatto esaminato e indica quali controlli indipendenti potrebbero confermarla o cambiarla.
Puoi fare una domanda sul poligrafo, su un esperimento di riconoscimento o su una promessa dell’IA. Non inviare risultati privati, registrazioni, passaporti, contratti, dati bancari o altri documenti personali.
Fare una domanda sui rilevatori