Wykrywacz kłamstw: co naprawdę potrafią wariograf, badania mózgu i AI?
Jak ocenić wynik wariografu? Wyjaśniamy badania P300, rezonans i AI, błędy, wyniki nierozstrzygające oraz różnicę między rozpoznaniem a winą.
TL;DR
Wynik wykrywacza kłamstw nie potwierdza samodzielnie prawdziwości całej historii. Wariograf rejestruje reakcje fizjologiczne. Niektóre badania mózgu sprawdzają rozpoznawanie informacji, a AI klasyfikuje materiał według wcześniej przypisanych etykiet. Żeby ocenić wynik, musisz znać opis zadania, błędy i wyniki bez rozstrzygnięcia.
Istnieją korzystne wyniki eksperymentów. Nie dają jednak jednego odsetka trafności dla dowolnej osoby i sytuacji. Rozpoznanie szczegółu nie wyjaśnia jeszcze, skąd pochodzi wiedza i czy doszło do określonego działania.
Wariograf i poligraf: dwie nazwy, to samo pytanie
Czytasz, że wariograf potwierdził czyjąś wersję. W innym miejscu to samo urządzenie nazywa się poligrafem. Nazwa brzmi technicznie, ale nadal nie wiesz, jakie pytania zadano i co dokładnie oznaczał wynik.
Centralne Laboratorium Kryminalistyczne Policji opisuje poligraf jako urządzenie zapisujące zmiany oddychania, pracy serca i przewodnictwa skóry. Wskazuje różnicę między rejestracją reakcji na pytania a bezpośrednim wykrywaniem kłamstw. To opis pomiaru, nie gwarantowany odsetek trafnych ustaleń.
W wykrywaniu kłamstwa trzeba połączyć obserwację z niezależnie ustalonym faktem. Reakcja może zostać dokładnie zapisana, a przypisana jej przyczyna pozostawać niepewna. Dobry zapis nie naprawia błędnej interpretacji.
Ostatni raz sprawdzaliśmy badania omawiane w tym tekście 19 października 2026 roku.
Reakcja na pytanie nie podaje swojej przyczyny
Zwykły wariograf rejestruje kilka kanałów fizjologicznych. Ich porównanie odbywa się w ramach określonej procedury. Sam wzrost reakcji nie jest zapisaną fałszywą wypowiedzią.
EEG mierzy aktywność elektryczną z powierzchni głowy. P300 jest składnikiem odpowiedzi związanej z prezentacją bodźca. Funkcjonalny rezonans magnetyczny bada natomiast zmiany sygnału powiązane z utlenowaniem krwi.
Kolor na obrazie mózgu zwykle przedstawia porównanie statystyczne. Nie jest fotografią zamiaru ani wspomnienia. Obszar uczestniczący w zadaniu z ukrywaniem informacji nie staje się przez to wyłącznym ośrodkiem kłamstwa.
AI może dodawać analizę tekstu, obrazu lub dźwięku. Program potrzebuje jednak kategorii i przykładów uznanych za prawdziwe albo fałszywe. Nie otrzymuje bezpośredniego dostępu do wydarzenia tylko dlatego, że analizuje więcej nagrań.
Sprawdzać odpowiedź czy znajomość szczegółu?
Test pytań porównawczych, czyli CQT, zestawia reakcje na różne kategorie pytań. Znaczenie mają ich treść i zasady oceny. Wycięcie najbardziej nerwowego momentu nie odtwarza całego badania.
Test informacji ukrytej, czyli CIT, szuka odmiennej reakcji na szczegół, który może być znany, wśród innych możliwości. To pytanie o rozpoznanie. Jego wynik nie wyjaśnia automatycznie sposobu zdobycia wiedzy.
Metaanaliza P300 z 2025 roku dostarcza korzystnych wyników eksperymentalnych dla takiej procedury. Trzeba jednak zachować jej zadanie i warunki zamiast ogłaszać uniwersalne rozpoznawanie nieprawdy.
W analizie sprawy kryminalnej znajomość pomieszczenia, obecność w nim i zabranie przedmiotu są osobnymi twierdzeniami. Badanie może dostarczyć informacji o pierwszym, pozostawiając pozostałe do sprawdzenia.
Najpierw policz także brak rozstrzygnięcia
Wynik nierozstrzygający nie musi oznaczać złej decyzji. Czasem uczciwiej nie wybierać kategorii niż wymuszać odpowiedź. Ale przy opisywaniu trafności nie wolno usuwać takiej grupy z pola widzenia.
Uchaev i Apanovich w badaniu z 2023 roku analizowali dwie oddzielne grupy po czterdzieści osób. W drugim zadaniu klasyfikacja oparta na rytmie serca zmieniała się z 72,4% do 74,5%, gdy 9,2% odpowiedzi pozostawiono w obszarze niepewności.
To wyniki dotyczące powtarzanych odpowiedzi, nie osiemdziesięciu rozwiązanych przestępstw. Wyższa liczba po odłożeniu części materiału nie oznacza, że system nauczył się trafniej rozstrzygać każdy przypadek.
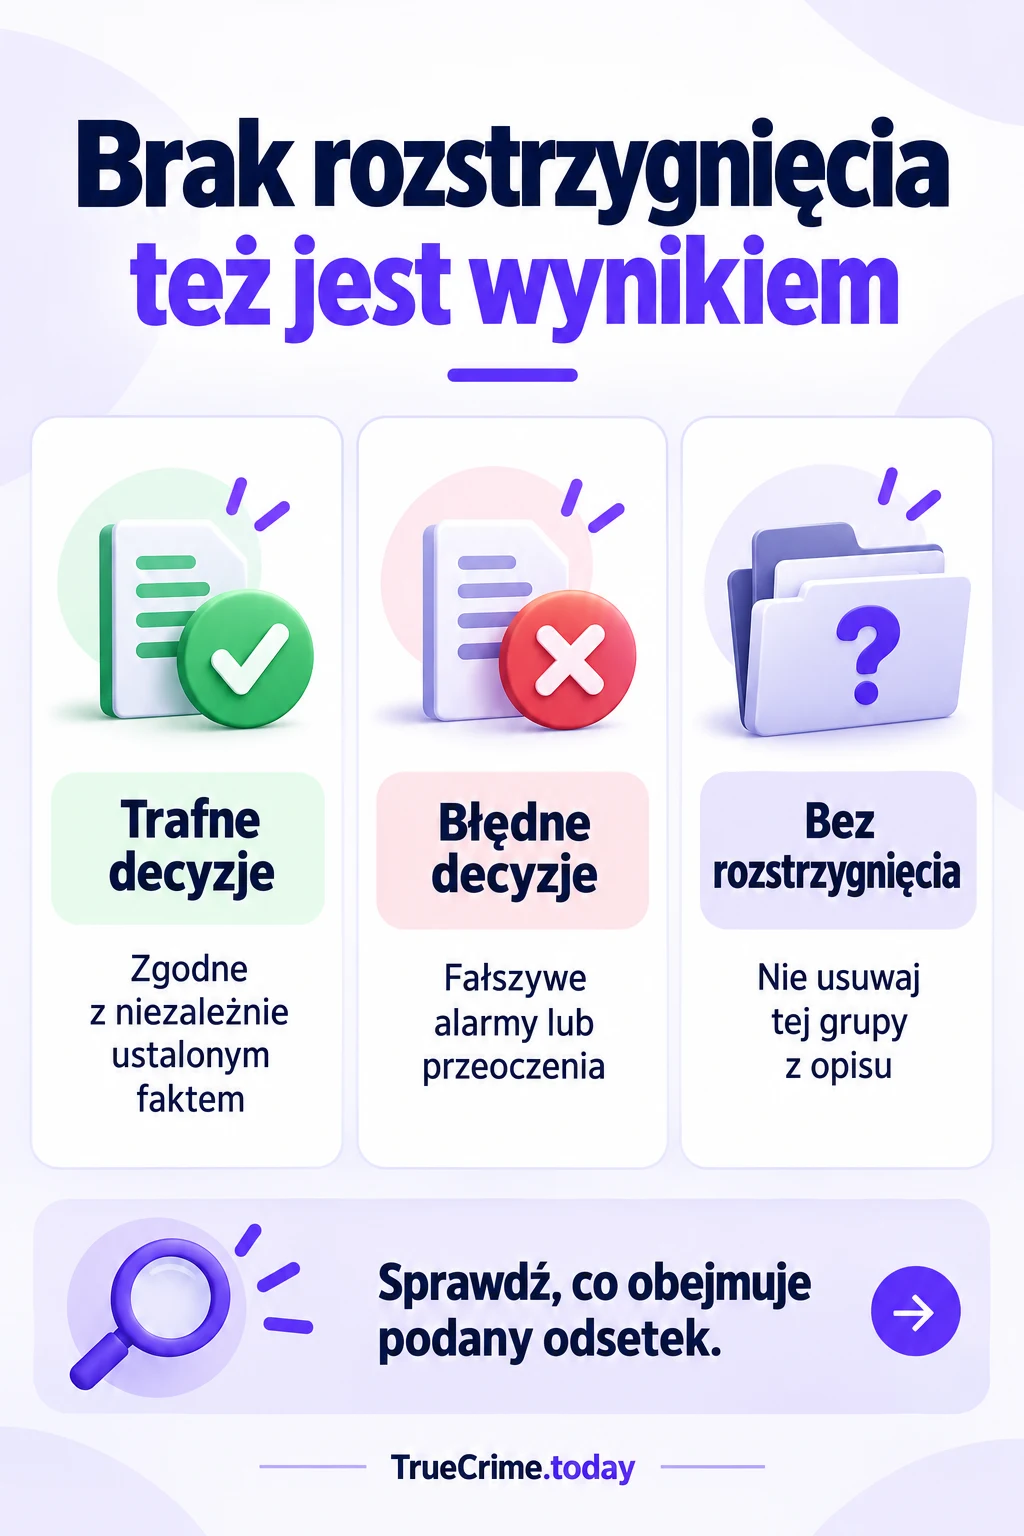
Zapytaj więc o dwa odsetki: poprawnych decyzji i wszystkich nierozstrzygniętych wyników. Dopiero razem pozwalają ocenić, jak często badanie daje odpowiedź oraz co ta odpowiedź znaczy.
Co rzeczywiście pokazują korzystne wyniki
Raport National Research Council z 2003 roku stwierdzał, że badania konkretnych zdarzeń potrafiły różnicować ponad poziom przypadku w analizowanych populacjach, ale były dalekie od doskonałości. Przestrzegał przed przenoszeniem tych wyników na szerokie badania przesiewowe.
American Polygraph Association w przeglądzie z 2011 roku podaje dla określonych technik dotyczących pojedynczego zdarzenia około 89% trafności decyzji i 11% wyników nierozstrzygających. To przegląd organizacji zawodowej, a dwie liczby należy czytać łącznie.
Honts i współautorzy oceniali CQT korzystnie w metaanalizie z 2021 roku obejmującej 138 zbiorów danych. Iacono i Ben-Shakhar w krytycznym przeglądzie z 2019 roku utrzymywali zastrzeżenia wobec podstaw naukowych i jakości danych terenowych.
Tego sporu nie rozstrzyga wybór najładniejszego procentu. Ważne są niezależne ustalenie prawdy, dobór przypadków i podobieństwo zadania do obiecywanego zastosowania. Liczby z różnych warunków nie opisują jednej stałej właściwości każdego wariografu.
P300 ma obiecujące dane, ale nie jest zapisem winy
Knappe, Ullsperger i Kirschner zebrali w 2025 roku 54 badania eksperymentalne nad P300 w testach informacji ukrytej. Średnia wielkość efektu wynosiła 1,59. To standaryzowana różnica, a nie 159% lub 59% trafnych rozpoznań.
Znaczenie miały rodzaj zadania, protokół i celowe próby wpływania na wynik. Autorzy pozytywnie ocenili protokół próby złożonej. Obecność elektrod na głowie nie oznacza więc, że dowolne badanie ma taki sam poziom potwierdzenia.
Wszystkie uwzględnione prace odbywały się w laboratorium. Wiele prób obejmowało młode, zdrowe osoby. Autorzy wskazują potrzebę sprawdzenia bardziej zróżnicowanych grup i warunków bliższych rzeczywistym badaniom kryminalistycznym.
Korzystny efekt jest powodem do dalszych badań. Nie daje jeszcze samodzielnego ustalenia, że konkretna osoba coś zrobiła. Znajomość szczegółu może pochodzić z relacji, fotografii lub wcześniejszej rozmowy.
Sto procent z siedemnastu, nie z dwudziestu ośmiu
Langleben i współautorzy porównali w 2016 roku funkcjonalny rezonans i poligraf u 28 osób ukrywających zapisaną liczbę od trzech do ośmiu. Po trzech specjalistów każdej metody oceniało zapisy, nie znając liczby.
Dla osób oceniających rezonans podano względną przewagę poprawnego wykrycia równą 1,24. Nie jest to przyrost o 24 punkty procentowe. Opisano też stuprocentowy wynik połączony w wybranej grupie siedemnastu uczestników spełniających warunek zgodności ocen.
Warunek wyboru należy do wyniku. Siedemnaście wybranych przypadków nie staje się bezbłędnym badaniem całej dwudziestki ósemki. Trzeba również wiedzieć, co dzieje się z osobami poza tą grupą.
Zadaniem pozostawało ukrycie liczby. Swobodna relacja o złożonym zdarzeniu jest innym problemem. Eksperyment może być interesujący bez przypisywania mu odpowiedzi na wszystkie pytania o szczerość.
Gdy rzadki sygnał uruchamia zbyt wiele alarmów
Przeprowadźmy własne obliczenie hipotetyczne, nie ocenę konkretnego urządzenia. W grupie dwóch tysięcy osób czterdzieści zna chroniony szczegół. Przyjmujemy czułość i swoistość po 95%, a każda osoba otrzymuje wynik binarny.
Czułość oznacza wykrycie 38 z czterdziestu osób mających wiedzę; dwie zostaną pominięte. Wśród 1 960 pozostałych pięć procent otrzyma fałszywy alarm: 98 osób. Pozostałe 1 862 prawidłowo nie wywołają alarmu.
Łącznie powstaje 136 alarmów, z czego 38 jest trafnych. Dzielenie 38 przez 136 daje około 27,9%. Dobre wartości czułości i swoistości nie gwarantują, że większość alarmów będzie trafna, kiedy szukane zjawisko jest rzadkie.
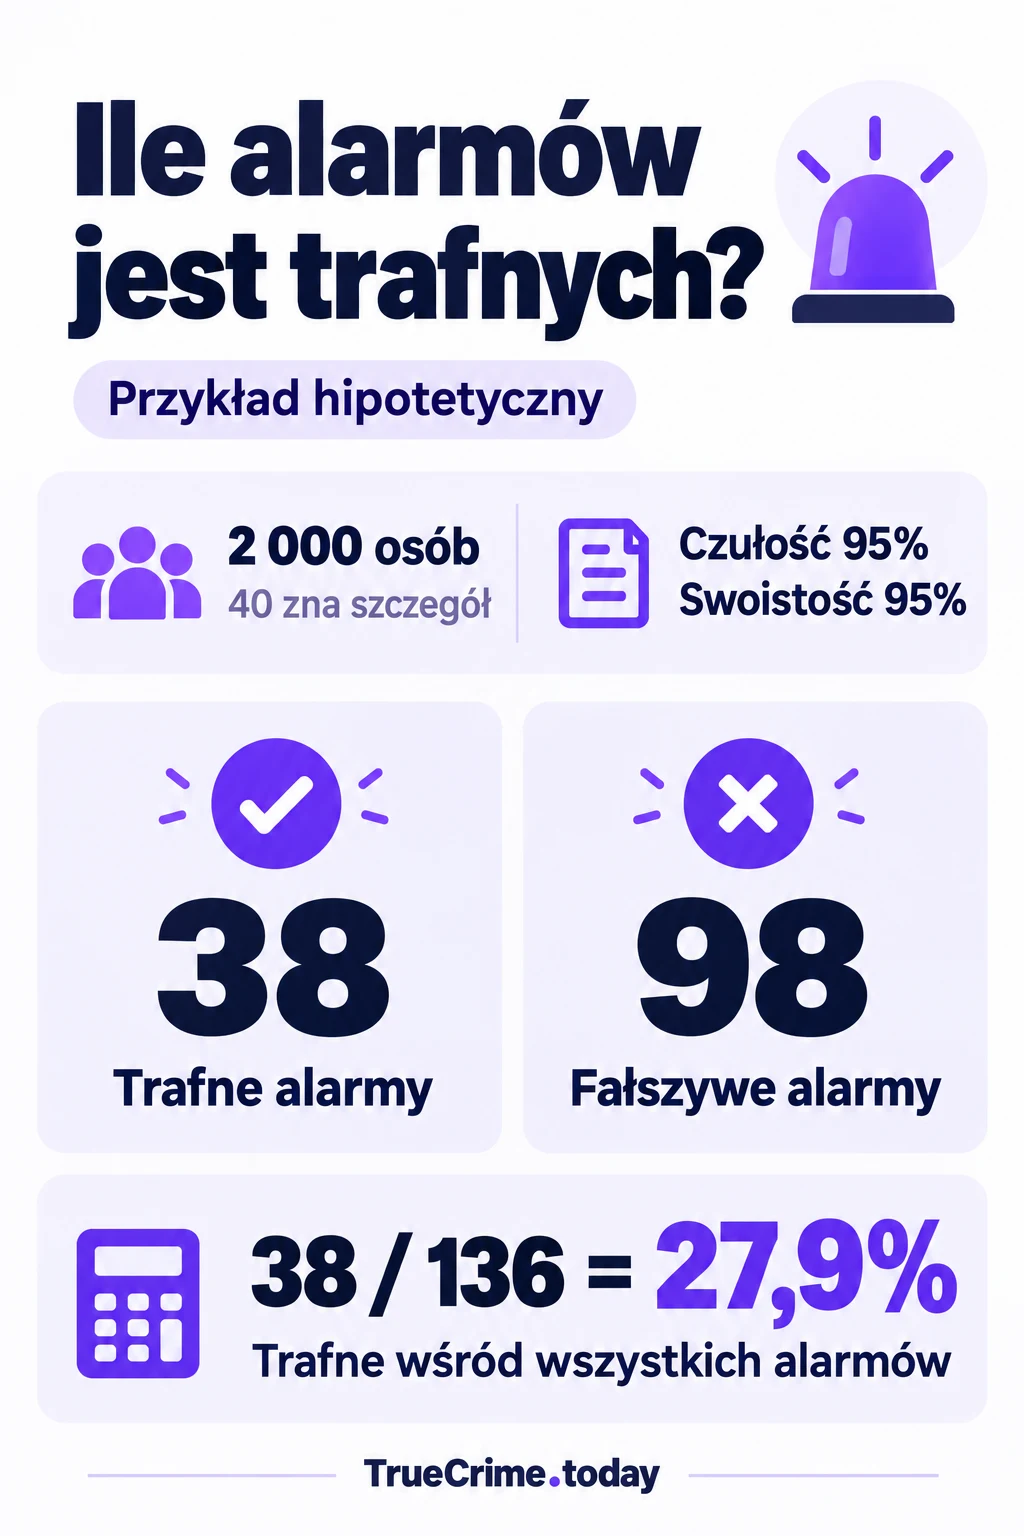
To obliczenie dotyczy wiedzy, nie winy. Nie opisuje zmierzonej trafności poligrafu. Wyjaśnia, dlaczego po alarmie potrzebna jest także informacja o częstości szukanego zjawiska, a wyniki nierozstrzygające trzeba byłoby policzyć osobno.
Algorytm też musi dostać odpowiedzi wzorcowe
Badanie ACL z 2025 roku oceniało modele na 121 fragmentach sądowych, 320 filmach z oszukiwaniem określonym instrukcją i 1 600 opiniach hotelowych. Jedna konfiguracja GPT-4o uzyskała około 79,6%, 55,1% i 71,9% trafności na tych trzech zbiorach.
Były to zadania anglojęzyczne. Liczby dotyczą konkretnej konfiguracji, nie aktualnej gwarancji produktu ani rozmowy w języku polskim. Sposób nadania etykiet ma znaczenie dla tego, co model rzeczywiście rozpoznaje.
Rozstrzygnięcie sprawy nie ustala osobno prawdziwości każdej wypowiedzi na nagraniu. Zamówiona zmyślona opinia może różnić się od prawdziwej również sposobem pozyskania. Algorytm może wykorzystać taki ślad zamiast ogólnego sygnału nieprawdy.
Trzeba rozdzielać osoby, nie tylko fragmenty. Gdy ta sama twarz lub głos pojawiają się przy tworzeniu i ocenie modelu, pomagać może rozpoznanie tożsamości albo warunków nagrania. Obietnica działania na nowych osobach wymaga testu na nowych osobach.
Dlaczego rozbudowane uzasadnienie może zmylić
Program przypisuje etykietę kłamstwa, a następnie wyjaśnia ją małą liczbą szczegółów, wahaniem lub napięciem. Tekst brzmi jak dodatkowe potwierdzenie. Może jednak tylko wiarygodnie opisywać błędny wniosek.
W pracy z 2025 roku generowanie rozumowania nie poprawiało wyników w sposób stały. W analizie błędów prawdziwe wypowiedzi z niepewnością i zakłóceniami płynności bywały uznawane za oszustwo. Samo uzasadnienie nie naprawiało etykiety.
Sprawdź, czy przywołane zachowanie rzeczywiście występuje w pełnym materiale. Co poprzedzało pauzę? Czy jest niezależna sprzeczność z faktami, czy tylko przypuszczenie dotyczące sposobu mówienia?
Dołożenie dźwięku, obrazu i tekstu też nie wystarcza. Kanały mogą wnosić informacje, ale mogą również powielać te same uprzedzenia i cechy nagrania. Ich połączenie potrzebuje własnej oceny.
Oznaczenie klucza było na zdjęciu
Wyobraź sobie zmyśloną historię: po kradzieży badanie wskazuje rozpoznanie oznaczenia klucza. W dyskusji pojawia się twierdzenie, że szczegół mogła znać tylko osoba wchodząca do mieszkania.
Później znajduje się zdjęcie przesłane wcześniej w związku z naprawą. Oznaczenie jest widoczne, a badana osoba otrzymała wiadomość. Rozpoznanie może pozostawać trafne. Przestaje działać wyjaśnienie, że wiedza pochodzi wyłącznie z kradzieży.
Następne sprawdzenie dotyczy zdjęcia, daty i odbiorców. Ponowne podkreślenie siły reakcji nie wyjaśnia źródła wiedzy. Potrzebna jest informacja, która odróżni możliwe wersje.
Chroniony szczegół mógłby być bardziej przydatny, gdyby naprawdę nie krążył wcześniej. Nadal pozostałyby do ustalenia czas, dostęp i działania. Rzetelna interpretacja uwzględnia też wyjaśnienia odsuwające podejrzenie.
Jakiej informacji szukać w opisie badania
Zacznij od dokładnego pytania i pierwotnego brzmienia wyniku. Poszukaj niezależnego sposobu ustalenia prawidłowej odpowiedzi. Wypowiedź uzyskana po pokazaniu wyniku może dać trop, ale sama nie mierzy trafności urządzenia.
Zachowaj pełny rachunek trafień, pominięć, fałszywych alarmów, prawidłowych wyników ujemnych i braku rozstrzygnięcia. Ustal, czy liczono osoby, odpowiedzi czy wielokrotne oceny tego samego zapisu.
Zapytaj o nowe osoby i niezależne warunki sprawdzenia. Język, jakość nagrania, sposób zadawania pytań, progi i częstość poszukiwanego zjawiska wpływają na przenoszenie wyniku.
Możesz uznać korzystny eksperyment za wartościowy, nie robiąc z niego certyfikatu szczerości. Wtedy wynik pomaga wybrać następne konkretne sprawdzenie, zamiast zamykać drogę do innych wyjaśnień.
Możesz zapytać o wariograf, eksperyment z rozpoznawaniem informacji lub obietnicę AI. Nie przesyłaj prywatnych wyników, nagrań, paszportów, umów, danych bankowych ani innych dokumentów osobistych.
Zapytaj o wykrywacze kłamstw