Hoe betrouwbaar is een leugendetector? Onderzoek en fouten uitgelegd
Wat bewijst een leugendetectortest werkelijk? Onderzoek naar herkenning, lichamelijke reacties, hersensignalen en AI, met cijfers over fouten en twijfel.
TL;DR
Een leugendetector bewijst niet dat een heel verhaal klopt. De polygraaf registreert lichamelijke reacties. Sommige hersentests zoeken naar herkenning van informatie. AI deelt materiaal in met behulp van vooraf gekozen labels. Om een uitslag te begrijpen heb je de taak, de fouten en de onbesliste uitkomsten nodig.
Er zijn gunstige experimentele resultaten. Die verdienen aandacht, maar leveren geen algemene waarheidsmeter op. Een bekend detail herkennen vertelt bovendien nog niet hoe iemand eraan komt of wat die persoon heeft gedaan.
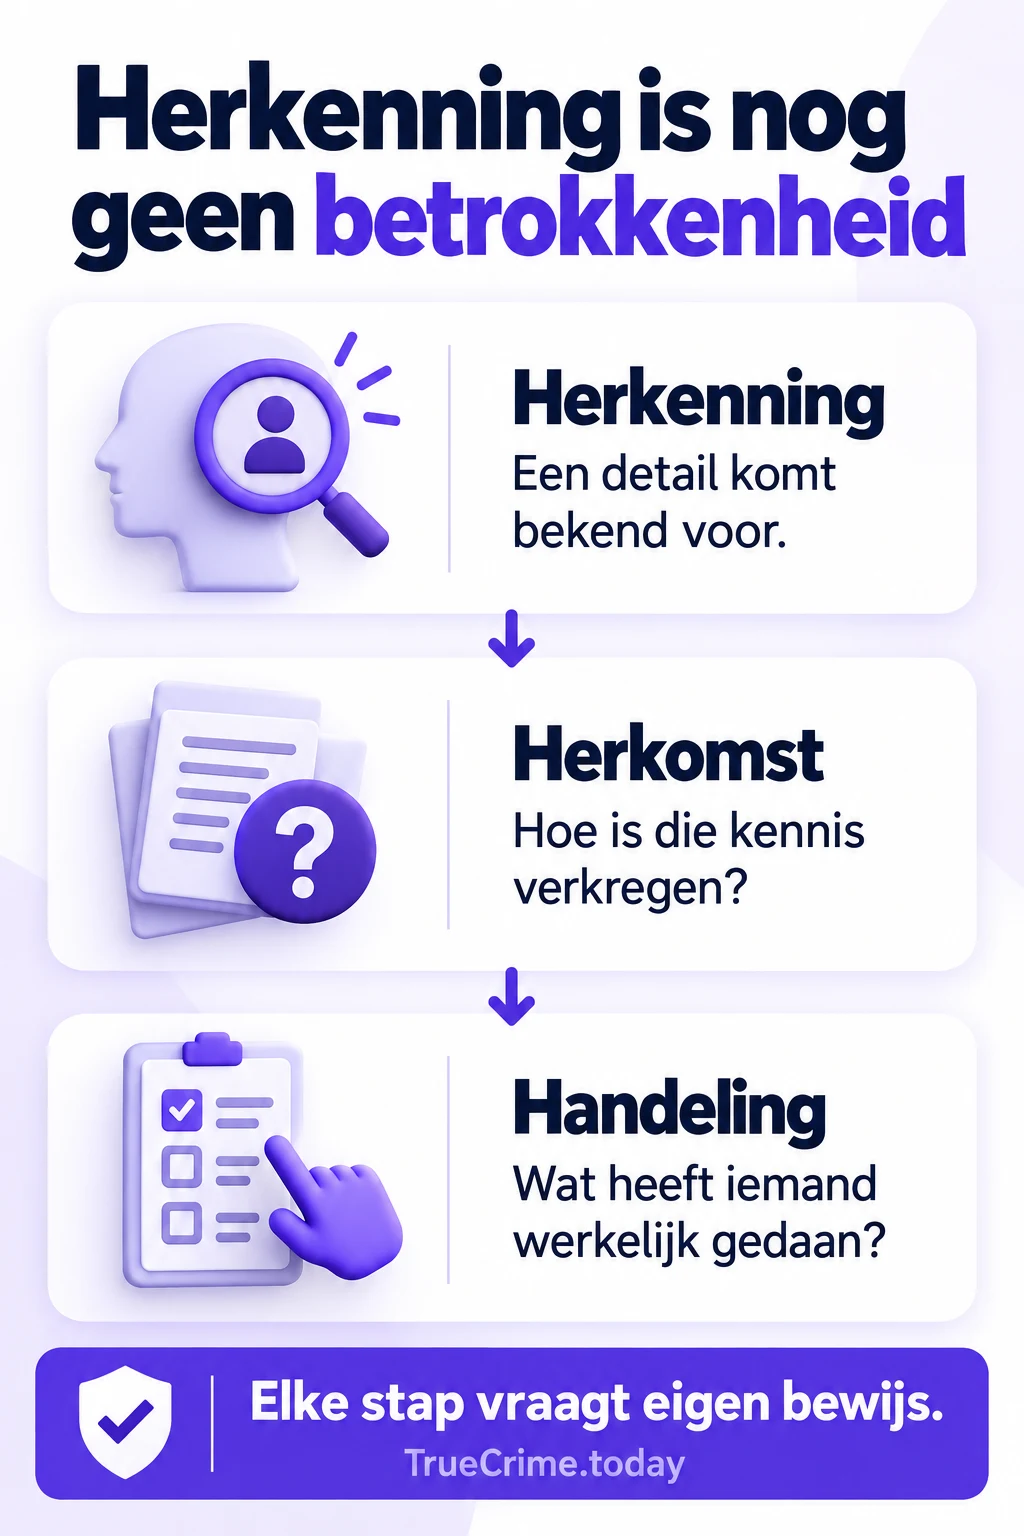
Weten is nog geen betrokkenheid
Je hoort dat een test kennis van een verborgen detail heeft gevonden. Dat klinkt overtuigend: hoe zou iemand het anders weten? Toch is juist die laatste vraag nog niet beantwoord. Een detail kan zijn gezien, verteld of tijdens een eerdere ondervraging zijn prijsgegeven.
Onderzoeker Bruno Verschuere besprak in een Nederlandstalige uitleg over leugen- en geheugendetectie hoe geheugentests andere vragen stellen dan het beoordelen van uiterlijk gedrag. Het is een oudere onderzoekstoelichting, geen nieuwe nauwkeurigheidsproef. Het onderscheid blijft bruikbaar: kennis en de herkomst ervan vragen elk om bewijs.
Bij leugens herkennen kan een juiste waarneming een verkeerde uitleg krijgen. Een persoon herkent misschien werkelijk iets, terwijl de conclusie over betrokkenheid niet klopt. Je hoeft het signaal niet te ontkennen om die uitleg te onderzoeken.
We hebben de hier besproken onderzoeken voor het laatst gecontroleerd op 19 oktober 2026.
Welke vraag probeert de proef te beantwoorden?
Een Concealed Information Test, of CIT, vergelijkt reacties op een mogelijk bekend detail met reacties op andere mogelijkheden. De proef richt zich daarmee op herkenning. De waarde hangt mede af van hoe goed de informatie beschermd is gebleven.
De vergelijkingsvragentechniek, vaak CQT genoemd, vergelijkt reacties op verschillende soorten vragen. De formulering, volgorde en beoordelingsregel horen bij het onderzoek. Alleen wijzen naar het grootste piekje is geen beschrijving van de methode.
Een meta-analyse uit 2025 over P300-geheugentests vond gunstige effecten in gecontroleerde proeven. Daarmee is een wetenschappelijke reden aanwezig om verder te onderzoeken. De uitkomst gaat niet vanzelf over elk gesprek waarin iemand iets verzwijgt.
Als je een true-crimezaak onderzoekt, moet je aangeven welk feit de uitslag ondersteunt. Het kennen van een ruimte, toegang hebben en iets meenemen zijn verschillende beweringen. De ene bewijst de andere niet.
Het lichaam reageert, maar waarop?
De gebruikelijke polygraaf registreert onder meer ademhaling, hart- en vaatreacties en huidgeleiding. Die gegevens worden in samenhang met de vragen beoordeeld. Het apparaat registreert geen onware zin als afzonderlijk lichamelijk verschijnsel.
Een EEG meet elektrische activiteit aan het hoofd. P300 is een onderdeel van een reactie na een aangeboden prikkel. Functionele MRI meet weer veranderingen die samenhangen met de zuurstofvoorziening van het bloed.
Een gekleurd hersenbeeld is doorgaans een statistische vergelijking tussen omstandigheden. Het toont geen herinnering als een foto. Een gebied dat tijdens een taak actief is, heeft daarmee nog niet uitsluitend met liegen te maken.
Die verschillende metingen kunnen nuttig onderzoek opleveren. Het probleem ontstaat wanneer de uitleg groter wordt dan wat is getest. Een groepsverschil in een experiment geeft nog geen betrouwbare beslisregel voor iedere nieuwe persoon.
Een veelbelovend resultaat uit 54 onderzoeken
Knappe, Ullsperger en Kirschner namen in 2025 54 experimentele studies over de P300 in informatietests samen. Ze vonden een gemiddelde effectgrootte van 1,59. Dat is een gestandaardiseerd verschil, geen percentage juist beoordeelde mensen.
Het soort taak, het onderzoeksprotocol en bewuste pogingen om de proef te beïnvloeden maakten uit. De auteurs beoordelen het complexe proefprotocol gunstig. Hun conclusie betreft dus meer dan de aanwezigheid van een EEG-apparaat.
Alle opgenomen studies waren laboratoriumonderzoek. De onderzochte groepen bestonden vaak uit jonge gezonde volwassenen. De auteurs wijzen zelf op de noodzaak om meer uiteenlopende mensen en werkelijke forensische omstandigheden te onderzoeken.
Dat is geen reden om het positieve effect weg te zetten. Het is een reden om precies te vragen welke volgende toepassing nog bewijs nodig heeft. Herkenning in een gecontroleerde taak en een individuele conclusie in een onderzoek blijven verschillende stappen.
Hoe een perfecte score kleiner blijkt dan hij klinkt
Langleben en collega’s vergeleken in 2016 polygraaf en functionele MRI bij 28 deelnemers die een opgeschreven getal tussen drie en acht verborgen. Drie beoordelaars per methode bekeken de gegevens zonder het gekozen getal te kennen.
De MRI-beoordelaars hadden een relatief voordeel van 1,24 in correcte herkenning. Dat is geen winst van 24 procentpunten. Het onderzoek meldde ook een perfecte gecombineerde uitkomst binnen een geselecteerde groep van zeventien deelnemers die aan een overeenstemmingsvoorwaarde voldeden.
Die zeventien zijn niet alle 28. Het selectiecriterium hoort bij de uitslag. Als je het weglaat, lijkt een resultaat voor een gekozen deelgroep op een foutloze prestatie voor iedereen.
Bovendien bleef de opdracht een verborgen getal. Een vrij verhaal over een ingewikkelde gebeurtenis vraagt iets anders. De proef kan interessant zijn voor vervolgonderzoek zonder dat zij een algemene leugendetector heeft opgeleverd.
Zonder uitsluitsel is ook een uitkomst
Een test hoeft niet altijd te beslissen. Soms past de beschikbare informatie beter bij een onbesliste uitslag. Maar die groep mag niet uit de uitleg verdwijnen zodra de nauwkeurigheid wordt genoemd.
Uchaev en Apanovich onderzochten in 2023 twee afzonderlijke groepen van veertig mensen. In de tweede taak ging een classificatie op basis van het hartritme van 72,4% naar 74,5% toen 9,2% van de antwoorden in een onzekerheidsgebied bleef.
Het ging om herhaalde antwoorden, niet om tachtig opgeloste zaken. De hogere waarde zegt iets over de antwoorden waarvoor onder de nieuwe regel nog een beslissing werd genomen. Niet over een gegarandeerd betere uitslag voor iedere nieuwe persoon.
Vraag daarom naar beide aantallen: hoeveel beslissingen waren juist en hoeveel gevallen kregen geen beslissing? Een eerlijke mogelijkheid om niet te concluderen verliest haar betekenis wanneer het publiek alleen de verbeterde score hoort.
Wat er gebeurt als je bijna iedereen onderzoekt
Een eigen denkbeeldige berekening laat een ander probleem zien. Stel dat je duizend mensen onderzoekt. Veertig kennen een beschermd detail. We nemen een sensitiviteit van 90% en een specificiteit van 95% aan, met voor iedereen een binaire uitkomst. Het zijn aannames, geen gemeten prestaties van een apparaat.
Van de veertig mensen met de kennis worden er 36 gevonden en vier gemist. Van de 960 anderen krijgt vijf procent een vals alarm: 48 mensen. Bij de overige 912 blijft het alarm terecht uit.
Er zijn dus 84 alarmen, waarvan 36 juist zijn. Dat is 36 gedeeld door 84, ongeveer 42,9%. De sensitiviteit beschrijft het vinden van aanwezige kennis. De specificiteit beschrijft het terecht uitblijven van een alarm zonder die kennis. Hoeveel alarmen kloppen, hangt ook af van hoe vaak de kennis voorkomt.
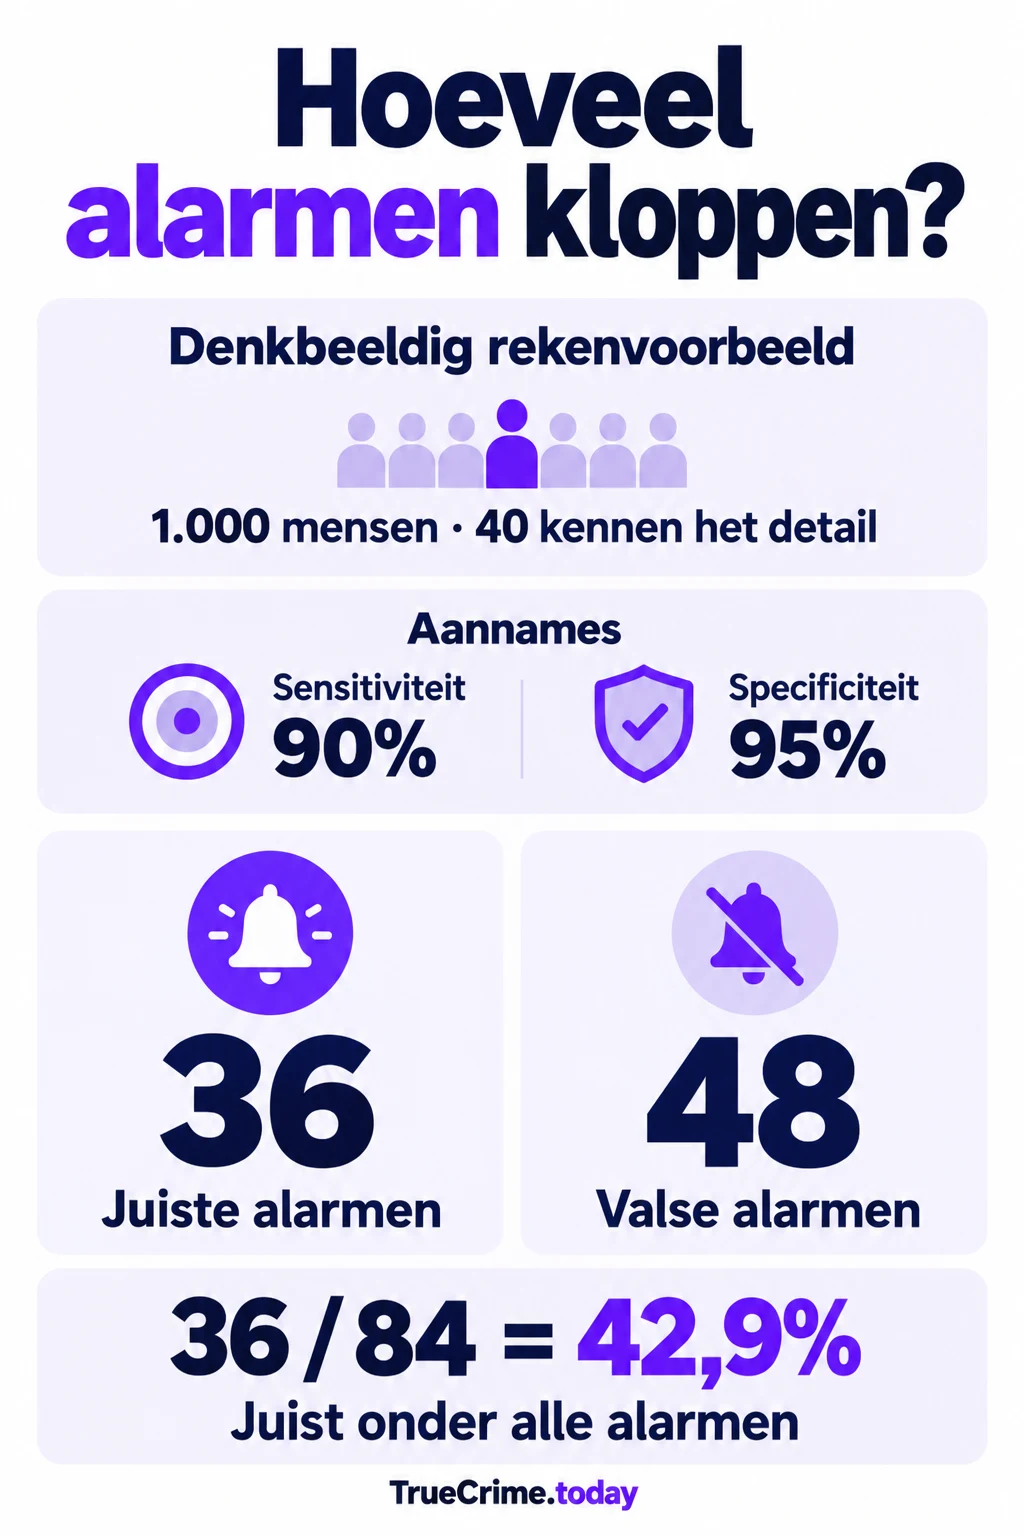
Deze uitkomst gaat niet over schuld. Als er werkelijk onbesliste uitslagen zijn, moeten die bovendien apart worden geteld. De berekening verklaart waarom hoge losse percentages niet automatisch een overtuigende uitslag na een alarm opleveren.
Waarom positieve polygraafresultaten discussie blijven oproepen
De National Research Council concludeerde in 2003 dat tests over specifieke voorvallen in de onderzochte groepen boven toeval konden onderscheiden, maar ver van perfect waren. Het rapport waarschuwde voor het overbrengen van die bevinding naar algemene screening.
De beroepsvereniging American Polygraph Association rapporteert in haar overzicht uit 2011 voor bepaalde technieken rond een specifiek voorval ongeveer 89% beslisnauwkeurigheid en 11% onbesliste uitkomsten. Die twee getallen moeten naast elkaar blijven staan.
Honts en collega’s beoordeelden het CQT in 2021 gunstig op basis van 138 gegevensverzamelingen. Iacono en Ben-Shakhar hielden in 2019 kritiek op de wetenschappelijke onderbouwing en de kwaliteit van veldgegevens.
Het verschil draait om de kwaliteit van het bewijs: hoe werden gevallen gekozen, hoe werd de waarheid onafhankelijk vastgesteld en voor welke toepassing geldt het resultaat? Eén algemeen nauwkeurigheidsgetal zou die vragen verbergen.
AI heeft vooraf gekozen labels nodig
Een ACL-onderzoek uit 2025 gebruikte 121 rechtbankfragmenten, 320 video’s met opgedragen interpersoonlijke misleiding en 1.600 hotelbeoordelingen. Een bepaalde GPT-4o-instelling behaalde afgerond 79,6%, 55,1% en 71,9% nauwkeurigheid op die drie verzamelingen.
Die verschillen horen bij verschillende taken en Engelstalige gegevens. Ze zijn geen actuele productgarantie en geen bewijs voor een Nederlandstalig interview. De manier waarop de juiste labels zijn bepaald, moet bij de beoordeling worden betrokken.
De uitkomst van een zaak bewijst niet dat elke zin in een rechtbankfragment waar is. Een verzonnen beoordeling op bestelling kan ook door de manier van verzamelen van echte beoordelingen verschillen. Het model kan zulke verschillen gebruiken zonder de beloofde algemene vaardigheid te hebben.
Ook verklaringen kunnen misleiden. Het genereren van redeneringen hielp in de studie niet consequent; ware onzekerheid en haperingen konden als misleiding worden gelezen. Een overtuigende toelichting is geen onafhankelijke controle.
De foto van de beschadigde deur
Stel je een verzonnen diefstal in een magazijn voor. Een test wijst erop dat iemand een beschadiging aan een deur herkent. In de bespreking wordt gezegd dat alleen de persoon die binnenkwam die beschadiging kon kennen.
Dan blijken foto’s van de oplevering eerder aan een grotere groep te zijn gestuurd. De onderzochte persoon stond op de verzendlijst. De herkenning kan nog steeds juist zijn. De verklaring dat deze kennis alleen van de diefstal kan komen, houdt geen stand.
De volgende controle betreft de foto’s, de datum en de ontvangers. Een sterkere reactie nog eens afspelen maakt niet duidelijk uit welke bron de kennis kwam.
Was het detail werkelijk beschermd gebleven, dan kon het informatiever zijn. Er blijven ook dan vragen over tijd, toegang en handelingen. Een bruikbaar onderzoek neemt verklaringen mee die een verdenking kunnen wegnemen.
Wat een bekentenis niet over de meetfout vertelt
Soms wordt een test verdedigd met wat iemand na afloop vertelde. Zo’n verklaring kan nieuwe feiten opleveren om te controleren. Ze vertelt niet zelfstandig hoe vaak het instrument juist meet.
Het geloof dat een apparaat iets kan ontdekken, kan een gesprek beïnvloeden. Dat effect en de nauwkeurigheid van een classificatie zijn verschillende onderzoeksvragen. Een indrukwekkend verhaal achteraf maakt die niet gelijk.
Er dreigt bovendien een cirkel wanneer de verklaring de enige bevestiging wordt van de eerdere uitslag. Het vertrouwen in die uitslag kan hebben bijgedragen aan de verklaring die hem vervolgens moet controleren.
Zoek dus onafhankelijke gegevens. De inhoud van een verifieerbare bekentenis kan belangrijk zijn voor de gebeurtenis. De foutenkans van een methode vraagt daarnaast om een behoorlijke evaluatie.
Zo houd je de conclusie bij de onderzochte vraag
Begin bij de exacte opdracht en de oorspronkelijke formulering van de uitslag. Controleer hoe de juiste uitkomst onafhankelijk werd vastgesteld. Houd kennis, waarheid van een zin en betrokkenheid bij een handeling uit elkaar.
Tel treffers, gemiste gevallen, valse alarmen, juiste negatieve uitkomsten en onbesliste resultaten. Kijk of mensen, antwoorden of meervoudige beoordelingen van dezelfde opname zijn geteld.
Een nieuw systeem moet ook met nieuwe personen worden onderzocht. Taal, opnamekwaliteit, vraagstelling, drempels en de zeldzaamheid van wat wordt gezocht, bepalen mede wat een resultaat waard is.
Je kunt een gunstig experiment serieus nemen zonder er meer zekerheid aan toe te schrijven dan is aangetoond. De uitslag wordt dan een aanleiding voor een gerichte controle, in plaats van een eindpunt dat andere verklaringen buitensluit.
Je kunt een vraag stellen over een polygraaf, een herkenningsproef of een belofte van AI. Stuur geen privéuitslagen, opnamen, paspoorten, contracten, bankgegevens of andere persoonlijke documenten.
Vraag over leugendetectortests stellen