Detector de mentiras funciona? O que os testes realmente mostram
Entenda o que polígrafos, P300, ressonância e IA medem, por que surgem falsos alarmes e o que os estudos conseguem demonstrar sobre uma pessoa.
TL;DR
Um detector de mentiras não confirma sozinho que uma história inteira é verdadeira. O polígrafo registra reações do corpo; testes P300 investigam, entre outras coisas, o reconhecimento de informações; a ressonância funcional mede outro tipo de sinal. A IA classifica exemplos com base em categorias definidas por pessoas.
Existem resultados experimentais favoráveis. Para saber o que valem, você precisa conhecer a tarefa, os erros e os resultados sem conclusão. Um sinal de reconhecimento não explica, por si só, como alguém soube de um detalhe.
O mesmo sinal pode responder a perguntas diferentes
Você encontra o nome P300 em um exame de audição e depois numa notícia sobre detecção de mentira. Parece que o cérebro oferece uma resposta pronta, bastando escolher a pergunta. Mas o objetivo do exame e a interpretação do sinal precisam ser demonstrados separadamente.
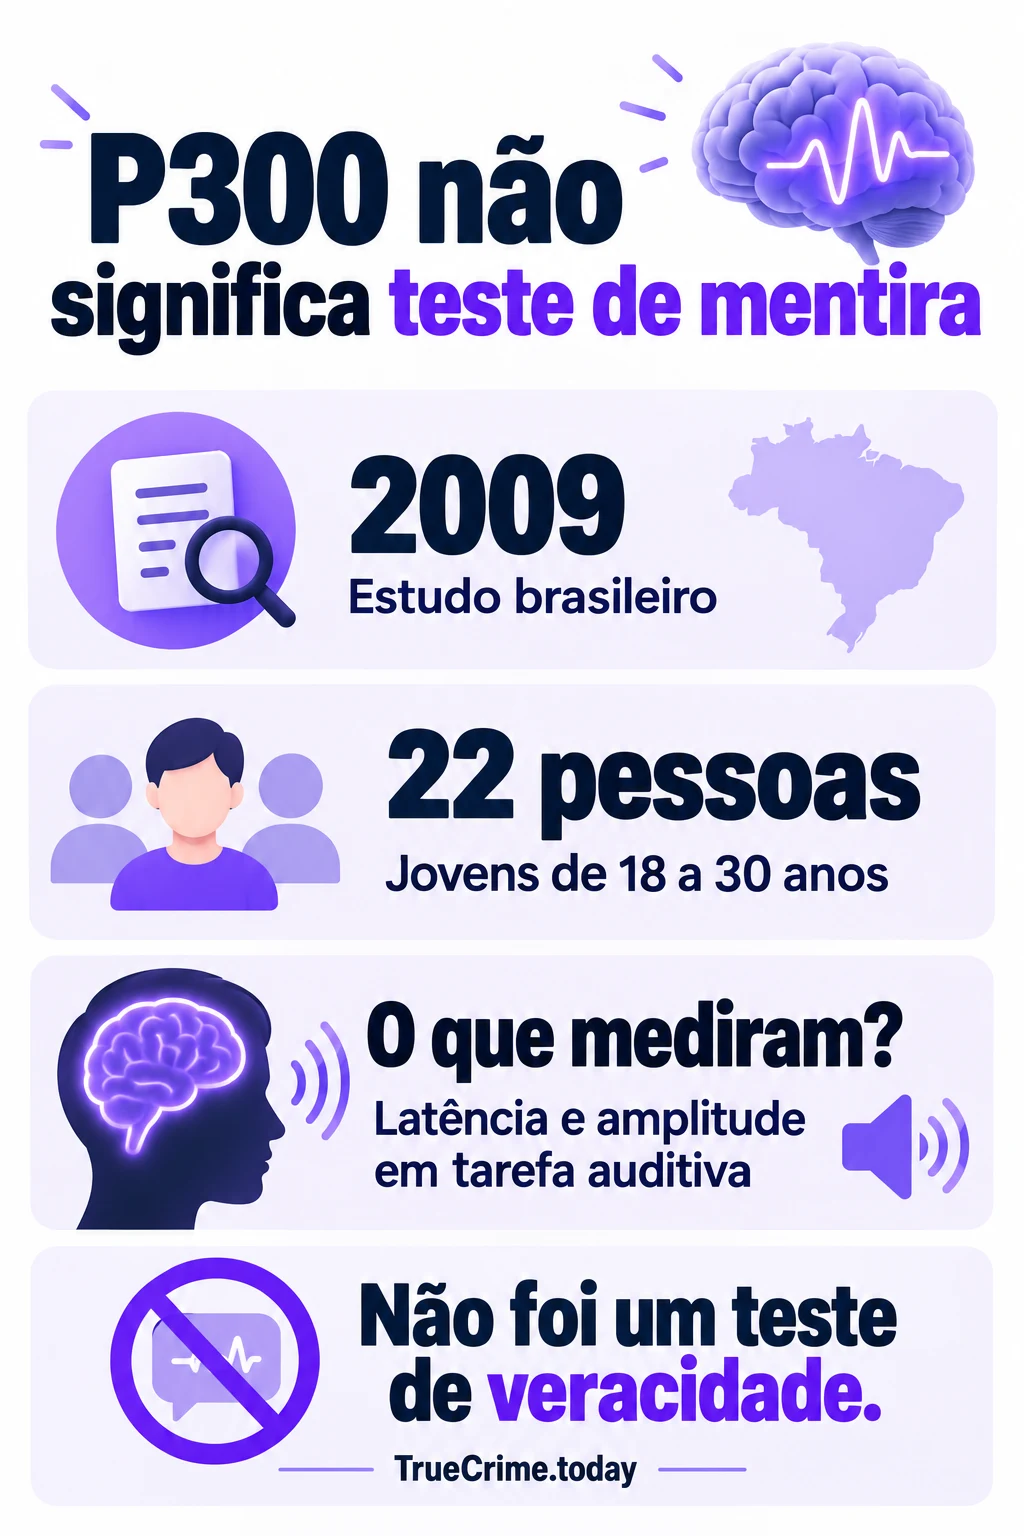
Um estudo brasileiro de 2009 sobre P300 em jovens examinou medidas de latência e amplitude em uma tarefa auditiva. Não era um teste de veracidade. A presença do mesmo nome técnico não permite transportar uma conclusão de uma tarefa para outra.
A pesquisa sobre detectar mentiras precisa ligar uma medida a um fato estabelecido de forma independente. Registrar uma mudança com precisão é uma etapa; descobrir por que ela ocorreu é outra.
A última vez que conferimos as pesquisas discutidas aqui foi em 19 de outubro de 2026.
O que os sensores captam no polígrafo
O polígrafo convencional acompanha respiração, atividade cardiovascular e condutância da pele, entre outros sinais. A interpretação compara respostas dentro de um procedimento de perguntas. O aparelho não identifica diretamente uma frase falsa.
No eletroencefalograma, ou EEG, sensores registram atividade elétrica na superfície da cabeça. A P300 faz parte de uma resposta relacionada à apresentação de um estímulo. O nome não significa uma leitura literal de pensamentos.
A ressonância magnética funcional acompanha mudanças ligadas à oxigenação do sangue. Uma área colorida costuma representar uma comparação estatística. Ela não é uma fotografia da intenção, nem passa a ser uma região exclusiva da mentira porque apareceu num experimento de ocultação.
Na análise de um caso de true crime, essa diferença orienta a próxima pergunta: qual afirmação concreta a medida ajuda a conferir? Conhecer um lugar, ter acesso a ele e retirar alguma coisa são fatos distintos.
O roteiro de perguntas muda o significado
O teste de perguntas de comparação, conhecido como CQT, contrasta reações a categorias de perguntas. A formulação e a regra de pontuação fazem parte do método. Escolher o momento em que alguém parece mais tenso não reproduz o procedimento.
Já o teste de informação oculta, ou CIT, procura uma resposta diferente diante de um detalhe possivelmente conhecido, apresentado entre alternativas. A questão se aproxima de reconhecimento, não de uma certificação geral de honestidade.
Uma metanálise de 2025 sobre P300 no CIT encontrou resultados positivos em experiências controladas. Para entender a promessa, é preciso conservar o tipo de tarefa e as condições em que a diferença foi observada.
Se o detalhe apareceu numa foto pública ou numa conversa anterior, reconhecer pode ter outra explicação. O procedimento precisa avaliar conhecimento sem fingir que sua origem já está resolvida.
De 22 jovens a uma promessa sobre qualquer pessoa
O estudo brasileiro citado no início trabalhou com 22 pessoas saudáveis, de dezoito a trinta anos. Investigava referências de P300 numa tarefa auditiva. É um exemplo de como população e objetivo vêm antes de qualquer promessa sobre a aplicação do sinal.
Uma amostra assim pode responder à pergunta proposta pelos pesquisadores sem representar todas as pessoas que um futuro sistema encontraria. O mesmo cuidado vale para experimentos de informação oculta: tarefa, grupo e condições delimitam o resultado.
Além disso, uma diferença média entre grupos não entrega automaticamente uma regra confiável para uma pessoa nova. É preciso testar essa regra, com erros e limiares definidos, em dados que não serviram para desenvolvê-la.
Por isso, ouvir que um sinal é conhecido pela ciência não encerra a discussão. O que precisa ser conhecido é o desempenho da aplicação específica, na situação em que se pretende usá-la.
O resultado positivo que merece atenção
Knappe, Ullsperger e Kirschner reuniram, em 2025, 54 estudos experimentais de P300 em testes de informação oculta. A diferença média padronizada foi de 1,59. Esse tamanho de efeito não é uma porcentagem de acertos: não significa 159% nem 59%.
O tipo de tarefa, o protocolo e tentativas deliberadas de interferência influenciaram os resultados. Os autores consideram favorável o protocolo de ensaio complexo. Isso delimita a evidência, em vez de permitir atribuí-la a qualquer exame com eletrodos.
Todos os trabalhos incluídos ocorreram em laboratório. As amostras eram predominantemente de adultos jovens saudáveis, muitas vezes estudantes. Os próprios autores apontam a necessidade de examinar grupos e condições mais próximos da prática forense.
Há uma razão para continuar pesquisando. Também há uma razão para não tratar o efeito como uma resposta individual já pronta. Manter as duas coisas é mais fiel ao resultado do que anunciar uma descoberta infalível ou descartar todos os estudos.
Qual é o denominador dessa porcentagem?
Um teste pode terminar sem conclusão. Excluir esses resultados antes de calcular o desempenho muda a pergunta respondida pelo número. Você precisa saber quantos ficaram de fora e por quê.
Uchaev e Apanovich investigaram duas turmas distintas de quarenta pessoas em 2023. Na segunda tarefa, uma classificação baseada no ritmo cardíaco passou de 72,4% para 74,5% quando 9,2% das respostas ficaram numa faixa de incerteza.
Eram respostas repetidas de participantes, não oitenta crimes solucionados. O modelo não passou a decidir melhor sobre cada resposta apresentada só porque a proporção entre as decisões restantes ficou maior.
A associação profissional American Polygraph Association também apresenta, em sua revisão de 2011, cerca de 89% de precisão das decisões e 11% de resultados inconclusivos para técnicas referentes a um evento específico. Os dois números pertencem à mesma explicação. Não são uma chance de 89% de que toda a história de alguém seja verdadeira.
Por que uma triagem produz tantos alarmes falsos
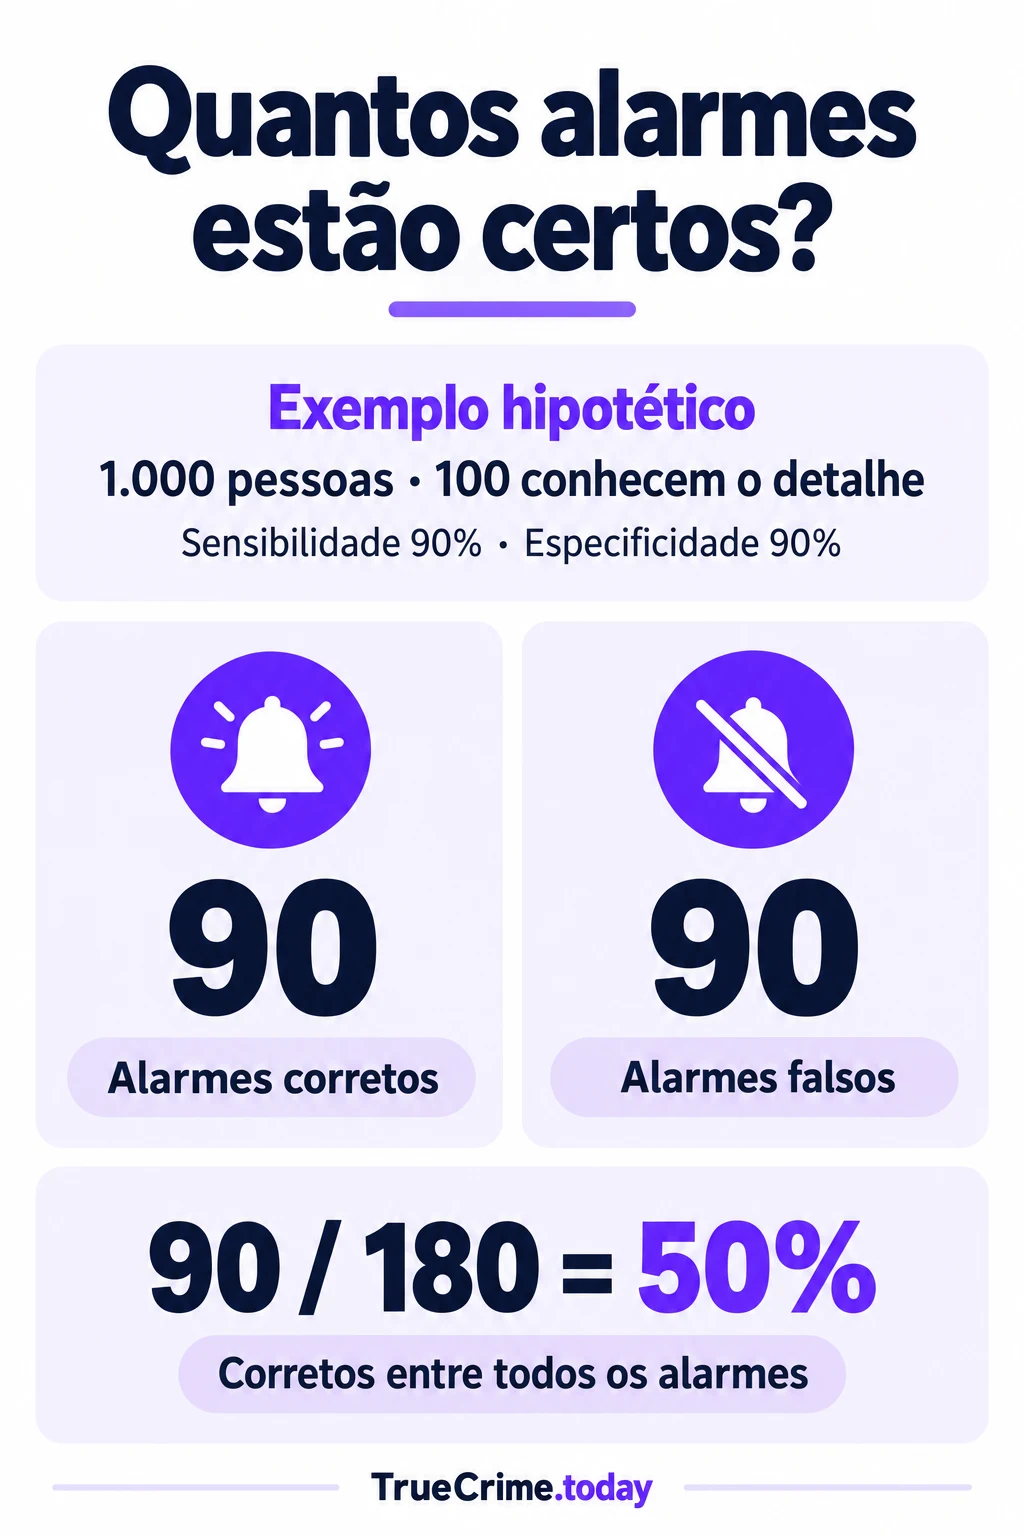
Vamos fazer um cálculo próprio, inteiramente hipotético. Mil pessoas são examinadas; cem conhecem um detalhe protegido. Assumimos sensibilidade e especificidade de 90%, com resposta binária para todo mundo. Não estamos atribuindo esses índices a um aparelho real.
A sensibilidade produz noventa detecções entre as cem pessoas que sabem e deixa passar dez. Entre as novecentas que não sabem, dez por cento recebem um alarme falso: noventa pessoas. As outras 810 ficam corretamente sem alarme.
Temos 180 alarmes, dos quais noventa estão certos. Noventa dividido por 180 resulta em 50%. Mesmo com os dois índices iniciais em 90%, metade dos alarmes estaria errada nesse cenário.
Se o conhecimento procurado fosse ainda mais raro, mantendo os demais índices, a parcela de alarmes falsos poderia aumentar. Saber uma informação também não equivale a ter cometido um crime. A conta explica a importância da frequência do alvo; não fornece probabilidade de culpa.
O número escondido dentro da ressonância
Em 2016, Langleben e colegas compararam ressonância funcional e polígrafo em 28 participantes que ocultavam um número escrito entre três e oito. Três especialistas de cada modalidade avaliavam os registros sem conhecer o número escolhido.
A comparação favoreceu os especialistas da ressonância com uma razão relativa de detecção correta de 1,24. Não se trata de um ganho de 24 pontos percentuais. O trabalho também relatou resultado combinado perfeito numa seleção de dezessete participantes que atendiam a uma condição de concordância.
Dezessete não são os vinte e oito. A seleção precisa acompanhar o anúncio dos cem por cento. Um resultado perfeito entre casos escolhidos não é uma garantia para todos os participantes, muito menos para qualquer história real.
O experimento continua interessante: pode ajudar a estudar quando a combinação de métodos permite uma decisão. Mas o alvo era um número oculto, e não a verdade de um relato livre sobre um episódio complexo.
A inteligência artificial precisa de um gabarito
Em uma avaliação da ACL de 2025, modelos foram testados com 121 trechos judiciais, 320 vídeos de engano definido por instruções e 1.600 avaliações de hotéis. Uma configuração do GPT-4o obteve aproximadamente 79,6%, 55,1% e 71,9% de precisão nesses conjuntos.
Os materiais eram em inglês, e os números pertencem àquela configuração. Não são garantia atual de um produto nem comprovação de desempenho numa conversa em português. Os critérios usados para chamar um exemplo de verdadeiro ou falso também variavam.
Uma decisão sobre o processo não verifica cada frase de um vídeo. Uma avaliação inventada sob encomenda pode diferir de uma espontânea pela forma como foi produzida. O algoritmo pode explorar diferenças que não correspondem à promessa de reconhecer mentira em qualquer situação.
Também é necessário separar pessoas entre desenvolvimento e teste. Se gravações da mesma pessoa aparecem nos dois lados, reconhecer voz ou ambiente pode facilitar a classificação. Isso não testa a capacidade de avaliar alguém desconhecido.
Quando a explicação convence mais que o resultado
O sistema diz que uma resposta é falsa e apresenta uma justificativa bem escrita: poucos detalhes, hesitação ou emoção excessiva. A explicação parece reforçar a etiqueta, mas pode ser apenas uma narrativa convincente sobre um erro.
Na avaliação de 2025, gerar raciocínios não melhorou consistentemente o desempenho. A análise de erros encontrou incerteza e interrupções da fala verdadeira interpretadas como engano. Explicar mais não resolveu necessariamente a classificação.
Antes de aceitar a justificativa, confira se a observação existe no material completo. A pausa vem depois de qual pergunta? Há uma contradição independente ou só uma suposição sobre o jeito de falar?
Somar vídeo, voz e texto não dispensa a avaliação. Os canais podem acrescentar informação, mas também carregar os mesmos vieses ou marcas da gravação. O conjunto precisa demonstrar seu próprio desempenho.
A gaveta mostrada no treinamento
Imagine uma situação inventada: desaparece dinheiro de um caixa e uma prova indica que alguém reconhece a gaveta utilizada. Surge a conclusão de que só quem retirou o dinheiro poderia saber onde ele estava.
Depois aparece o material de um treinamento, anterior ao desaparecimento. A gaveta estava nas imagens, e aquela pessoa participou da atividade. O reconhecimento pode estar certo; a explicação exclusiva é que deixa de funcionar.
A próxima checagem envolve o material, a data e quem teve acesso a ele. Repetir que a reação foi intensa não esclarece a origem do conhecimento.
Se o detalhe tivesse permanecido protegido, sua identificação poderia ser mais informativa. Ainda seria preciso examinar acesso, horários e retirada do dinheiro. Uma boa interpretação também procura explicações capazes de afastar a suspeita.
O que perguntar antes de confiar no laudo
Comece pelo resultado original e pela pergunta examinada. Procure como o fato correto foi estabelecido sem depender do próprio teste. Uma declaração posterior pode abrir uma investigação, mas não mede sozinha o índice de acertos do aparelho.
Há pesquisas favoráveis ao CQT, como a metanálise de Honts e colegas de 2021, com 138 conjuntos de dados. Há críticas persistentes aos fundamentos e aos dados de campo, como a análise de Iacono e Ben-Shakhar de 2019. O desacordo exige olhar os critérios e as tarefas, não escolher o percentual mais atraente.
Conte detecções, falhas, alarmes falsos e resultados sem conclusão. Verifique se a unidade é uma pessoa, uma resposta ou uma avaliação repetida. Pergunte se houve teste independente com pessoas novas e condições semelhantes às prometidas.
Com isso, você consegue dar espaço a um achado promissor sem transformá-lo em certificado de honestidade ou culpa. O resultado deve ajudar a escolher o próximo fato a verificar, com os limites à vista.
Você pode perguntar sobre polígrafos, testes de reconhecimento ou uma promessa de detecção por IA. Não envie resultados privados, gravações, passaportes, contratos, dados bancários ou outros documentos pessoais.
Perguntar sobre detectores de mentiras