Detector de mentiras: qué puede demostrar un polígrafo y qué no
¿Pasar un polígrafo demuestra que alguien dice la verdad? Examinamos preguntas, memoria, pruebas cerebrales e IA, con datos y ejemplos de falsas alarmas.
TL;DR
Un detector de mentiras no permite dar por cierta toda una historia. El polígrafo registra reacciones fisiológicas; algunos tests cerebrales buscan señales relacionadas con el reconocimiento; la IA clasifica material a partir de etiquetas. Para valorar el resultado necesitas conocer la pregunta, los errores y los casos sin conclusión.
Hay resultados experimentales favorables. Lo que no existe es un porcentaje único que puedas aplicar a cualquier persona, aparato o investigación. Una señal de reconocimiento tampoco explica por sí sola cómo se adquirió ese conocimiento.
¿Qué se supone que ha quedado demostrado?
«Ha pasado el polígrafo». Lees la frase en una discusión y parece que ya no queda nada por preguntar. Sin embargo, tú todavía no sabes qué se examinó. ¿Una retirada de dinero? ¿El conocimiento de un lugar? ¿Una pregunta sobre toda una relación?
El resultado solo puede interpretarse dentro de la prueba realizada. Convertir una respuesta sobre un episodio en un certificado de sinceridad para todo el relato amplía la conclusión sin añadir pruebas.
La investigación sobre detectar mentiras obliga a separar lo que observamos de lo que creemos que significa. Una reacción puede estar bien registrada y tener varias explicaciones. Que la curva sea precisa no vuelve precisa cualquier interpretación.
Jaume Masip examinó en una revisión de 2005 sobre detección del engaño la distancia entre seguridad al juzgar y capacidad real para acertar. Es un problema anterior a los programas actuales: sentirse convencido no comprueba la conclusión.
La última vez que revisamos los estudios de esta explicación fue el 19 de octubre de 2026.
El nombre del aparato no explica la prueba
El polígrafo convencional registra respiración, actividad cardiovascular y conductancia de la piel. No imprime una frase falsa identificada como tal. Las respuestas se comparan según unas preguntas y una regla de puntuación.
El electroencefalograma, o EEG, registra actividad eléctrica en el cuero cabelludo. La P300 es un componente de la respuesta a un estímulo. La resonancia magnética funcional observa cambios relacionados con la oxigenación sanguínea. Son mediciones distintas, no versiones sucesivas de una máquina que accede a la verdad.
La IA puede trabajar con texto, audio, vídeo o señales fisiológicas. Para entender su resultado debes saber qué entrada recibió y cómo se asignaron las etiquetas de verdad y mentira. Un algoritmo no obtiene esa referencia simplemente mirando una grabación.
Al hacer análisis de un caso de true crime, conviene formular primero el hecho que quieres comprobar. Reconocer un detalle, estar presente y retirar un objeto son afirmaciones diferentes. Una prueba útil debe ayudar a distinguirlas.
Preguntar por una acción o buscar un recuerdo
El test de preguntas de comparación, conocido como CQT, contrasta las reacciones a categorías de preguntas. Su interpretación depende del procedimiento completo. No equivale a señalar el momento en que alguien se pone nervioso.
El test de información oculta, o CIT, busca una respuesta diferente ante un elemento que la persona podría reconocer entre varias alternativas. La cuestión pasa a ser si conoce cierta información, algo más limitado que decidir si su relato entero es verdadero.
Un metaanálisis de 2025 sobre P300 y reconocimiento encontró resultados favorables en experimentos controlados. Eso justifica estudiar el método; también obliga a conservar la diferencia entre detectar conocimiento y establecer una acción.
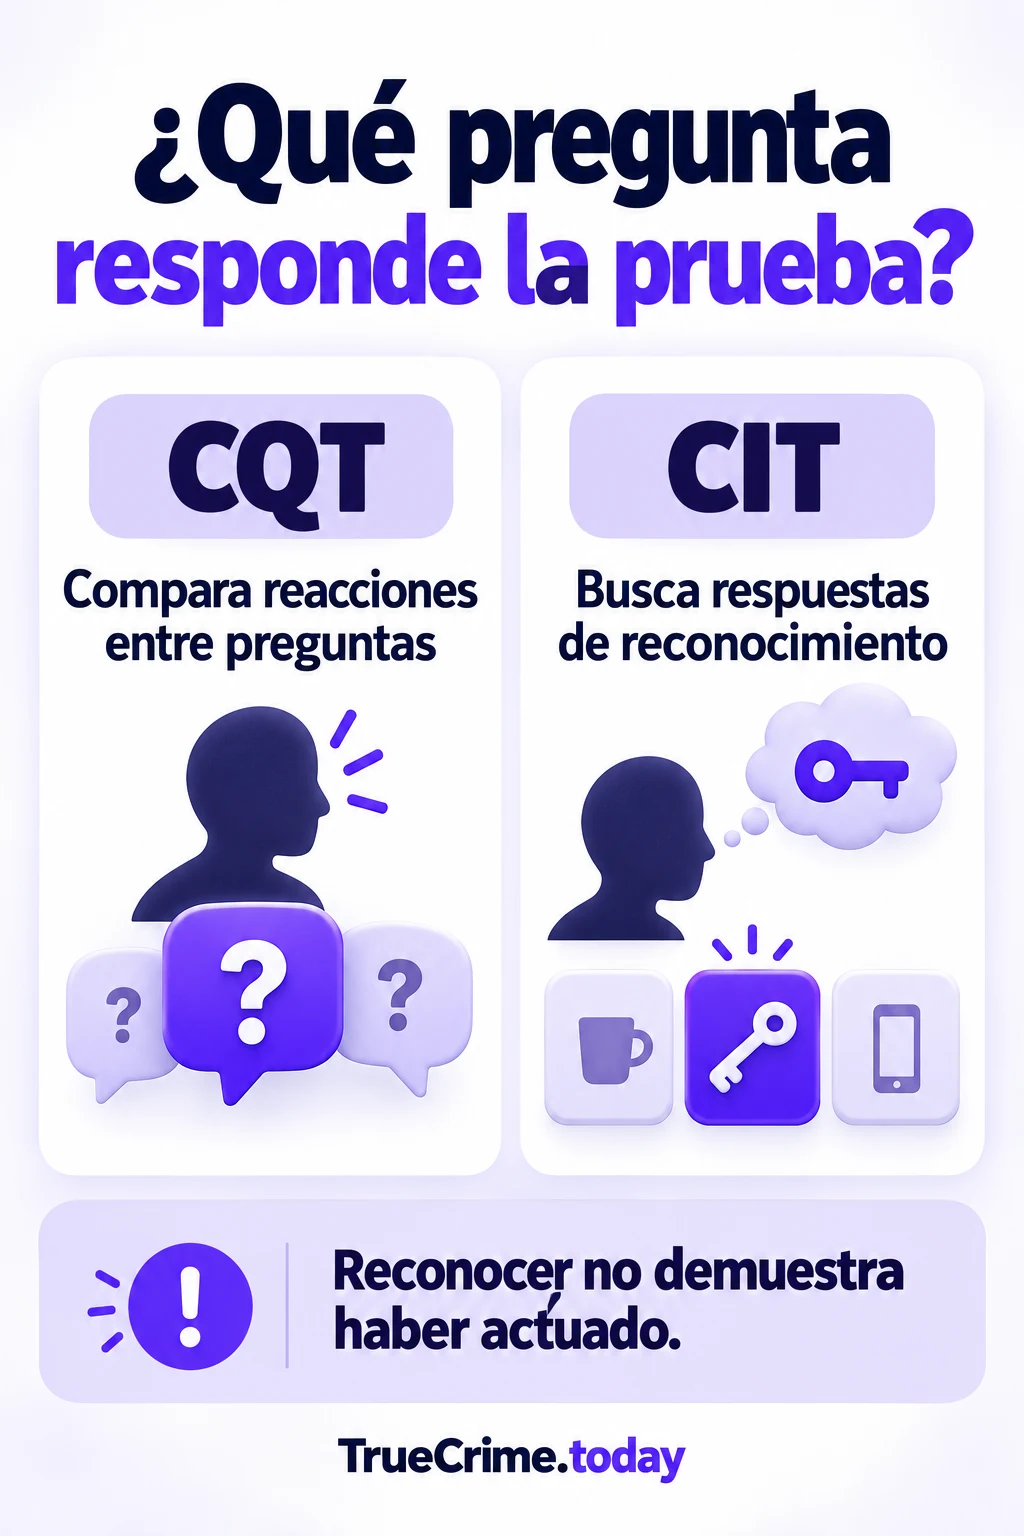
Una foto publicada, una conversación previa o una pregunta mal planteada pueden proporcionar el detalle. Si varias personas lo conocen por motivos distintos, reconocerlo deja de señalar una única explicación.
El porcentaje necesita su grupo de referencia
Hagamos un cálculo propio e hipotético. No describe la precisión medida de ningún aparato. Supón que se examina a 2.000 personas, cien de las cuales conocen un detalle protegido. Asumimos una sensibilidad y una especificidad del 90%, sin respuestas indecisas.
La sensibilidad indica cuántas personas con el conocimiento son detectadas: noventa de cien. Quedan diez sin detectar. La especificidad indica cuántas de las 1.900 restantes evitan una falsa alarma: 1.710. Otras 190 reciben una señal equivocada.
Tenemos 280 alarmas: noventa correctas y 190 falsas. Noventa dividido entre 280 da aproximadamente el 32,1%. Los dos porcentajes iniciales eran del 90%; la proporción de alarmas correctas es bastante menor porque hay muchas más personas sin el conocimiento buscado.
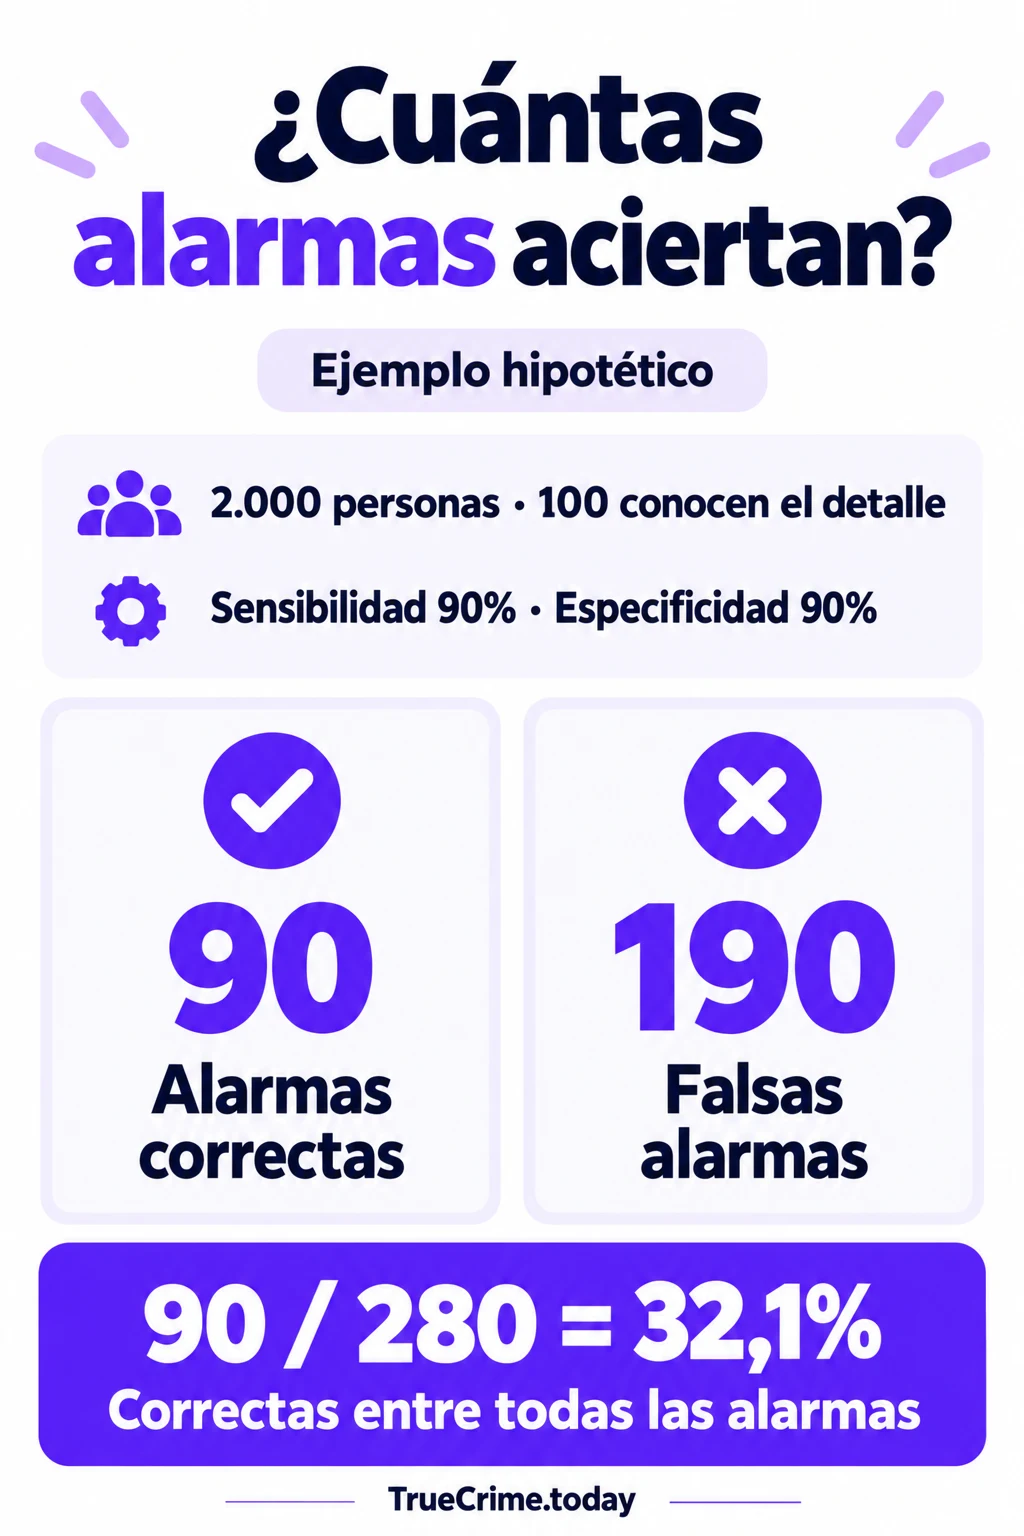
Si cambia la frecuencia de ese conocimiento, cambia la proporción final. Y conocer una información sigue sin equivaler a ser responsable de un delito. El cálculo muestra por qué una cifra general de aciertos no responde automáticamente a la pregunta que aparece después de una alarma.
Lo que apoya la investigación sobre el polígrafo
No sería correcto afirmar que toda prueba da lo mismo que lanzar una moneda. El informe del National Research Council de 2003 encontró discriminación superior al azar en pruebas sobre incidentes concretos y en las poblaciones examinadas, aunque lejos de la perfección. Advirtió contra trasladar esos resultados al cribado masivo.
La American Polygraph Association informó en su revisión de 2011 de unas cifras de precisión de decisión del 89% y un 11% de resultados inconclusos para técnicas diagnósticas de un hecho concreto. Proceden de la revisión de una asociación profesional; los dos porcentajes deben leerse juntos.
También existe desacuerdo entre investigadores. Honts y colegas reunieron 138 conjuntos de datos en 2021 y defendieron una interpretación favorable del CQT. Iacono y Ben-Shakhar mantenían en 2019 objeciones sobre sus fundamentos y los datos de campo.
No puedes promediar esas posiciones como si fueran mediciones de un mismo producto en idénticas condiciones. Importan la selección de casos, la confirmación independiente de la verdad y la diferencia entre experimento, incidente concreto y búsqueda entre miles de personas.
Reconocer algo no cuenta cómo lo conociste
Un CIT resulta más informativo cuando el detalle se ha mantenido protegido y existen alternativas comparables. Si la respuesta correcta circula en redes o se revela durante una entrevista, la interpretación cambia aunque el registro siga siendo impecable.
También hay que preguntar qué pudo quedar en la memoria. No reconocer una imagen no demuestra automáticamente que la persona nunca estuviera allí. La tarea necesita pruebas sobre lo que detecta y sobre lo que deja pasar.
En un metaanálisis de 2014, Meijer y colegas encontraron efectos positivos en varias medidas del CIT. La ventaja media de P300 sobre la conductancia cutánea aparecía en tareas con elementos personales, no en la comparación con delitos simulados. Reconocer tu propio nombre no reproduce todas las condiciones de recordar un episodio preparado en laboratorio.
Esta diferencia sirve para leer una demostración: ¿se ha elegido un estímulo especialmente familiar o se ha comprobado una tarea parecida a la que se promete resolver? La cercanía entre ambas situaciones debe demostrarse.
P300: un resultado favorable con límites concretos
Knappe, Ullsperger y Kirschner reunieron en 2025 54 estudios experimentales. Obtuvieron para P300 un tamaño medio del efecto de 1,59. Ese número expresa una diferencia estandarizada entre condiciones; no significa un 159% ni un 59% de personas identificadas correctamente.
El tipo de tarea, el protocolo y la presencia de intentos deliberados de alterar la prueba influían en los resultados. Los autores favorecen el protocolo de ensayo complejo. Comparar protocolos requiere conservar esas condiciones, no anunciar que cualquier EEG hereda el resultado.
Todos los estudios incluidos se realizaron en laboratorio. Las muestras eran, en gran parte, jóvenes sanos, frecuentemente estudiantes. Los propios investigadores señalan la necesidad de examinar poblaciones y condiciones más representativas de la práctica forense.
La conclusión razonable conserva las dos partes: hay una señal experimental prometedora y todavía hay preguntas sobre su funcionamiento fuera de esas condiciones. Reconocer la primera no obliga a borrar la segunda.
Cuando un resultado perfecto corresponde a una parte
En un experimento de Langleben y colegas de 2016, 28 participantes ocultaron un número escrito entre tres y ocho. Se compararon sesiones de resonancia funcional y polígrafo, con tres especialistas por modalidad que desconocían el número.
Los especialistas en resonancia obtuvieron una ventaja relativa de 1,24 en la detección correcta. No es una diferencia de 24 puntos porcentuales. El trabajo también informó de un resultado combinado perfecto en una submuestra seleccionada de diecisiete participantes que cumplía una condición de acuerdo.
Diecisiete no son los veintiocho. La selección forma parte del resultado. El procedimiento podría ser interesante precisamente por cuándo produce una conclusión compartida, pero quedan por contar quienes no entran en ese grupo.
Además, ocultar un número no equivale a reconstruir un relato espontáneo sobre un delito. Un resultado favorable puede merecer nuevos estudios sin convertirse en una garantía sobre cualquier narración.
Una IA también hereda las etiquetas
Una evaluación publicada en ACL en 2025 comparó modelos con material judicial, vídeos de engaño indicado por instrucciones y reseñas de hoteles. Una configuración concreta de GPT-4o obtuvo aproximadamente un 79,6%, un 55,1% y un 71,9% de precisión, respectivamente.
Son resultados de tareas distintas y de una configuración determinada. No describen la fiabilidad actual de cualquier chatbot ni se trasladan sin pruebas a una conversación en español. Una resolución judicial tampoco establece la verdad de cada frase de una grabación.
La explicación del modelo puede aumentar la apariencia de certeza. En ese estudio, pedir razonamientos no mejoró de manera constante el rendimiento; algunas vacilaciones y expresiones de incertidumbre verdaderas se interpretaron como engaño.
Para evaluar el sistema necesitas separar personas, además de fragmentos. Si la misma voz aparece al desarrollar y al probar un modelo, este puede aprender rasgos de identidad o grabación. Su éxito no demostraría que distingue mentiras de una persona desconocida.
El sobre que aparecía en una foto
Imagina una situación inventada: desaparece un sobre de una taquilla y una prueba indica que alguien reconoce el compartimento. Se afirma que solo quien retiró el sobre podía conocerlo.
Después aparece una foto de la entrega, compartida antes de la desaparición. En ella se ve la taquilla. El reconocimiento puede seguir siendo real; lo que falla es la afirmación de que solo existe una forma de conocer el detalle.
La siguiente comprobación no consiste en repetir que la señal era intensa. Consiste en averiguar quién vio la foto, cuándo y qué mostraba. Son hechos que permiten poner a prueba la explicación.
Si la información hubiera permanecido protegida, el reconocimiento podría tener otro valor. Aun así, el acceso, los horarios y la retirada del objeto necesitarían sus propias pruebas. Una conclusión mejora cuando puede distinguir también las explicaciones que descartan una sospecha.
Una prueba que hace hablar no está siempre en lo cierto
A veces el argumento más llamativo llega después de la sesión: la persona cuenta algo que antes no había dicho. Esa información puede abrir una comprobación, pero no establece por sí sola cuántas veces acierta el instrumento.
Creer que un aparato detecta la mentira puede influir en una conversación. Esa utilidad y la capacidad de clasificar correctamente necesitan estudios diferentes. Confundirlas impide saber qué produjo el resultado.
También aparece un círculo si una confesión obtenida después se usa como única confirmación del test. La confianza en el instrumento pudo influir en la declaración con la que luego se pretende verificarlo.
Lo que se cuente necesita contraste independiente. Una admisión verificable añade datos sobre el episodio; una historia impactante sobre la sesión no sustituye el recuento de errores.
Qué pedir antes de creer una conclusión
Empieza por la pregunta exacta, el procedimiento y la formulación original del resultado. Busca cómo se estableció la respuesta correcta sin depender de la misma prueba que se está evaluando.
Después cuenta aciertos, fallos, falsas alarmas y resultados inconclusos. Comprueba si el porcentaje se refiere a personas, respuestas repetidas, valoraciones de especialistas o una submuestra escogida. Son unidades diferentes.
Por último, pregunta si hubo pruebas independientes con personas nuevas y condiciones parecidas a las prometidas. El idioma, el material, los umbrales y la rareza de lo que se busca importan.
Con esos datos puedes reconocer un resultado interesante sin convertirlo en una sentencia sobre toda una persona. La pregunta útil sigue siendo concreta: ¿qué hecho queda mejor comprobado y qué explicación alternativa permanece abierta?
Puedes preguntar por una prueba de polígrafo, un experimento de reconocimiento o una afirmación sobre IA. No envíes resultados privados, grabaciones, pasaportes, contratos, datos bancarios ni otros documentos personales.
Preguntar sobre detectores de mentiras