Détecteur de mensonge : que valent le polygraphe, l’IRM et l’IA ?
Une courbe ou une image du cerveau ne tranche pas toute une affaire. Études, erreurs et résultats encourageants des détecteurs de mensonge, expliqués.
TL;DR
Un détecteur de mensonge ne permet pas de décider, à lui seul, si tout un récit est vrai. Le polygraphe enregistre des réactions corporelles. Les tests P300 étudient notamment la reconnaissance d’informations. L’IRM fonctionnelle et l’IA produisent encore d’autres mesures, qu’il faut interpréter.
Certaines expériences donnent des résultats encourageants. Pour les comprendre, tu dois garder la tâche, les erreurs et les résultats sans conclusion. Reconnaître un détail ne dit pas encore comment on l’a appris, ni ce qu’on a fait.
Pourquoi l’image du cerveau paraît si convaincante
Une zone colorée apparaît à l’écran. Le commentaire annonce qu’elle révèle une information cachée. Tu as l’impression de voir quelque chose de plus solide qu’une déclaration, peut-être même le souvenir lui-même. Pourtant, l’image et l’explication sont deux choses à examiner.
Dans un texte de 2018 publié par le journal du CNRS, la chercheuse Sonia Desmoulin-Canselier attirait l’attention sur la confusion entre image cérébrale, interprétation et attribution d’un acte. Sa question aide à lire une démonstration : que montre l’image et que lui fait-on dire ?
Pour détecter un mensonge, il faudrait établir le lien entre un signal et une affirmation fausse. Voir une réponse cérébrale n’efface pas cette étape. L’attention, la reconnaissance et la façon de répondre peuvent participer à une tâche sans désigner une intention unique.
Nous avons vérifié les recherches présentées ici pour la dernière fois le 19 octobre 2026.
Ce que montrent les capteurs
Le polygraphe conventionnel relève plusieurs paramètres, dont la respiration, l’activité cardiovasculaire et la conductance cutanée. Les réactions sont comparées dans un protocole de questions. Aucun capteur ne transcrit directement une phrase mensongère.
L’électroencéphalogramme, ou EEG, enregistre une activité électrique à la surface de la tête. La P300 est une composante d’une réponse liée à la présentation d’un stimulus. L’IRM fonctionnelle mesure des changements de signal associés à l’oxygénation du sang.
Une image colorée représente généralement une comparaison statistique entre conditions. Elle ne montre pas un souvenir comme une photographie. Passer d’une différence moyenne à une décision sur une nouvelle personne demande une autre vérification.
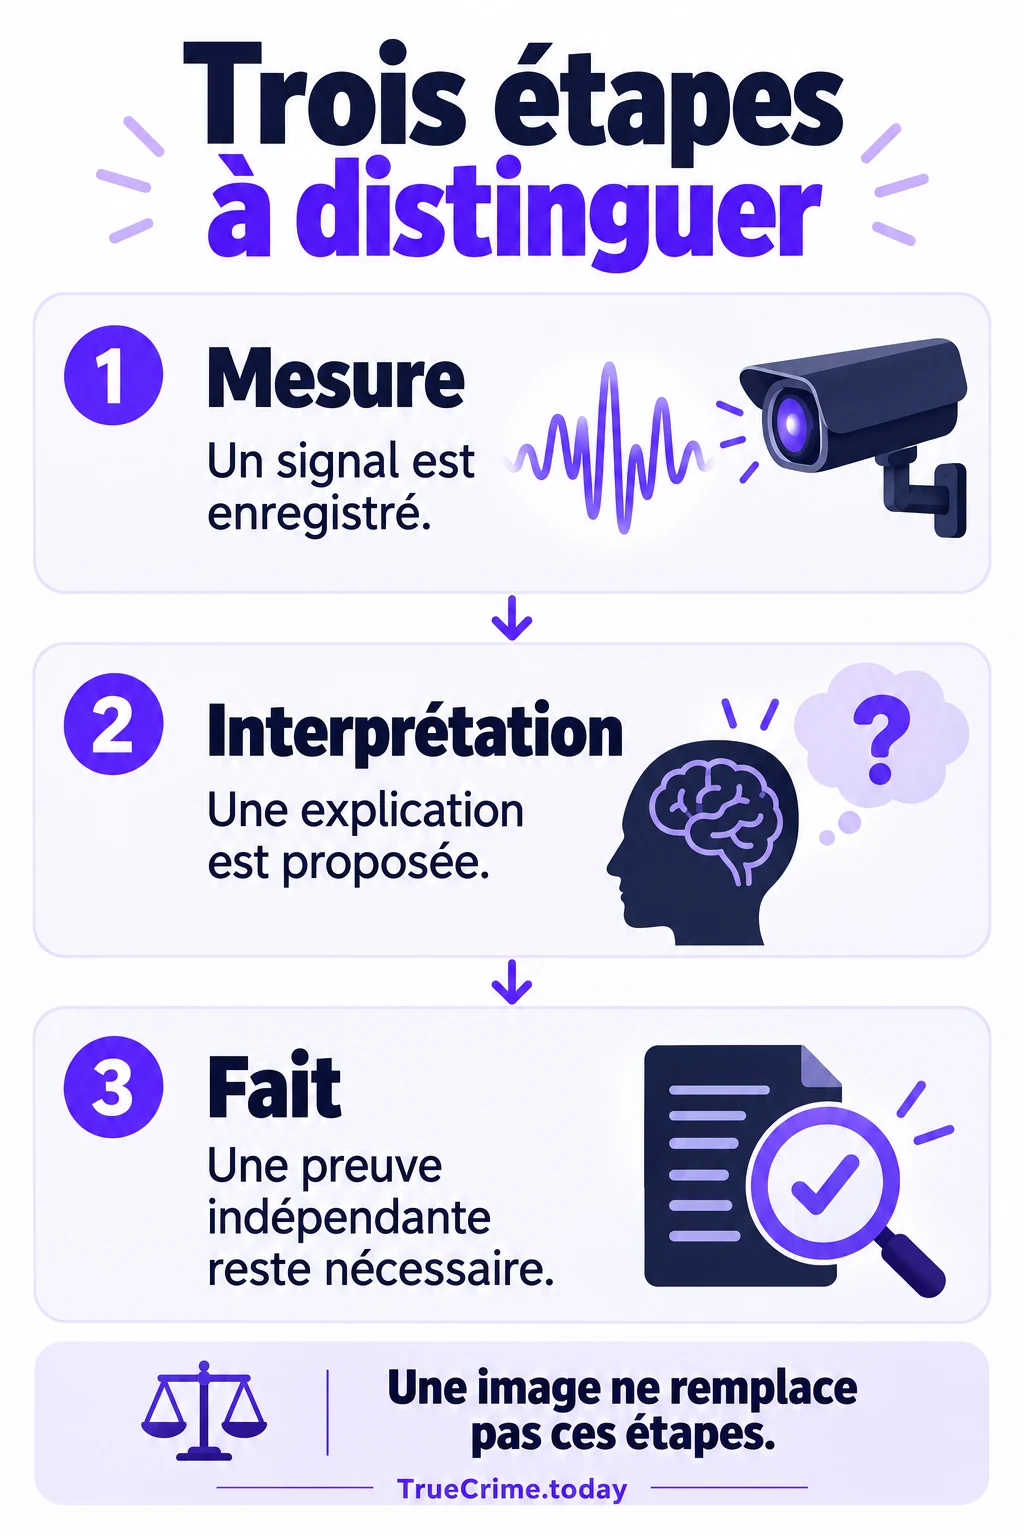
L’IA ajoute une classification. Elle peut exploiter du texte, une voix, une vidéo ou plusieurs enregistrements. Mais ses catégories dépendent d’exemples étiquetés à l’avance. Elle n’obtient pas une version certaine des événements en regardant plus longtemps.
Une question sur le souvenir ne prouve pas le geste
Le test de questions de comparaison, ou CQT, oppose des réactions à différentes catégories de questions. Le choix des questions et la règle de décision font partie de la méthode. Une pointe dans une courbe, isolée de ce dispositif, ne suffit pas à la résumer.
Le test d’information cachée, ou CIT, recherche plutôt une réaction différente à un élément potentiellement connu parmi plusieurs possibilités. La question se rapproche alors de « cette information est-elle reconnue ? ». Elle reste distincte de « cette personne a-t-elle commis l’acte ? ».
La méta-analyse P300 de Knappe et ses collègues, publiée en 2025 apporte des résultats favorables à cette recherche de reconnaissance. Leur portée dépend toutefois de la tâche et des conditions expérimentales, que nous allons préciser.
Dans l’analyse d’une affaire de true crime, cette distinction change la prochaine vérification à faire. Si quelqu’un connaît une disposition des lieux, il faut aussi chercher comment cette connaissance a pu être acquise. Le signal ne répond pas seul à cette seconde question.
Deux personnes peuvent réagir au même détail
Une personne impliquée et une personne ayant vu une photo peuvent toutes deux reconnaître un objet. Si la photo était publique, la reconnaissance ne distingue plus aussi bien ces deux explications.
Il faut donc savoir si l’information était réellement protégée, si elle a été évoquée pendant une audition et si les autres possibilités proposées étaient comparables. Un protocole peut perdre de son intérêt sans que l’appareil ait cessé de mesurer correctement.
L’absence de reconnaissance demande elle aussi de la prudence. Elle ne garantit pas que rien n’a été vécu ou appris. La mémoire, les stimuli et la règle de décision doivent être étudiés pour la conclusion recherchée.
La question devient plus précise : quelles explications ce résultat permet-il de départager ? C’est un objectif moins spectaculaire que lire une culpabilité dans le cerveau, mais bien plus facile à mettre à l’épreuve.
Le résultat encourageant sur 54 études
En 2025, Knappe, Ullsperger et Kirschner ont rassemblé 54 études expérimentales sur la P300 dans des tests d’information cachée. Ils rapportent une taille d’effet moyenne de 1,59. Ce nombre mesure une différence standardisée, pas une proportion de personnes correctement jugées.
Le type de tâche, le protocole et les tentatives de modification volontaire des réactions influençaient les résultats. Les auteurs défendent l’intérêt du protocole d’essai complexe. On ne peut donc pas attribuer leur résultat à n’importe quel enregistrement EEG.
Toutes les études incluses se déroulaient en laboratoire, souvent avec de jeunes adultes en bonne santé. Les auteurs demandent des évaluations dans des populations et des situations plus proches de la pratique forensique.
Cela laisse une conclusion positive, mais délimitée. Il existe un effet qui mérite d’être étudié. La précision individuelle d’une nouvelle application ne se déduit pas directement de cet effet, surtout si la population ou la tâche change.
Que reste-t-il des cent pour cent ?
Un travail de Langleben et ses collègues, en 2016, comparait polygraphe et IRM fonctionnelle chez 28 personnes dissimulant un nombre écrit entre trois et huit. Trois spécialistes de chaque méthode évaluaient les données sans connaître ce nombre.
Le rapport relatif de détections correctes favorisait les spécialistes de l’IRM d’un facteur de 1,24. Ce n’est pas un gain de 24 points de pourcentage. Le travail décrivait aussi un résultat combiné parfait pour un sous-groupe sélectionné de dix-sept personnes répondant à une condition d’accord.
La sélection doit rester dans la phrase qui annonce le résultat. Une réussite parfaite sur dix-sept cas retenus ne devient pas une réussite parfaite chez les vingt-huit participants. Il faut également savoir ce qu’il advient des autres.
Enfin, le nombre caché reste une tâche définie. Elle ne reproduit pas un récit libre sur une affaire. L’expérience peut être prometteuse sans établir une capacité générale à trancher toutes les déclarations.
Un verdict indécis change le calcul
Certains tests peuvent ne pas conclure. Ce n’est pas nécessairement un défaut : une réponse prudente peut être préférable à une étiquette forcée. Mais les cas écartés doivent rester visibles.
Dans une recherche russe de 2023, Uchaev et Apanovich ont étudié deux groupes distincts de quarante personnes. Pour la seconde tâche, une classification à partir du rythme cardiaque passait de 72,4% à 74,5% avec 9,2% de réponses laissées indéterminées.
Les unités étaient des réponses répétées, pas quatre-vingts affaires résolues. Le pourcentage obtenu après introduction d’une zone d’incertitude ne concerne plus exactement le même ensemble de décisions.
Avant de comparer deux chiffres, demande ce qui a été compté. Personnes, réponses, évaluations multiples d’un même enregistrement et sous-groupes choisis ne sont pas des unités interchangeables.
Les faux signaux deviennent nombreux quand la cible est rare
Voici notre propre calcul hypothétique, sans résultat mesuré d’un appareil. Sur 2 000 personnes, vingt connaissent un détail protégé. Supposons une sensibilité de 90% et une spécificité de 95%, avec une décision binaire pour tout le monde.
La sensibilité conduit à détecter dix-huit des vingt personnes qui savent et à en manquer deux. Parmi les 1 980 autres, cinq pour cent déclenchent une fausse alerte : 99. Les 1 881 restantes ne déclenchent, à juste titre, aucune alerte.
Au total, dix-huit des 117 alertes sont justes, soit environ 15,4%. De bons taux séparés ne garantissent donc pas que la plupart des alertes soient correctes. Leur proportion dépend aussi de la rareté de ce qu’on cherche.
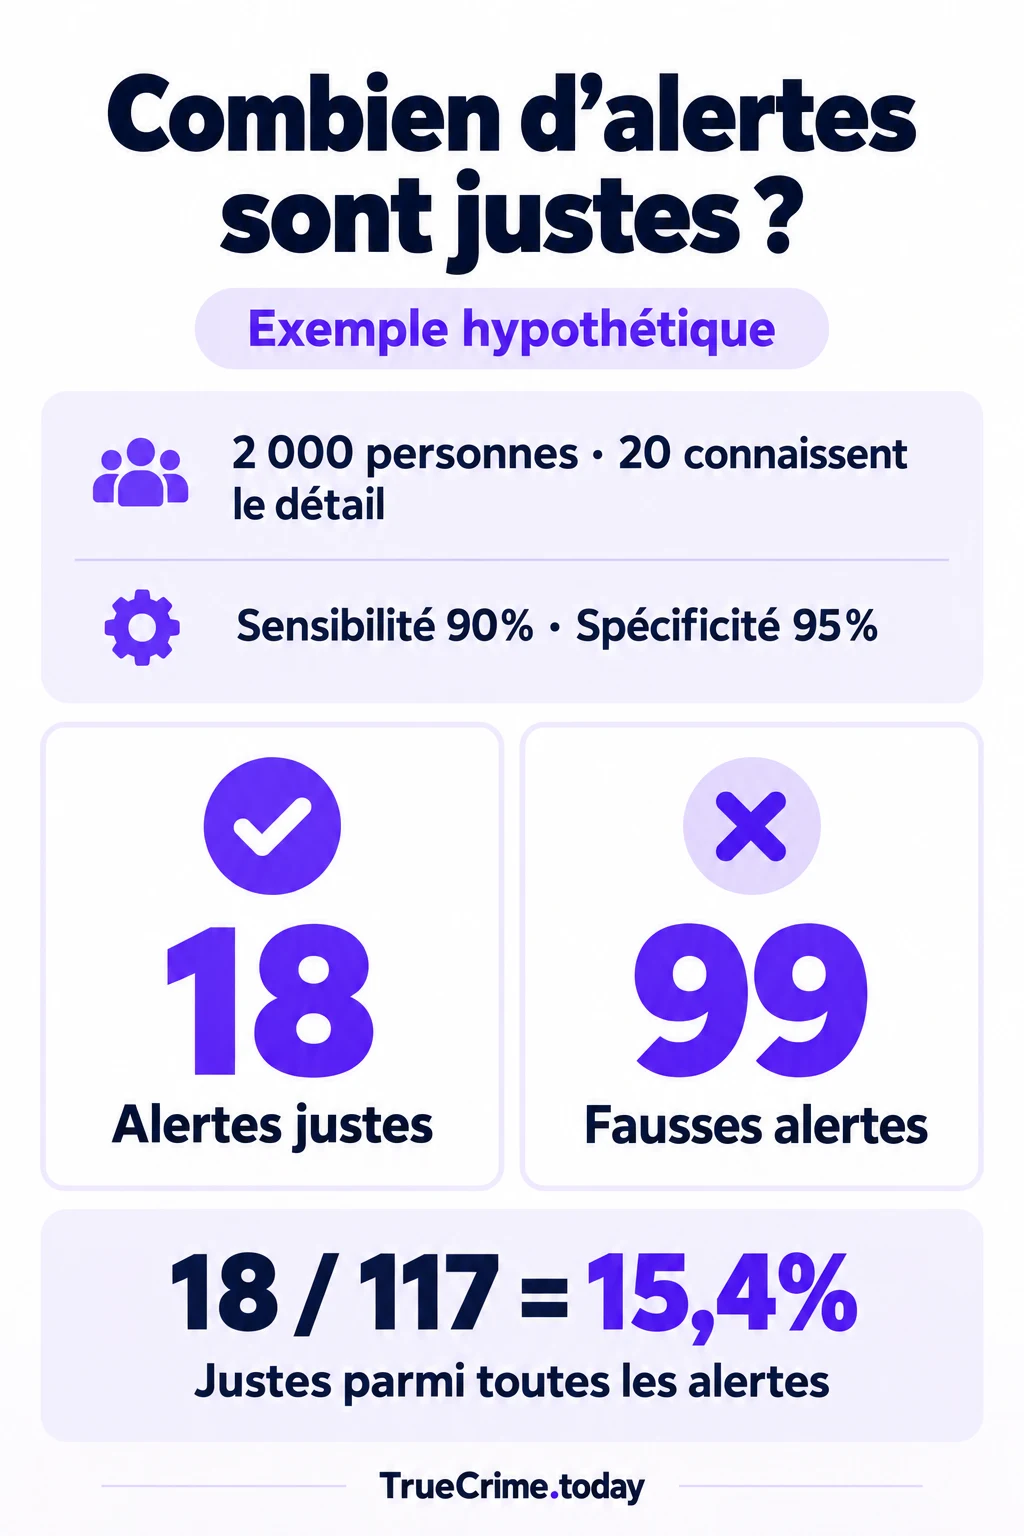
La connaissance n’est toujours pas la culpabilité. Et les résultats indécis d’une vraie procédure demanderaient leur propre décompte. Cet exemple explique une difficulté du dépistage de masse, pas la performance réelle d’un polygraphe.
Pourquoi les chercheurs se disputent encore sur le polygraphe
Le National Research Council estimait en 2003 que les tests sur des incidents particuliers pouvaient distinguer au-delà du hasard dans les populations étudiées, sans approcher la perfection. Il soulignait les limites d’un transfert au dépistage général.
La synthèse professionnelle de l’American Polygraph Association de 2011 rapporte environ 89% de précision des décisions et 11% de résultats indécis pour certaines techniques concernant un incident précis. Les deux chiffres doivent être conservés ensemble.
En 2021, Honts et ses collègues ont défendu une lecture favorable du CQT à partir de 138 ensembles de données. Iacono et Ben-Shakhar maintenaient, dans une analyse critique de 2019, des objections concernant les fondements et la qualité des données de terrain.
Ces désaccords demandent d’examiner les études, pas de choisir une moyenne entre opinions. Comment la vérité a-t-elle été établie ? Quels cas ont été retenus ? L’usage envisagé ressemble-t-il à l’expérience ? Voilà ce qui rend une comparaison informative.
L’IA peut expliquer une erreur avec aplomb
Une étude ACL de 2025 évaluait des modèles sur trois ensembles anglophones : des extraits judiciaires, des vidéos de tromperie imposée par consigne et des avis hôteliers. Une configuration de GPT-4o obtenait environ 79,6%, 55,1% et 71,9% de précision selon l’ensemble.
Ces écarts montrent l’importance de la tâche. Les chiffres ne promettent pas le même résultat avec un entretien en français. Une étiquette fondée sur l’issue d’une affaire ne vérifie d’ailleurs pas chaque phrase prononcée dans l’extrait.
Les explications générées n’amélioraient pas systématiquement les performances. Des hésitations et incertitudes présentes dans une parole vraie pouvaient être interprétées comme de la tromperie. Une justification détaillée n’est donc pas une confirmation indépendante.
Il faut aussi séparer les personnes entre développement et évaluation. Sinon, plusieurs extraits d’une même voix ou d’un même décor peuvent aider le modèle autrement qu’en distinguant le vrai du faux.
Le plan de la réserve était déjà connu
Prenons une fiction. Après un vol dans une réserve, un test suggère qu’une personne reconnaît l’emplacement d’un meuble. Le commentaire affirme que seule la personne qui a volé pouvait connaître cette disposition.
Un plan destiné à une livraison apparaît ensuite. Il avait été envoyé à cette personne avant les faits. Le résultat de reconnaissance peut être exact, tandis que l’explication accusatrice échoue.
La prochaine étape consiste à vérifier le document, ses destinataires et sa date. Répéter que la réaction était forte ne permet pas de distinguer les deux sources de connaissance.
Si le plan n’avait jamais circulé, le détail aurait pu être plus informatif. Il faudrait encore examiner accès, horaires et gestes. La force d’un indice dépend des explications qu’il élimine réellement, y compris celles qui écartent une suspicion.
Lire un résultat sans lui faire tout dire
Commence par le texte original du résultat et la question exacte. Cherche ensuite la référence indépendante utilisée pour décider ce qui était vrai. Une déclaration obtenue après le test ne doit pas devenir, sans examen, sa seule confirmation.
Garde les erreurs et les absences de décision. Vérifie les personnes évaluées, la tâche et les conditions d’un éventuel tri. Un bel écran ou un pourcentage isolé ne fournit pas ces informations.
Tu peux reconnaître un progrès expérimental sans accepter toutes les promesses commerciales qui s’y ajoutent. L’utilité pour faire parler, la précision scientifique et les conditions d’emploi sont des questions différentes.
Le résultat aide alors à poser une prochaine question vérifiable. Il n’a pas besoin de trancher tout un récit pour apporter quelque chose, mais il faut lui laisser la portée qu’il a réellement démontrée.
Tu peux poser une question sur un polygraphe, une expérience de reconnaissance ou une promesse de détection par IA. N’envoie pas de résultats privés, d’enregistrements, de passeports, de contrats, de coordonnées bancaires ni d’autres documents personnels.
Poser une question sur les détecteurs